
图形渲染与 Shader / 系统课时
做一次完整性能诊断
做一次完整性能诊断
单看一次 FPS 下降,很容易把“相关现象”误判成根因。本节用一次完整诊断把异常复现、基线采集、CPU/GPU 定位、原因验证、优化实施和回归测试串起来,最终得到的不只是一个更高的平均帧率,而是一条能够重复执行和证明优化有效的分析链路。
学习目标
- 按固定顺序完成一次游戏性能问题的定位与归因
- 用帧时间、CPU/GPU 利用率等证据区分瓶颈,而不是凭感觉判断
- 在优化后使用同场景、同条件数据完成回归验证
先固定问题和测试基线
假设测试现象是:角色进入一个高密度战斗区域后,画面会出现周期性卡顿。第一步不是立即改代码或调低画质,而是把测试条件固定下来,否则优化前后的数据没有可比性。
至少记录游戏版本、地图或关卡、角色路线、分辨率、画质预设、帧率上限、硬件配置和后台程序状态。测试路径也要固定,例如从同一个存档开始,移动到指定位置并持续战斗 60 秒。每轮测试最好重复数次,避免一次偶然波动决定结论。
基线不应只记录“平均 FPS”。平均值可能很好看,却掩盖几十毫秒甚至上百毫秒的长帧。更直接的观察对象是 Frame Time:60 FPS 对应的理想单帧时间约为 16.7 ms,突然出现 30 ms、50 ms 的帧,即使平均 FPS 变化不大,也会让玩家感到卡顿。
用数据确定瓶颈方向
采集基线时,把帧时间和 CPU、GPU 状态放到同一时间轴观察。这里关注的是相关关系,而不是单个利用率数字。
| 现象 | 更值得优先检查的方向 |
|---|---|
| GPU 长时间接近满负载,同时降低分辨率后帧时间明显下降 | GPU 渲染瓶颈 |
| GPU 利用率不高,但某个 CPU 主线程持续占满一个核心 | CPU 主线程瓶颈 |
| 平均负载不高,却周期性出现很长的单帧 | 资源加载、着色器编译、GC、同步等待等尖峰 |
| CPU 与 GPU 都出现空闲,但帧率被固定在稳定值 | 帧率上限、垂直同步或等待机制 |
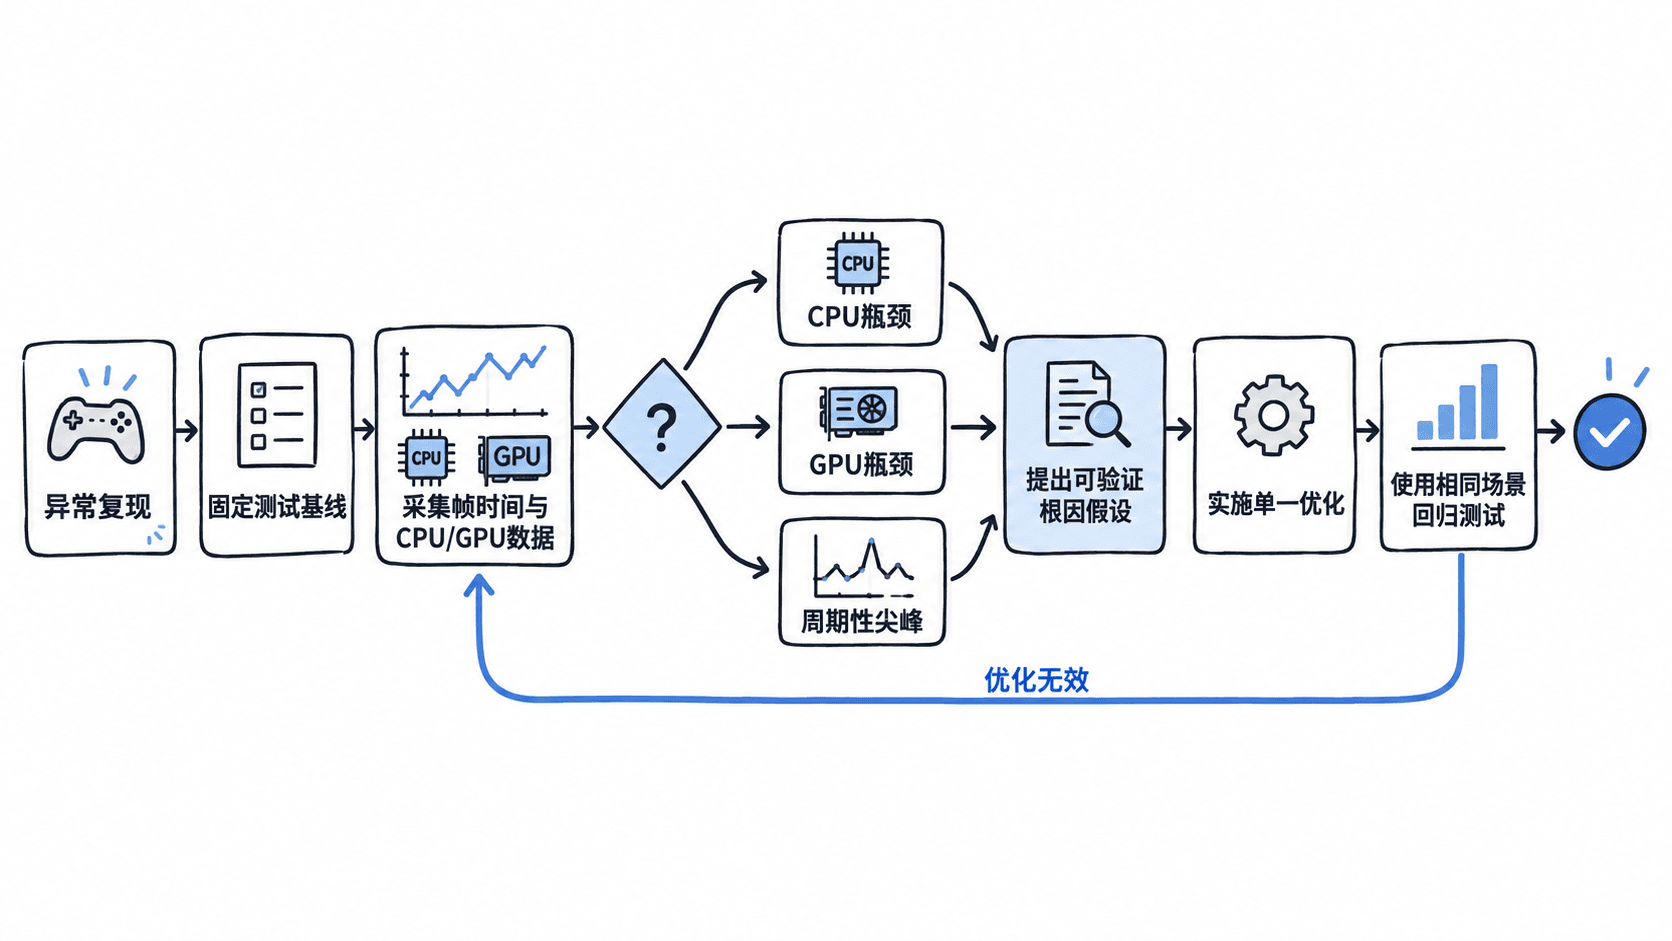
这一步最重要的原则是:先确认瓶颈属于哪一侧,再进入具体函数或渲染阶段。 如果 GPU 已经持续满载,继续优化一个只占 0.2 ms 的 CPU 函数通常不会改变最终帧时间;反过来也一样。
把相关现象变成可验证的根因
定位工具告诉你“哪里耗时”,但真正的归因还需要实验。例如在卡顿帧附近发现资源加载耗时上升,可以提出假设:战斗区域首次生成特效时发生同步资源加载,阻塞主线程。
接下来只改变一个关键因素进行验证:提前预加载同一批资源,再重复完全相同的测试路线。如果长帧显著减少,而其他设置没有改变,这个结果才支持该假设。若没有改善,就回到采集数据阶段继续定位,而不是不断叠加未经验证的优化。
对于 GPU 问题也可以采用同样思路。例如怀疑阴影阶段过重,可以临时降低阴影分辨率进行诊断。如果 GPU Frame Time 明显下降,就说明该阶段值得继续分析;这并不代表最终方案一定是“降低画质”,真正优化还可能是减少投影对象、缩小阴影覆盖范围或降低无效绘制。
用帧时间验证优化效果
完成优化后,要回到最初的基线场景进行回归,而不是换一个更轻的场景观察 FPS。下面的 Python 示例使用一组固定帧时间数据,对比优化前后的平均帧时间、近似 P95 帧时间和明显长帧数量。示例只使用 Python 标准库,可以直接运行。
import statistics

baseline = [
    16.7, 16.9, 17.1, 28.0, 17.0, 16.8, 35.0, 17.2, 16.9, 17.0,
    31.0, 16.8, 17.1, 16.9, 17.0, 29.0, 16.8, 17.2, 16.9, 17.0,
]
optimized = [
    16.7, 16.8, 16.9, 18.0, 16.9, 16.8, 19.0, 17.0, 16.9, 16.8,
    18.5, 16.9, 17.0, 16.8, 16.9, 18.2, 16.8, 17.0, 16.9, 16.8,
]

def summarize(name, samples):
    ordered = sorted(samples)
    mean_ms = statistics.mean(samples)
    median_ms = statistics.median(samples)
    # 用固定索引近似观察高位帧时间,真实项目应使用完整采样数据。
    p95_ms = ordered[int(0.95 * (len(ordered) - 1))]
    stutter_threshold = median_ms * 1.5
    stutters = sum(value > stutter_threshold for value in samples)

    print(
        f"{name}: avg={mean_ms:.2f} ms, "
        f"fps={1000 / mean_ms:.2f}, p95={p95_ms:.1f} ms, "
        f"stutters={stutters}"
    )

summarize("baseline", baseline)
summarize("optimized", optimized)
预期输出:
baseline: avg=19.71 ms, fps=50.72, p95=31.0 ms, stutters=4
optimized: avg=17.18 ms, fps=58.21, p95=18.5 ms, stutters=0
这里比“平均 FPS 从 50 提升到 58”更重要的是 P95 帧时间从 31.0 ms 降到 18.5 ms,并且明显长帧从 4 次降到 0 次。这说明优化不仅提高吞吐量,也改善了帧时间稳定性。真实项目应使用更长时间、更大量的采样,并同时保留硬件计数器和性能分析器结果。
完成回归而不是看到提升就停止
一次优化通过原场景验证后,还要检查它是否把成本转移到了别处。例如把资源全部提前加载可能消除了战斗中的卡顿,却显著增加启动时间和内存峰值;减少阴影绘制可能提高 GPU 性能,却产生明显的视觉退化。
最终验收至少要重新确认三件事:原始异常场景是否改善,其他代表性场景是否出现性能回退,功能与画质是否仍满足要求。把优化前后的测试条件、关键指标、根因证据和改动内容一起保存,下一次性能退化时就能直接与这份基线比较。
完整性能诊断的核心不是“找到一个耗时最高的函数”,而是建立从现象到证据、从证据到假设、从假设到实验、再从优化回到同条件验证的闭环。只要测试条件固定、每个结论都有数据支持,即使第一次假设错误,也能沿着流程继续缩小范围,而不会陷入凭经验反复试参数的状态。