
图形渲染与 Shader / 系统课时
定位脚本与系统调用热点
定位脚本与系统调用热点
CPU 帧时间异常时,顶层函数很慢并不意味着计算本身很重。高频脚本调用、互斥锁等待、频繁分配以及文件或网络系统调用,都可能把时间隐藏在调用链下层。本节建立一套从时间线缩小范围、再用样本聚合确认根因的排查方法。
学习目标
- 从时间线和调用栈识别脚本、锁、分配和系统调用热点
- 区分函数执行时间与等待时间,避免只看函数名称下结论
- 根据热点类型选择对应修复方式并验证帧时间变化
先从异常时间段缩小范围
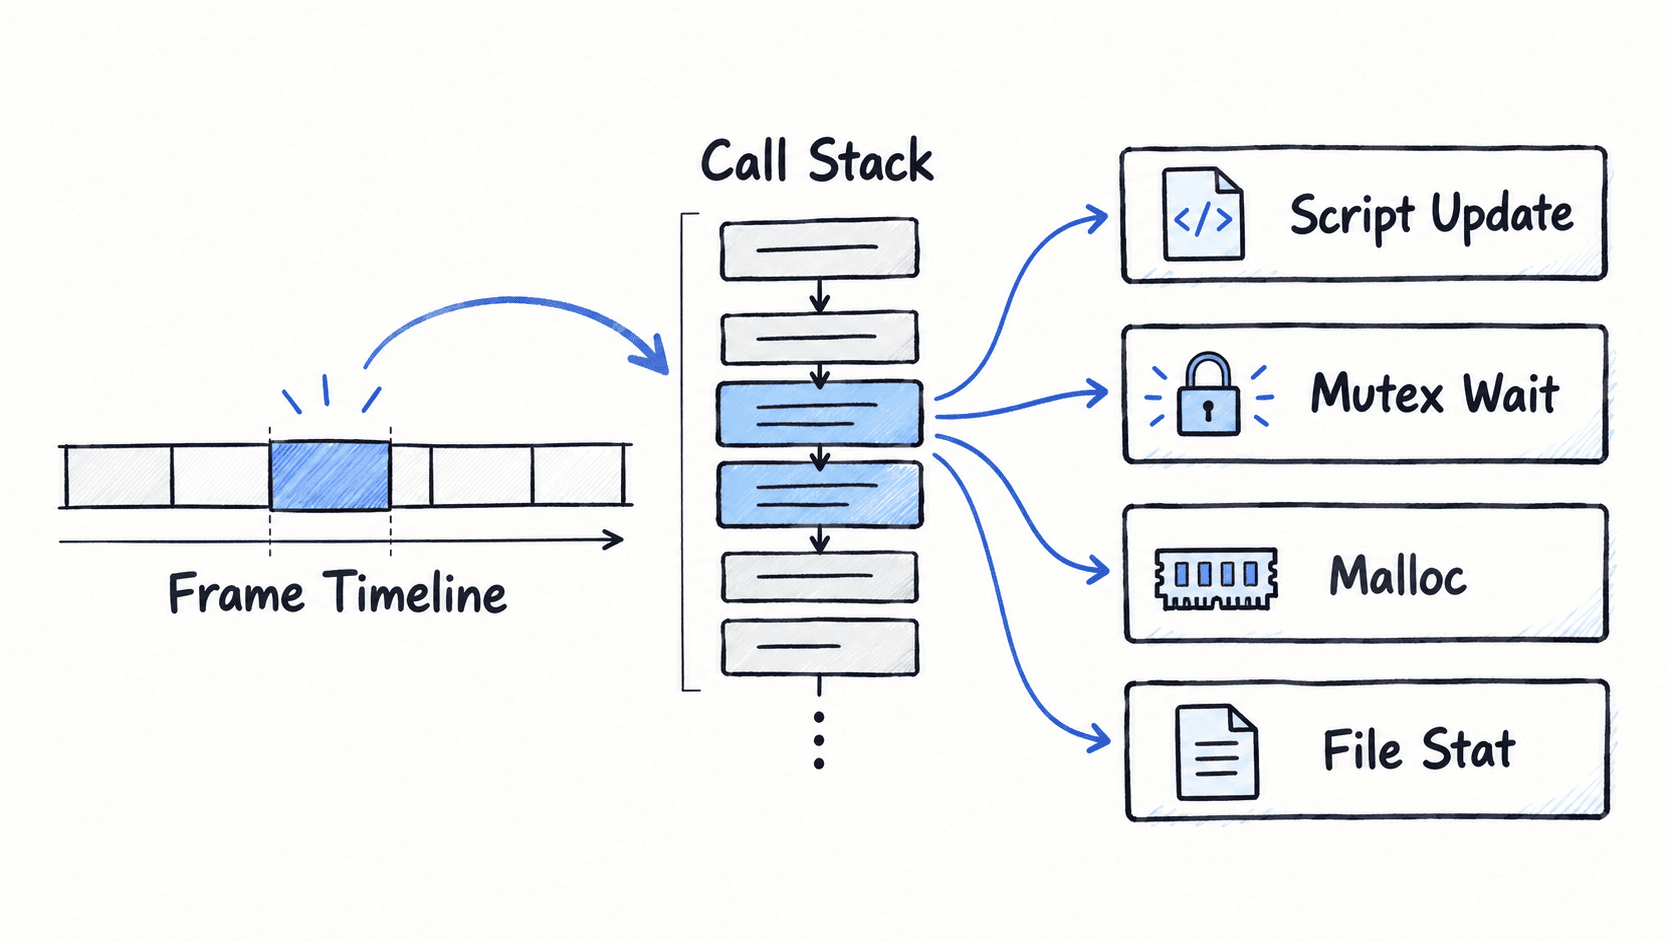
不要一开始就在完整调用树里搜索最耗时函数。先找到帧时间明显升高的帧,再定位其中持续时间异常的 CPU 区段。展开调用栈时重点判断时间最终落到了脚本执行、等待、内存管理还是操作系统边界。
如果某个脚本函数单次只有几十微秒,但一帧调用几千次,累计成本同样可能很高;相反,一个显示为 4 ms 的函数可能大部分时间都在等待锁。定位时必须同时看调用次数、包含子调用的总时间以及线程状态。
用样本聚合确认热点类型
真实 Profiler 往往可以按函数、类别或 Marker 聚合。下面的脚本使用一组固定采样数据演示同样的思路:先按热点类别累计 CPU 时间,再找出累计时间最高的具体调用。把真实工具导出的采样结果整理成相同字段后,可以复用这种分析方式。
from collections import defaultdict

samples = [
    ("Script.UpdateNPC", "script", 3.2),
    ("Script.UpdateNPC", "script", 2.8),
    ("Mutex.Wait", "lock", 2.5),
    ("Allocator.Malloc", "alloc", 1.6),
    ("os.stat", "syscall", 1.4),
    ("os.stat", "syscall", 1.2),
    ("Renderer.Submit", "other", 2.0),
]

by_category = defaultdict(float)
by_name = defaultdict(float)

for name, category, cost_ms in samples:
    by_category[category] += cost_ms
    by_name[name] += cost_ms

print("category totals:")
for category, cost in sorted(by_category.items(), key=lambda item: (-item[1], item[0])):
    print(f"{category}: {cost:.1f}ms")

print("top calls:")
for name, cost in sorted(by_name.items(), key=lambda item: (-item[1], item[0]))[:3]:
    print(f"{name}: {cost:.1f}ms")
预期输出
category totals:
script: 6.0ms
syscall: 2.6ms
lock: 2.5ms
other: 2.0ms
alloc: 1.6ms
top calls:
Script.UpdateNPC: 6.0ms
os.stat: 2.6ms
Mutex.Wait: 2.5ms
这组数据里脚本累计时间最高,但系统调用和锁等待也已经足以影响一帧。实际分析不能只优化排名第一的函数,还要确认各热点是否位于关键路径,以及它们是否在同一帧重复出现。
四类热点分别看什么证据
| 热点类型 | 时间线或调用栈中的典型证据 | 优先确认的问题 |
|---|---|---|
| 高频脚本 | 同一脚本节点大量重复出现,累计时间高 | 是否能批处理、降低更新频率或提前过滤对象 |
| 锁竞争 | Wait、互斥量或阻塞区段占用明显时间 |
哪个线程持锁、临界区是否过大、是否存在高频共享写入 |
| 内存分配 | 分配器调用密集,可能伴随垃圾回收或释放 | 是否每帧创建临时对象、容器是否反复扩容 |
| 系统调用 | 文件、网络、线程同步等调用频繁跨入内核 | 是否把可缓存或可异步的工作放进了帧循环 |
脚本热点尤其容易被“单次耗时很小”掩盖,因此调用次数必须与总耗时一起看。锁竞争则正好相反:线程可能没有执行大量指令,却因为等待另一个线程而占据关键路径,所以不能把阻塞时间误认为普通计算成本。
修复必须对应根因
高频脚本调用可以从降低调用频率、合并遍历和批处理入手。例如远距离 NPC 没必要与近距离 NPC 使用相同更新频率。锁竞争则应缩短临界区、减少共享可写状态,必要时重新划分数据所有权,而不是简单增加线程。
频繁分配通常适合通过对象复用、预分配容器容量以及减少临时集合来处理。系统调用热点则应优先检查是否在每帧重复读取文件属性、访问磁盘或进行同步网络操作;能缓存的结果应缓存,必须执行的 I/O 尽量移出关键帧路径。
用同一场景验证修复
修复后应重新采集相同场景,保持角色数量、脚本负载和采样范围尽量一致。对比目标热点的累计时间与调用次数,同时检查 CPU 帧时间是否下降。如果某个脚本从 6 ms 降到 2 ms,但帧时间几乎没变,说明关键路径上可能还有其他等待或串行瓶颈。
最终需要得到的是一条可解释的证据链:异常帧出现在时间线上,调用栈显示时间落入具体类别,聚合数据确认它持续占用关键路径,修改后同类采样显著下降且帧时间同步改善。这样才能把“看起来很慢”变成可以验证的性能结论。