
图形渲染与 Shader / 系统课时
透明和粒子为何难优化
透明和粒子为何难优化
透明物体和粒子常常不是“面数太多”这么简单,而是同时触发排序、重复覆盖同一像素、复杂透明材质和大量粒子更新。排查时要把 CPU 提交成本与 GPU 像素成本拆开看,才能知道该减粒子数量、缩小屏幕覆盖,还是简化材质与混合方式。
学习目标
- 判断透明渲染中排序、过度绘制和材质复杂度分别消耗什么
- 用覆盖面积与叠加层数估算透明像素成本
- 按定位结果选择减少粒子、缩小覆盖或简化材质
透明渲染为什么容易变贵
不透明物体通常可以依靠深度测试尽早丢弃被遮挡片元,而常见透明混合必须读取背景颜色,再与当前片元混合。一个像素如果被烟雾、光晕、玻璃和 UI 特效连续覆盖多次,GPU 就会多次执行片元着色和混合。
透明对象还经常需要按距离从远到近排序。对象数量很大时,CPU 会增加排序和提交工作;粒子系统如果生成大量独立批次,还可能让 Draw Call 和状态切换一起上升。因此先看 CPU 还是 GPU 忙,再继续拆成本。
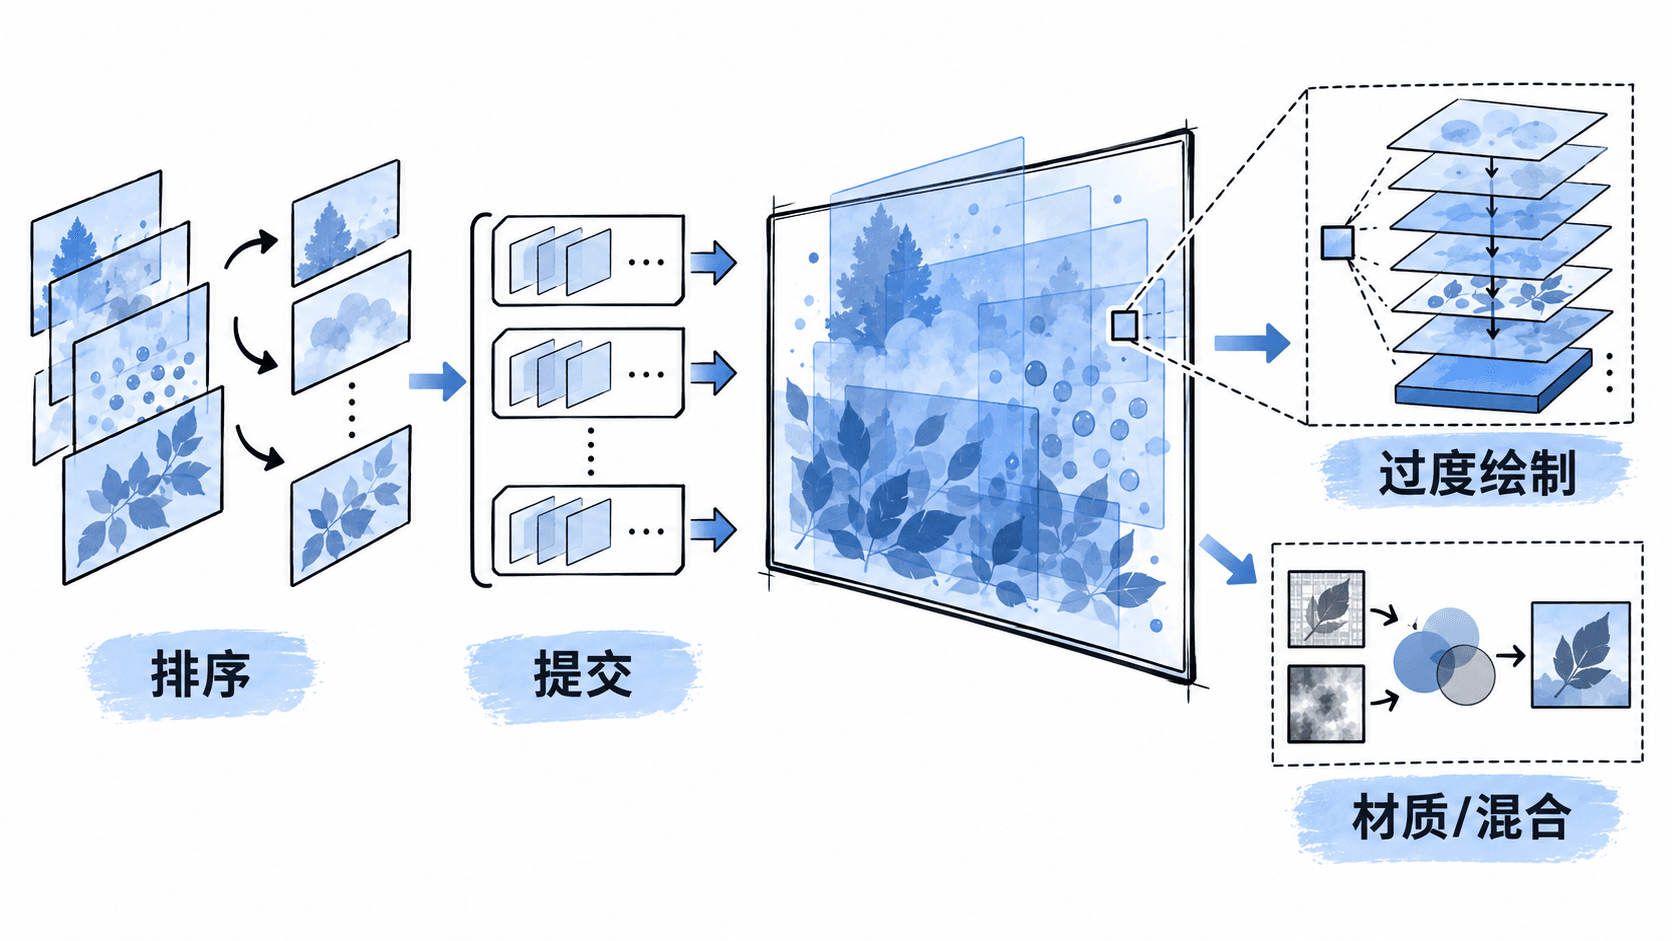
用覆盖面积和叠加层数估算热点
透明成本更接近“处理了多少片元”,而不是“有多少三角形”。同样是 1000 个粒子,集中在屏幕中央并互相重叠,通常比散布在整个场景且彼此少重叠更贵。可以先用一个粗略模型判断问题是否值得优先处理。
下面的 Python 示例按屏幕分辨率、透明覆盖比例和平均叠加层数估算每帧透明片元数。它不是 GPU Profiler 的替代品,只用于建立量级直觉。
width = 2560
height = 1440
coverage = 0.40
average_layers = 6

screen_pixels = width * height
transparent_fragments = int(screen_pixels * coverage * average_layers)

print(f"screen pixels: {screen_pixels}")
print(f"transparent fragments/frame: {transparent_fragments}")
预期输出:
screen pixels: 3686400
transparent fragments/frame: 8847360
这里约 369 万屏幕像素,因为 40% 区域平均被透明内容覆盖 6 层,透明片元处理量已经接近 885 万。若材质还包含多张纹理、噪声、软粒子深度采样或高成本数学运算,单个片元的代价还会继续放大。
排序、材质和粒子数量怎么区分
如果 CPU 帧时间随着透明对象数量明显上升,而 GPU 压力变化不大,应优先检查排序、批次和提交。大量独立透明 Renderer、频繁材质切换和粒子系统拆成很多小批次,都可能把成本推到 CPU 侧。
如果 GPU 帧时间随镜头靠近烟雾、爆炸或全屏光效急剧上升,通常更像填充率或过度绘制问题。此时减少粒子出生率未必是最有效的办法,因为少量超大粒子也可能覆盖大半屏幕。
材质复杂度则可通过替换法验证:保持粒子数量和尺寸不变,把透明材质临时替换为最简单的单纹理混合材质。如果 GPU 时间明显下降,主要矛盾就在 Shader、纹理采样、软粒子或混合路径,而不是粒子数量本身。
优化时优先动哪一项
先处理屏幕覆盖和叠加层数,通常收益最大。缩小粒子尺寸、减少长时间残留、避免多个全屏透明层互相叠加,比只盯着三角形数量更直接。对远处或次要特效,可以降低出生率、缩短生命周期或使用更低分辨率的替代效果。
随后再处理批次和材质。尽量复用材质、减少透明材质变体,并避免同一特效同时使用多个高成本采样。对于确实需要排序的透明对象,不要为了“零排序成本”贸然取消排序,否则可能得到错误的混合结果。
当透明场景出现明显热点时,最有价值的三个指标是透明内容覆盖了多少屏幕、同一像素平均被覆盖多少次、每个透明片元执行了多复杂的材质计算。把这三项与 CPU 排序和批次数据一起看,通常就能判断真正该减什么。