
图形渲染与 Shader / 系统课时
CPU 时间线该看哪些列
CPU 时间线该看哪些列
CPU 时间线不是一条“哪个函数最慢”的排行榜。真正有价值的是把线程、运行时间、采样调用栈和上下文切换放到同一条时间轴上观察,从而判断 CPU 时间究竟花在执行代码、等待调度,还是线程之间频繁切换上。掌握这些字段后,才能正确解释一次尖峰。
学习目标
- 理解线程、调用栈、采样周期和上下文切换各自代表什么
- 能从 CPU 时间线区分持续计算、调度等待与短时尖峰
- 避免把采样次数直接等同于函数真实耗时
先确定线程和时间范围
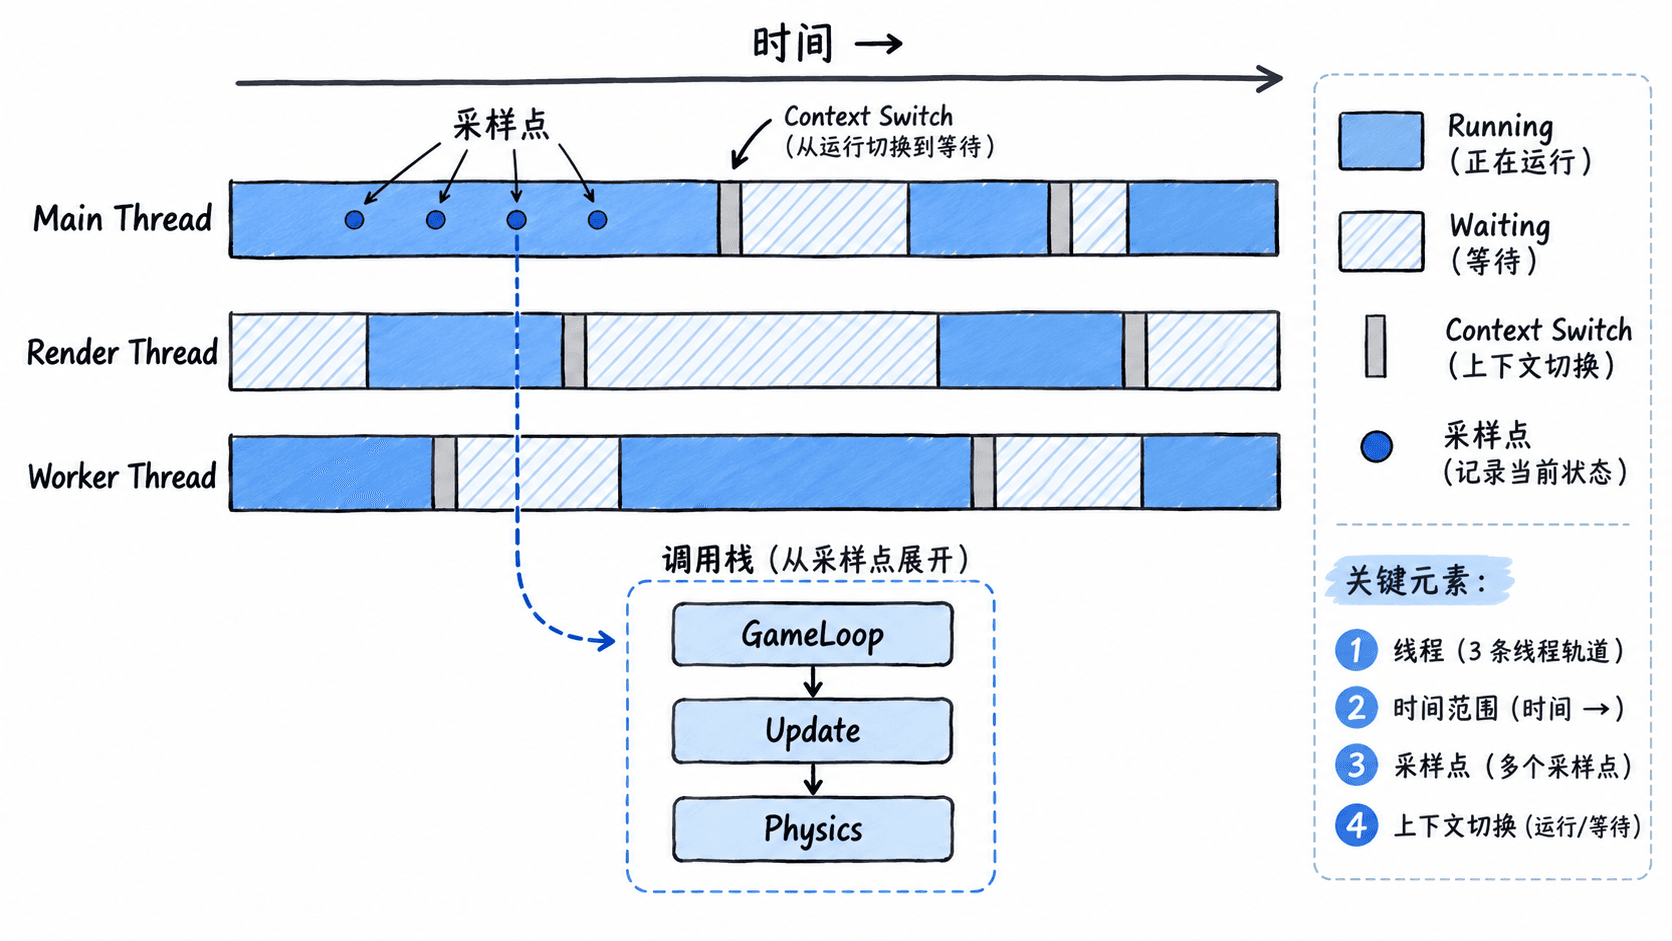
查看 CPU 时间线时,第一步不是展开最深的调用栈,而是确认问题发生在哪个线程、持续了多久。游戏常见的主线程、渲染线程、资源加载线程和工作线程承担的职责不同,同一个函数出现在不同线程上,性能含义也可能完全不同。
如果一次掉帧只持续几毫秒,应先框选对应时间窗口,再观察窗口内哪些线程处于运行状态。若整个区间只有主线程持续执行,而其他工作线程大量空闲,说明进一步分析主线程更有价值;如果多个工作线程同时活跃,则要考虑并行任务是否造成竞争或同步等待。
调用栈告诉你采样时正在执行什么
采样型 CPU Profiler 会按照一定频率暂停或观察目标线程,记录当时的调用栈。多次采样都落在同一段调用路径上,通常意味着该路径占用了较多 CPU 时间,但它本质上仍然是统计结果,而不是每次函数调用的精确计时。
例如采样栈多次出现 GameLoop → Update → Physics,可以说明采样窗口内线程经常执行到物理更新路径。真正分析时应同时查看父调用和子调用:父节点累计时间高,可能只是因为大量工作都经过它;更值得继续追踪的是占用明显集中的子路径。
采样周期决定能看到多细
采样周期越短,理论上越容易捕获短函数和瞬时尖峰,但采样数据量与工具开销也会增加。周期较长时,一段只运行几十微秒的函数可能一次都没有被采到,因此“样本数为零”不能证明它从未执行。
假设观察窗口为 20 毫秒,而采样器每 1 毫秒记录一次,那么最多只能获得大约几十个离散观察点。此时连续获得 8 个相似调用栈可以作为明显信号,但不能简单解释成“这个函数精确运行了 8 毫秒”。采样数据更适合比较时间分布和热点趋势。
上下文切换揭示线程为什么没在运行
线程没有出现在 CPU 上,并不等于线程已经完成工作。操作系统可能因为时间片结束、锁等待、事件等待或更高优先级线程就绪而将它切出 CPU。时间线上记录的上下文切换可以帮助区分“代码执行慢”和“线程长时间拿不到 CPU”这两类完全不同的问题。
如果主线程执行片段很短,却不断在运行与等待之间切换,应继续检查同步对象、任务依赖或调度竞争。如果主线程几乎连续占用一个核心并且调用栈集中在少数计算路径,则更像是真正的 CPU 计算瓶颈。
频繁切换本身也不一定异常。拥有多个正常工作线程的游戏天然会发生调度,判断重点应放在掉帧窗口内是否突然出现比正常帧更多的切换,以及关键线程是否因此失去连续执行时间。
把几列数据连起来看
分析一次 CPU 尖峰时,可以先框定异常帧对应的时间窗口,再找到承担主要 CPU 时间的线程,然后查看该线程在窗口内是连续运行还是反复被切换出去。只有确认线程确实在执行代码后,再展开采样调用栈寻找时间集中路径。
如果调用栈热点明显,但线程实际运行时间并不长,应优先怀疑调度或等待;如果线程持续运行并且样本集中在同一子调用路径,才适合继续进入函数级优化。时间线真正提供的价值,是把“谁在运行、运行多久、当时执行什么、为什么停下来”组合成一条完整证据链。