
图形渲染与 Shader / 系统课时
硬件计数器能回答什么
硬件计数器能回答什么
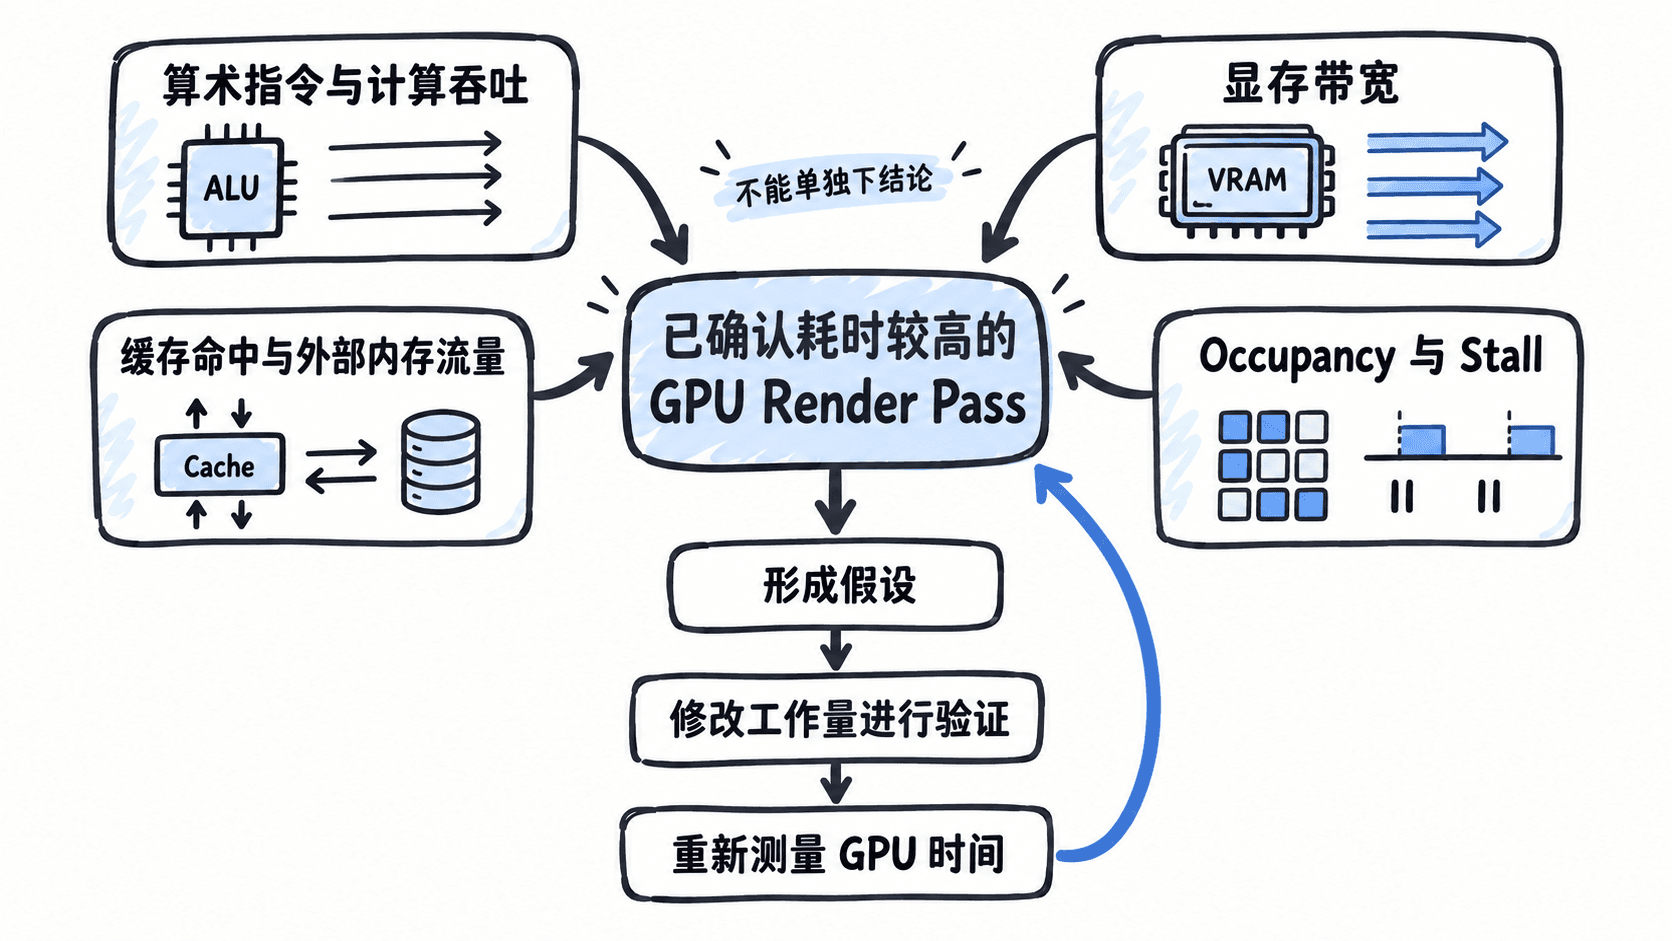
硬件计数器能告诉你 GPU 在执行时“资源被怎样使用”,例如算术指令是否繁重、显存带宽是否接近上限、缓存命中是否理想、执行单元是否有足够并行任务。但单个计数器通常不能直接给出根因,正确方法是把多个指标与具体 Pass、Shader 和工作量放在一起解释。
学习目标
- 理解指令、带宽、缓存和占用率等计数器分别能回答什么
- 根据一组相互关联的指标建立性能假设
- 识别硬件计数器最常见的误读方式
计数器回答的是执行特征
GPU Profiler 的时间数据首先回答“哪里慢”,硬件计数器进一步帮助回答“为什么这个位置可能慢”。例如已经确认某个后处理 Pass 占用 5 ms,接下来才值得观察它的算术吞吐、纹理访问、缓存和显存流量。
常见计数器大致可以分为几类。实际名称和计算方式由 GPU 架构及分析工具决定,因此分析时应优先阅读所用工具对指标的定义,而不要把不同厂商中名字相似的指标直接等同。
| 指标类别 | 主要能回答的问题 | 不能单独证明的结论 |
|---|---|---|
| 指令与算术吞吐 | Shader 是否执行了大量计算 | 计算多就一定是瓶颈 |
| 显存带宽 | 外部内存读写压力是否很高 | 带宽利用率高就一定需要降分辨率 |
| 缓存命中 | 数据是否较好地被缓存复用 | 命中率低就是性能根因 |
| Occupancy / 活跃线程 | 是否有足够并行工作驻留执行 | Occupancy 越高性能一定越好 |
| Stall 类指标 | 执行单元主要在等待什么资源 | 某类 Stall 高就是唯一根因 |
这些指标的共同特点是:它们描述硬件正在发生什么,却通常不会自动告诉你应该修改哪一行 Shader 或哪个渲染设置。
指令和带宽要结合工作量判断
假设一个全屏后处理 Pass 在 4K 分辨率下显存流量很高,同时 GPU 时间随分辨率明显上升,那么“像素工作量和内存流量有关”就是合理假设。此时可以通过降低内部渲染分辨率、减少采样数量或减少中间 Render Target 写入进行验证。
但如果带宽利用率只有中等水平,而算术吞吐已经非常高,继续压缩纹理尺寸可能几乎没有收益。反过来,如果 Shader 指令不多,但每个像素读取多个高分辨率纹理并写入多个 Render Target,就更应该关注内存流量而不是指令数。
缓存指标必须联系访问模式
缓存命中率看起来直观,却很容易被孤立解读。较低的命中率可能来自随机访问、大范围纹理采样、数据布局不连续,也可能只是因为当前工作集天然无法高复用。
真正值得关注的是命中率变化是否与耗时、显存流量和访问模式同时变化。例如某次 Shader 修改后,缓存命中下降、外部内存流量明显增加,而且同一 Pass 的 GPU 时间也上升,这组证据比“命中率只有 60%”更有解释力。
同样,两个不同 Pass 的缓存命中率不能简单横向比较。一个小型查表 Shader 和一个全屏纹理重采样 Shader 的工作模式不同,即使计数器数字相同,也不代表它们有相同的优化空间。
Occupancy 不是越高越好
Occupancy 通常描述硬件能够同时驻留多少活跃线程或 Wave。它会受到寄存器占用、共享内存、线程组规模和硬件资源限制影响。Occupancy 太低时,GPU 可能缺少足够并行工作去隐藏访存延迟,但把它强行提高到最大值也不保证更快。
例如减少寄存器使用后,Occupancy 从较低水平提升,但如果同时增加了额外指令或内存访问,最终 GPU 时间仍可能恶化。因此应把 Occupancy 看作解释延迟隐藏能力的一个线索,而不是优化目标本身。
用指标组合而不是单项阈值下结论
更可靠的判断来自指标之间的组合关系。例如“GPU 时间高 + 外部内存流量高 + 带宽接近平台可用上限 + 降低分辨率后耗时明显下降”共同支持带宽或像素工作量相关的判断。单独看到“带宽利用率 90%”则不够,因为工具统计口径和硬件理论峰值都可能影响这个数字。
同理,“GPU 时间高 + 算术吞吐高 + 修改 Shader 减少计算后耗时下降”比单独观察某个指令计数更有说服力。缓存、Occupancy 和 Stall 也应采用相同方法:先定位热点,再看相关指标,提出可验证假设,通过改变一个主要变量观察时间是否随之变化。
硬件计数器最终承担的是解释和验证角色。它们非常适合缩小根因范围,却不适合被当作统一的好坏分数。只要始终把计数器放回具体 Pass、工作量、GPU 时间和目标硬件中解读,就能避免“一个数字决定结论”的常见误区。