
图形渲染与 Shader / 系统课时
后处理成本怎么拆
后处理成本怎么拆
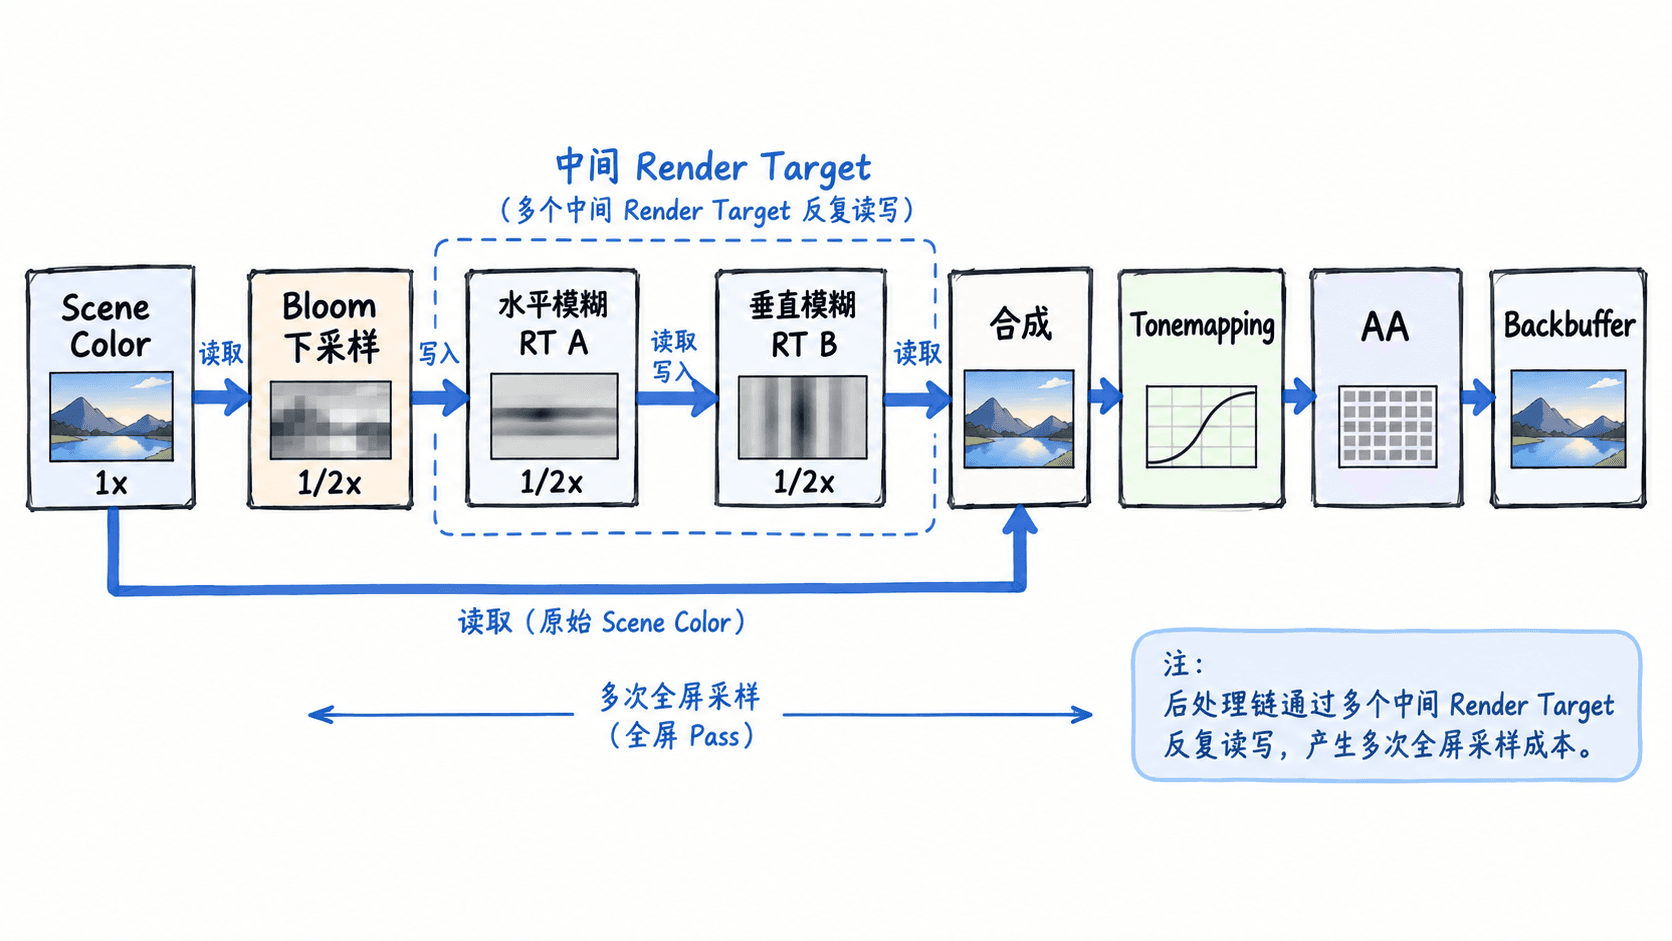
后处理不是一个统一的“滤镜成本”,而是一串按顺序读写图像的阶段。Bloom、景深、色调映射、抗锯齿等效果会产生不同分辨率的中间 Render Target,并执行多次采样与写回。优化时要把每个阶段单独计时,避免只看到一个总耗时却不知道该关哪一项。
学习目标
- 把后处理链拆成独立阶段并识别主要读写路径
- 理解分辨率、纹理采样次数和中间 Render Target 对成本的影响
- 用逐项关闭和分辨率缩放验证真正的 GPU 热点
后处理链真正消耗什么
一个典型后处理阶段会读取上一张颜色纹理,执行若干次纹理采样和计算,再写入新的 Render Target。阶段越多,中间纹理越多,显存带宽、缓存压力和全屏片元执行次数就越高。
分辨率是最直接的放大器。2560×1440 的全屏 Pass 约处理 369 万像素,3840×2160 则约 829 万像素。若一个效果内部有下采样、水平模糊、垂直模糊和合成四个 Pass,就不能只按“一个效果”估算。
用像素读写量做第一轮估算
不同 GPU 对缓存、压缩和纹理格式的处理不同,所以不能只靠理论值判断最终耗时。但在没有完整抓帧前,用“像素数 × 采样次数 × Pass 数”能快速发现明显不合理的阶段。
下面的 Python 示例估算三个后处理阶段每帧发生的纹理采样次数。scale 表示相对主分辨率的宽高缩放比例,像素数量因此按平方变化。
width = 2560
height = 1440

passes = [
    {"name": "Bloom Blur", "scale": 0.5, "samples": 9, "count": 2},
    {"name": "Tonemapping", "scale": 1.0, "samples": 2, "count": 1},
    {"name": "TAA Resolve", "scale": 1.0, "samples": 5, "count": 1},
]

for p in passes:
    pixels = width * height * (p["scale"] ** 2)
    samples = int(pixels * p["samples"] * p["count"])
    print(f'{p["name"]}: {samples} texture samples/frame')
预期输出:
Bloom Blur: 16588800 texture samples/frame
Tonemapping: 7372800 texture samples/frame
TAA Resolve: 18432000 texture samples/frame
即使 Bloom 在半分辨率运行,两次 9-tap 模糊仍然会产生约 1660 万次采样。这个估算没有计算写回、缓存命中和 Shader 算术,因此只能用来比较阶段量级,不能直接换算成毫秒。
Render Target 为什么会放大成本
每新增一个中间 Render Target,至少意味着一次写入,并且通常会在后续阶段再次被读取。高分辨率 HDR 纹理的单像素字节数更高,连续全屏读写更容易受显存带宽限制。若某效果还保留历史帧、深度、法线或速度纹理,工作集会进一步扩大。
排查时不要只看“效果开了几个”,而要记录每个效果实际产生多少 Pass、每个 Pass 的分辨率以及读了几张纹理。一个复杂效果可能比三个简单效果更贵,也可能因为运行在 1/4 分辨率而比预想便宜。
按阶段定位而不是一次全关
最可靠的方法是逐项关闭或旁路单个后处理阶段,并记录 GPU 帧时间变化。若关闭某阶段节省明显,再继续把它拆成分辨率、采样数和中间 RT 三个变量验证。
例如 Bloom 很贵时,先把模糊链从全分辨率改到半分辨率;如果 GPU 时间明显下降,说明填充率和带宽是主要因素。若降低分辨率收益有限,再检查采样核、纹理格式和是否存在不必要的重复合成。
最终需要得到的不是“后处理占了多少毫秒”这一条数字,而是一张可解释的成本清单:每个阶段运行几次、处理多少像素、采样多少纹理、写入哪些 Render Target。只要这些量被拆开,分辨率缩放、减少采样和合并 Pass 才能对应到明确的收益来源。