
图形渲染与 Shader / 系统课时
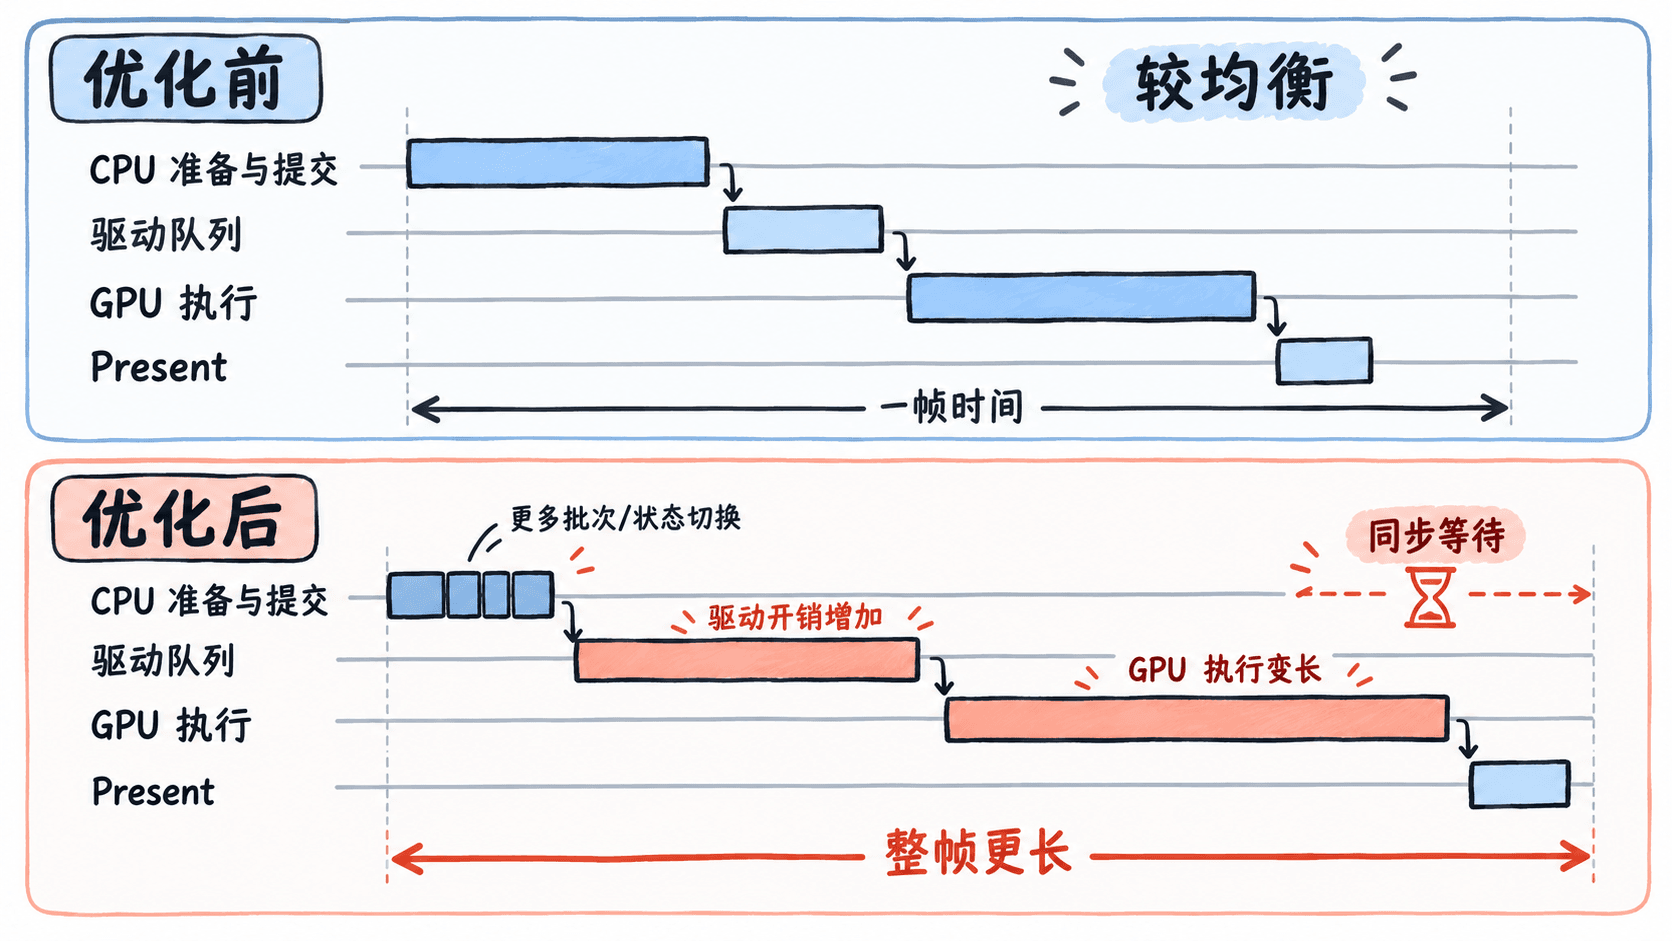
优化后为什么可能更慢
优化后为什么可能更慢
性能优化不是“减少某个数字就一定更快”。一次看似合理的改动,可能破坏缓存局部性、增加同步、改变批次结构、触发驱动额外工作,甚至把原本均衡的 CPU-GPU 管线推向新的瓶颈。本课用回归验证解释这些反效果应该怎样定位。
学习目标
- 能识别缓存、同步、批次、驱动和瓶颈迁移导致的性能回退。
- 能同时观察 CPU、GPU 与整帧时间,判断“局部更快、整体更慢”。
- 能用前后对照实验确认优化是否真的改善目标场景。
局部成本下降不等于整帧下降
游戏一帧由 CPU 准备、驱动提交、GPU 执行、资源访问和同步共同决定。某项优化若只降低 CPU 提交开销,却增加 GPU 状态切换、带宽或更昂贵的 Shader,最终帧时间仍可能上升。
缓存也是常见反例。为了“减少对象数量”而把原本连续的数据改成间接访问结构,可能降低缓存命中率;为了复用资源而增加共享状态,也可能带来锁、等待或更频繁的失效。优化前后的关键不是代码行数,而是关键路径是否缩短。
五类常见反效果
缓存问题通常表现为单线程指令量没有明显增加,但内存等待变多。同步问题则可能出现在资源上传、读回、Fence、锁或 Present 周围,CPU 或 GPU 一方提前完成,却必须等待另一方。
批次优化也可能反转。合批减少 Draw Call 后,如果把原本可剔除的小对象合成巨大批次,GPU 可能处理更多不可见几何;若材质差异仍然存在,还可能没有真正减少状态切换。驱动层面则可能因为资源创建、Shader 变体、状态变化或命令提交方式改变而增加隐性成本。
最后是 CPU-GPU 平衡变化。GPU 优化成功后,CPU 可能成为新瓶颈;CPU 优化成功后,GPU 可能暴露为瓶颈。此时某项指标确实下降,但整帧收益会小于局部收益,甚至被新的等待抵消。
用三组时间一起看回归
不要只比较一个指标。至少同时保留 CPU 时间、GPU 时间和测得的整帧时间,并在同一场景、同一构建配置和同一采样窗口下比较。下面的脚本展示如何快速标记局部变化与整体回退。
cases = [
    ("before", 8.3, 12.5, 13.0),
    ("batch_merge", 6.4, 13.7, 14.2),
    ("cache_friendly", 7.8, 10.9, 11.4),
    ("fewer_passes", 8.1, 9.4, 10.1),
]

base_frame = cases[0][3]

for name, cpu_ms, gpu_ms, frame_ms in cases:
    delta = (frame_ms - base_frame) / base_frame * 100
    bottleneck = "GPU" if gpu_ms > cpu_ms else "CPU"
    print(
        f"{name:15} cpu={cpu_ms:4.1f} gpu={gpu_ms:4.1f} "
        f"frame={frame_ms:4.1f} delta={delta:+5.1f}% bottleneck={bottleneck}"
    )
预期输出
before          cpu= 8.3 gpu=12.5 frame=13.0 delta= +0.0% bottleneck=GPU
batch_merge     cpu= 6.4 gpu=13.7 frame=14.2 delta= +9.2% bottleneck=GPU
cache_friendly  cpu= 7.8 gpu=10.9 frame=11.4 delta=-12.3% bottleneck=GPU
fewer_passes    cpu= 8.1 gpu= 9.4 frame=10.1 delta=-22.3% bottleneck=GPU
batch_merge 让 CPU 从 8.3 ms 降到 6.4 ms,却把 GPU 推到 13.7 ms,整帧反而增加 9.2%。这就是典型的“局部优化成功、整体性能回退”。实际项目还应结合 Profiler 时间线确认增加的 GPU 工作来自哪里。
回退时按因果链定位
先确认回退可重复,再回滚单个改动复测;如果回滚后恢复,才继续拆解该改动影响的缓存、批次、资源状态与同步点。不要同时继续叠加更多“优化”,否则很快失去可解释的对照组。
如果 CPU 时间下降而 GPU 时间上升,优先看批次扩大、不可见几何、状态切换和 Shader 变化。如果 CPU 与 GPU 都不高但整帧变慢,应检查同步等待、帧率限制、资源上传、Present 或其他未计入局部区间的等待。
优化完成的标准是关键路径缩短
一次优化只有在目标场景的关键路径稳定缩短、没有明显恶化高分位帧时间,并且瓶颈变化符合预期时,才算完成。局部指标变好可以作为证据,但不能替代整帧验证。
当瓶颈已经从 GPU 转移到 CPU,继续优化 GPU 仍可能降低功耗或给后续特效留余量,但若目标是提升当前帧率,就应重新定位新的限制因素,而不是沿着旧热点继续投入。