
图形渲染与 Shader / 系统课时
一帧从输入走到显示发生什么
一帧从输入走到显示发生什么
一次按键不会直接变成屏幕上的新画面。游戏通常要先处理输入和逻辑,再准备渲染命令,提交给 GPU 执行,最后等待显示系统在合适时机扫描输出。理解这条链路,才能判断一次慢帧究竟卡在 CPU、GPU,还是 CPU 与显示之间的等待。
学习目标
- 理解游戏线程、渲染线程、GPU 和显示系统在一帧中的基本职责
- 能按时间顺序解释从输入处理到画面显示的主要阶段
- 知道流水线并不等于所有阶段严格串行,以及为什么只看单个线程容易误判
CPU 先决定这一帧要做什么
玩家输入进入游戏后,CPU 侧通常先完成游戏逻辑,例如角色移动、动画更新、物理模拟、AI 和场景状态变化。这里可以抽象成“游戏线程”的工作,但真实引擎可能把部分任务分散到多个工作线程,并不一定只有一个线程执行全部逻辑。
逻辑状态更新后,渲染相关代码需要根据当前场景决定这一帧画什么,例如哪些物体可见、使用哪些材质、提交哪些绘制和计算任务。这些工作最终会形成 GPU 可以消费的命令。
某些引擎把游戏逻辑与渲染准备放在不同线程中,因此游戏线程完成第 N 帧逻辑时,渲染线程可能正在整理第 N-1 帧的命令。线程之间通过队列和同步点协作,而不是每一帧都从头到尾严格排队执行。
渲染线程负责准备和提交
渲染线程的核心职责不是亲自绘制像素,而是组织 GPU 工作。它会处理渲染状态、资源引用、绘制调用等信息,并通过图形 API 将命令提交给驱动和 GPU。
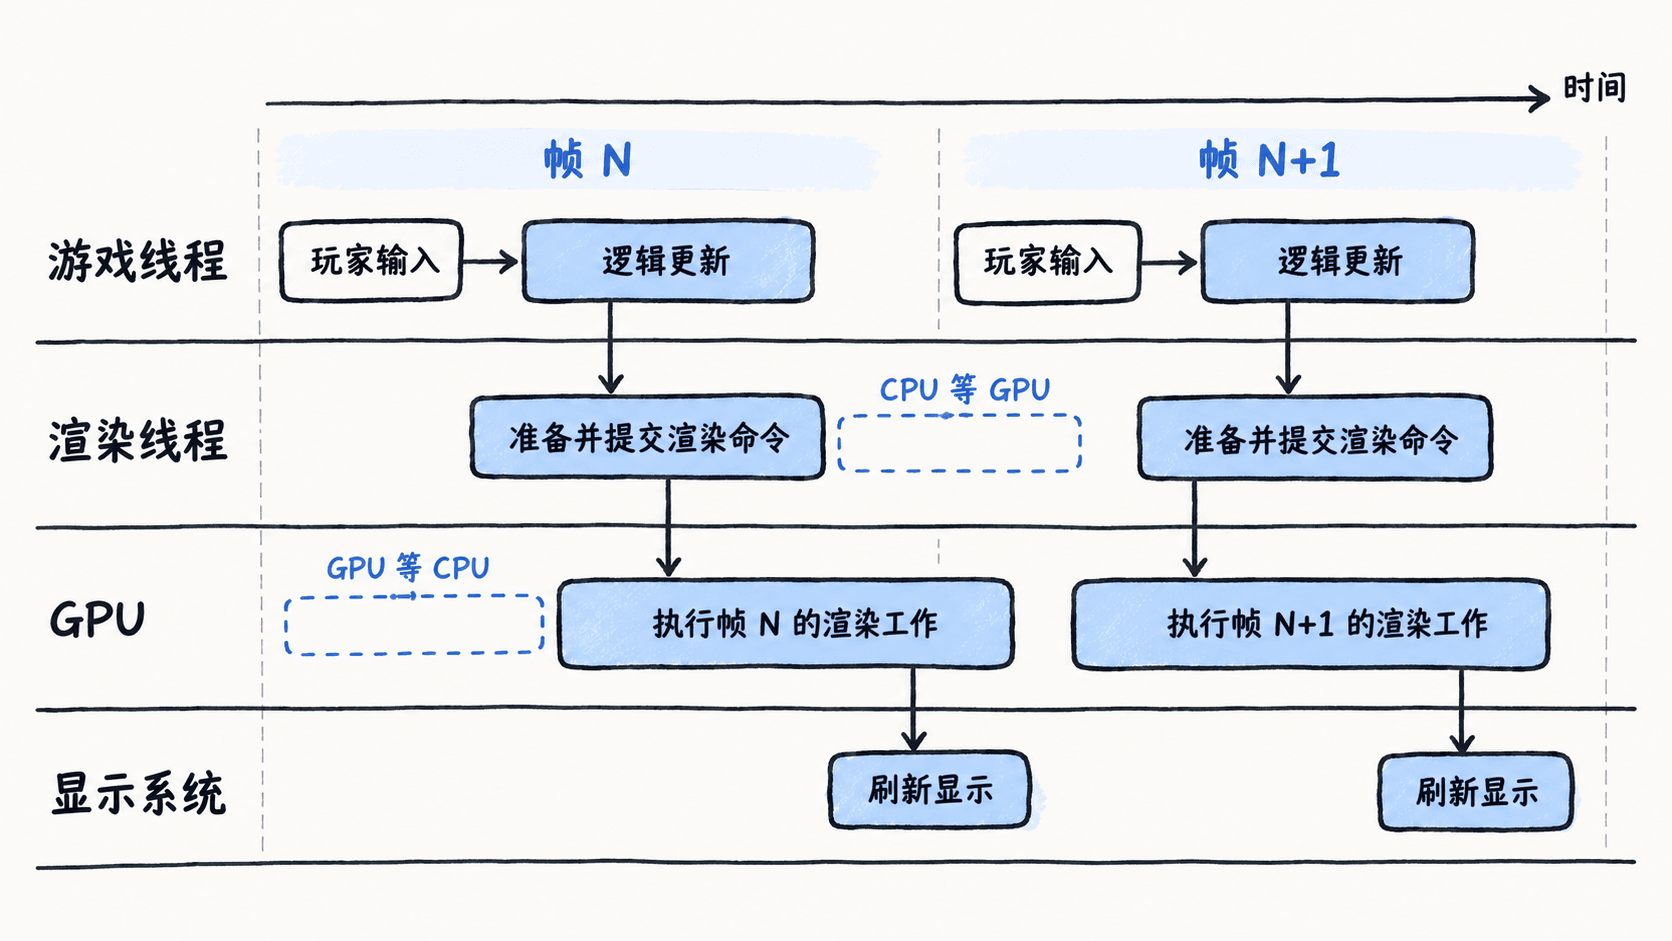
提交命令后,CPU 不一定等待 GPU 立即完成。为了提高吞吐量,CPU 与 GPU 往往形成流水线:CPU 继续准备后续帧,同时 GPU 处理之前已经提交的任务。因此屏幕正在显示的画面、GPU 正在渲染的帧以及 CPU 正在准备的帧可能并不是同一帧。
这种并行是理解性能分析的关键。如果 CPU 准备得慢,GPU 可能等不到新任务;如果 GPU 执行得慢,CPU 即使很快提交,也可能因为队列积压或同步限制最终被迫等待。
GPU 把命令变成最终图像
GPU 收到命令后,会执行顶点处理、光栅化、像素或片元处理、计算着色等工作,并把结果写入用于显示的图像缓冲区。具体阶段取决于渲染管线,但分析一帧时可以先把它们统一视为“GPU 工作时间”。
如果画面分辨率提高、复杂材质增多、阴影和后处理变重,GPU 时间通常会增加。反过来,即使 GPU 很强,如果 CPU 很晚才提交命令,它也可能出现空闲。因此“GPU 利用率不满”并不能单独证明 GPU 没有问题,也不能直接证明 CPU 就是瓶颈。
显示同步决定什么时候真正看见这一帧
GPU 完成图像后,并不意味着显示器立刻更新。图像通常还要经过交换链和显示同步机制,在允许的时机成为下一张显示内容。如果开启垂直同步,提交显示的节奏还会受到刷新周期约束。
例如 60 Hz 显示器约每 16.7 ms 出现一次刷新机会。如果某一帧没能赶上目标显示时机,就可能延后到后续刷新周期。此时玩家看到的延迟增长可能明显大于某个单独阶段增加的那几毫秒。
流水线为什么会让慢帧看起来复杂
假设某一帧的游戏逻辑突然变慢,直接影响首先出现在 CPU 侧,但 GPU 可能还在处理之前已经提交的工作,因此 GPU 时间曲线不会在完全相同的瞬间同步变化。性能工具里不同轨道之间存在帧号、队列深度或采样时间差时,更容易造成误判。
另一种情况是 GPU 本身持续处理不过来。CPU 初期仍然可以快速提交命令,但当允许排队的帧达到限制后,CPU 会在提交或同步位置等待。这时从 CPU 轨道上也能看到明显阻塞,但根因仍可能是 GPU 消费速度不足。
因此定位慢帧时,不应只问“哪个线程时间最长”,而应沿着依赖关系继续问:它是在主动工作,还是在等待另一个阶段?谁生产任务,谁消费任务,等待发生在流水线的哪个位置?
用时间关系判断瓶颈方向
CPU 侧持续很忙,而 GPU 经常等待新命令,通常说明 CPU 生产速度更值得检查。相反,如果 GPU 连续执行很久,CPU 又在提交或同步位置等待,则应该优先确认 GPU 工作是否已经超过目标帧预算。
如果 CPU 和 GPU 本身都不算忙,但呈现阶段频繁等待,则还要考虑帧率限制、垂直同步或其他显示节奏因素。性能分析的目标不是简单找一个“占用最高”的组件,而是确认哪一个阶段限制了下一帧继续向前流动。
理解一帧从输入、CPU 逻辑、渲染提交、GPU 执行再到显示的完整时序后,后续看到任何帧时间尖峰,都可以先把它放回这条流水线中定位。只有知道慢发生在哪个阶段以及谁在等待谁,CPU-bound、GPU-bound 和同步等待才不会混为一谈。