
图形渲染与 Shader / 系统课时
显存压力如何影响帧时间
显存压力如何影响帧时间
显存吃紧时,平均帧率可能还不难看,但帧时间会突然抬高并出现周期性尖峰。本篇用“预算占用、资源迁移、Streaming、缓存失效”这条链路判断长帧是否真由显存压力引起,并给出可复现的分析方法。
学习目标
- 看懂显存占用接近预算后为什么会出现不稳定帧时间
- 区分资源 Streaming、驱逐与重新上传造成的长帧
- 用时间线和帧数据验证“显存不足”而不是凭占用率下结论
显存压力真正影响的是资源驻留
GPU 访问纹理、缓冲区和渲染目标时,理想情况是资源已经驻留在本地显存。显存接近可用预算后,驱动或引擎可能回收低优先级资源,把数据暂存在系统内存,随后又因当前帧需要而重新上传。此时瓶颈不只是一项“显存占用高”,而是资源迁移引入的等待、复制和同步。
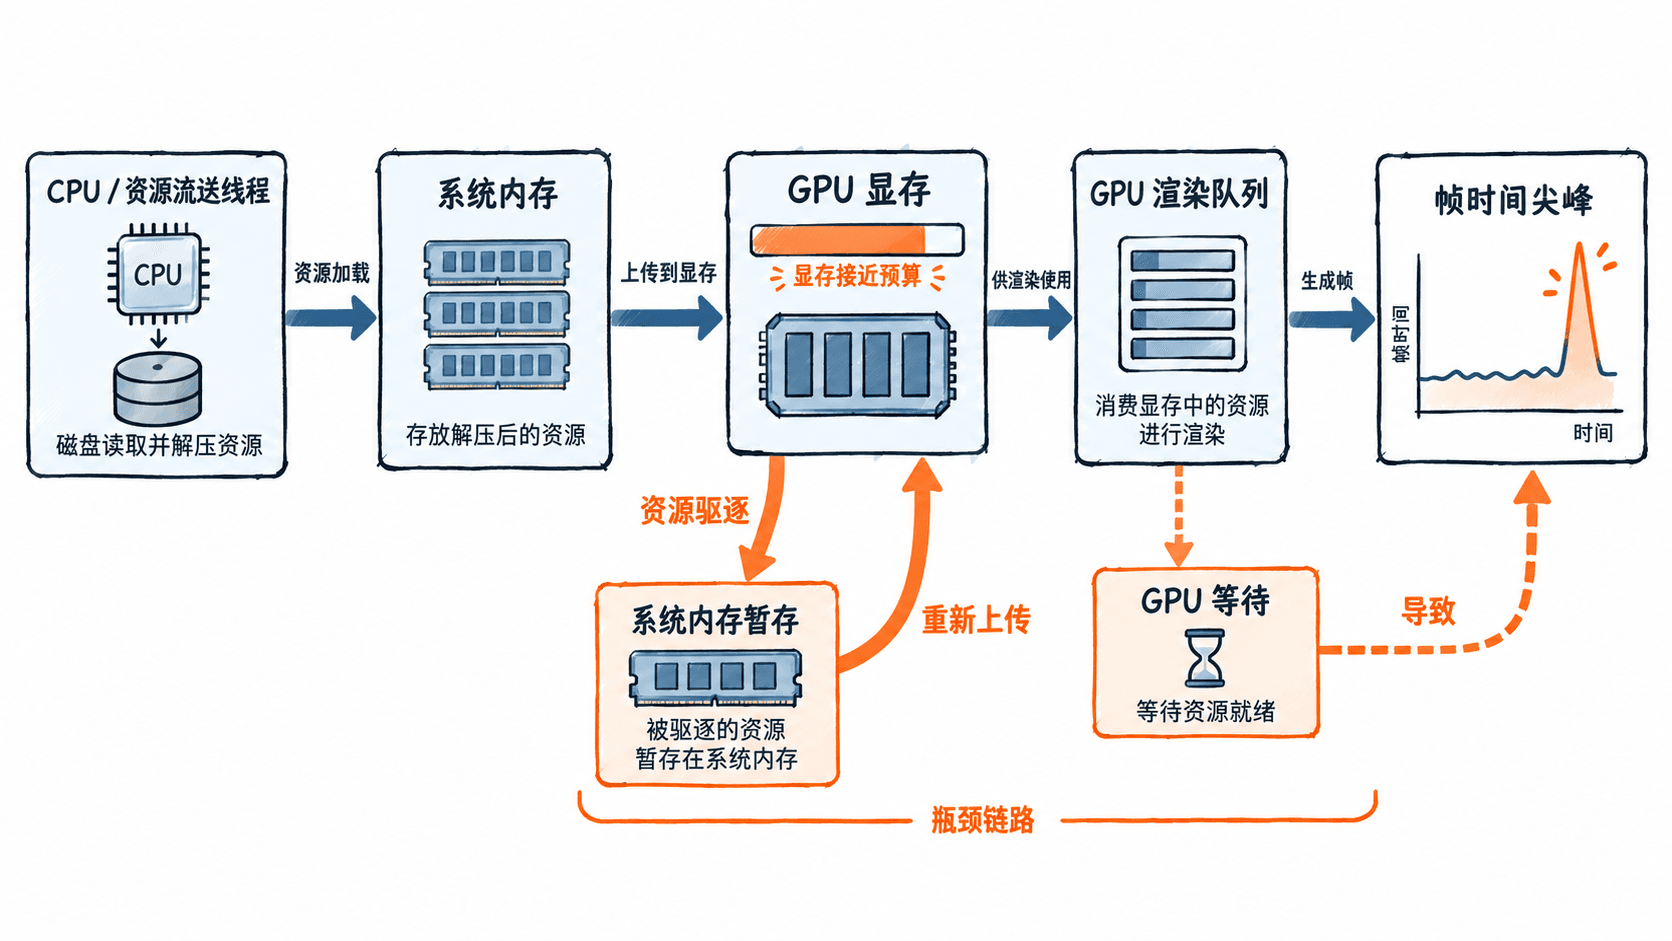
因此,判断依据应是“长帧发生时是否同时出现预算逼近、资源换入换出或上传突增”,而不是单看某一刻显存用了多少。部分引擎会主动把显存利用率维持得很高作为缓存,这本身并不等于存在问题。
Streaming 和缓存失效为什么会放大抖动
开放世界、高清材质和虚拟纹理常按视野动态流送资源。正常 Streaming 会提前读取并上传即将使用的数据;当预算不足时,刚加载的资源可能很快被驱逐,镜头回转后又重新加载,形成“加载—驱逐—再加载”的抖动。
如果纹理池、几何缓存或虚拟纹理页频繁失效,CPU 侧会增加 IO、解压与资源创建,GPU 侧会增加复制并等待资源可用。最终表现通常不是每一帧都慢,而是某些帧突然出现 20、40 甚至更高毫秒的尖峰。
用帧数据先找相关性
下面的 Python 示例模拟一段采样数据:当显存接近预算且上传量明显增加时,把对应长帧标记为“疑似显存压力”。真实分析时可把字段替换为性能工具导出的 CSV 数据。
from dataclasses import dataclass

@dataclass
class Frame:
    index: int
    frame_ms: float
    vram_used_mb: int
    vram_budget_mb: int
    upload_mb: int

frames = [
    Frame(100, 11.2, 6900, 8192, 18),
    Frame(101, 12.0, 7420, 8192, 22),
    Frame(102, 37.5, 8040, 8192, 420),
    Frame(103, 13.1, 7960, 8192, 35),
]

for frame in frames:
    pressure = frame.vram_used_mb / frame.vram_budget_mb >= 0.95
    long_frame = frame.frame_ms >= 25.0
    heavy_upload = frame.upload_mb >= 256
    if pressure and long_frame and heavy_upload:
        print(f"frame={frame.index}: suspect VRAM pressure")
预期输出
frame=102: suspect VRAM pressure这个规则只能用于快速筛选,不能直接代替结论。真正需要确认的是:同一长帧附近是否出现资源复制、驱逐、重新驻留或 Streaming 请求积压,并且降低纹理质量或资源池压力后,尖峰是否同步减少。
按时间线确认根因
排查时把长帧作为锚点,向前后各看几十到几百毫秒。先观察 GPU 是否有明显空洞或等待,再检查复制队列、资源上传、磁盘读取和解压任务是否集中出现。如果 GPU 本身一直满载、资源事件平稳,而只是某个渲染 Pass 变长,更可能是着色、分辨率或绘制负载问题。
一个很实用的验证方法是做 A/B:保持相同场景和镜头路径,只降低纹理分辨率、阴影缓存或 Streaming 池压力。如果显存峰值下降后长帧显著减少,而平均 GPU 工作量变化不大,说明资源驻留和迁移问题的证据更强。
什么时候应调整资源策略
确认显存压力后,优先减少“同时驻留”的资源,而不是只追求更快加载。可从纹理 Mip、缓存上限、场景预取范围、资源生命周期和临时渲染目标入手;对会反复使用的资源避免频繁销毁再创建。
最终要看的不是“显存还有多少空闲”,而是帧时间在资源切换、镜头移动和复杂场景中是否稳定。只要预算、上传与资源事件保持平稳,高显存利用率可以是正常缓存策略;一旦出现反复驱逐与重新上传,它才真正转化为可感知的帧时间问题。