
图形渲染与 Shader / 系统课时
CPU 热点先优化哪一层
CPU 热点先优化哪一层
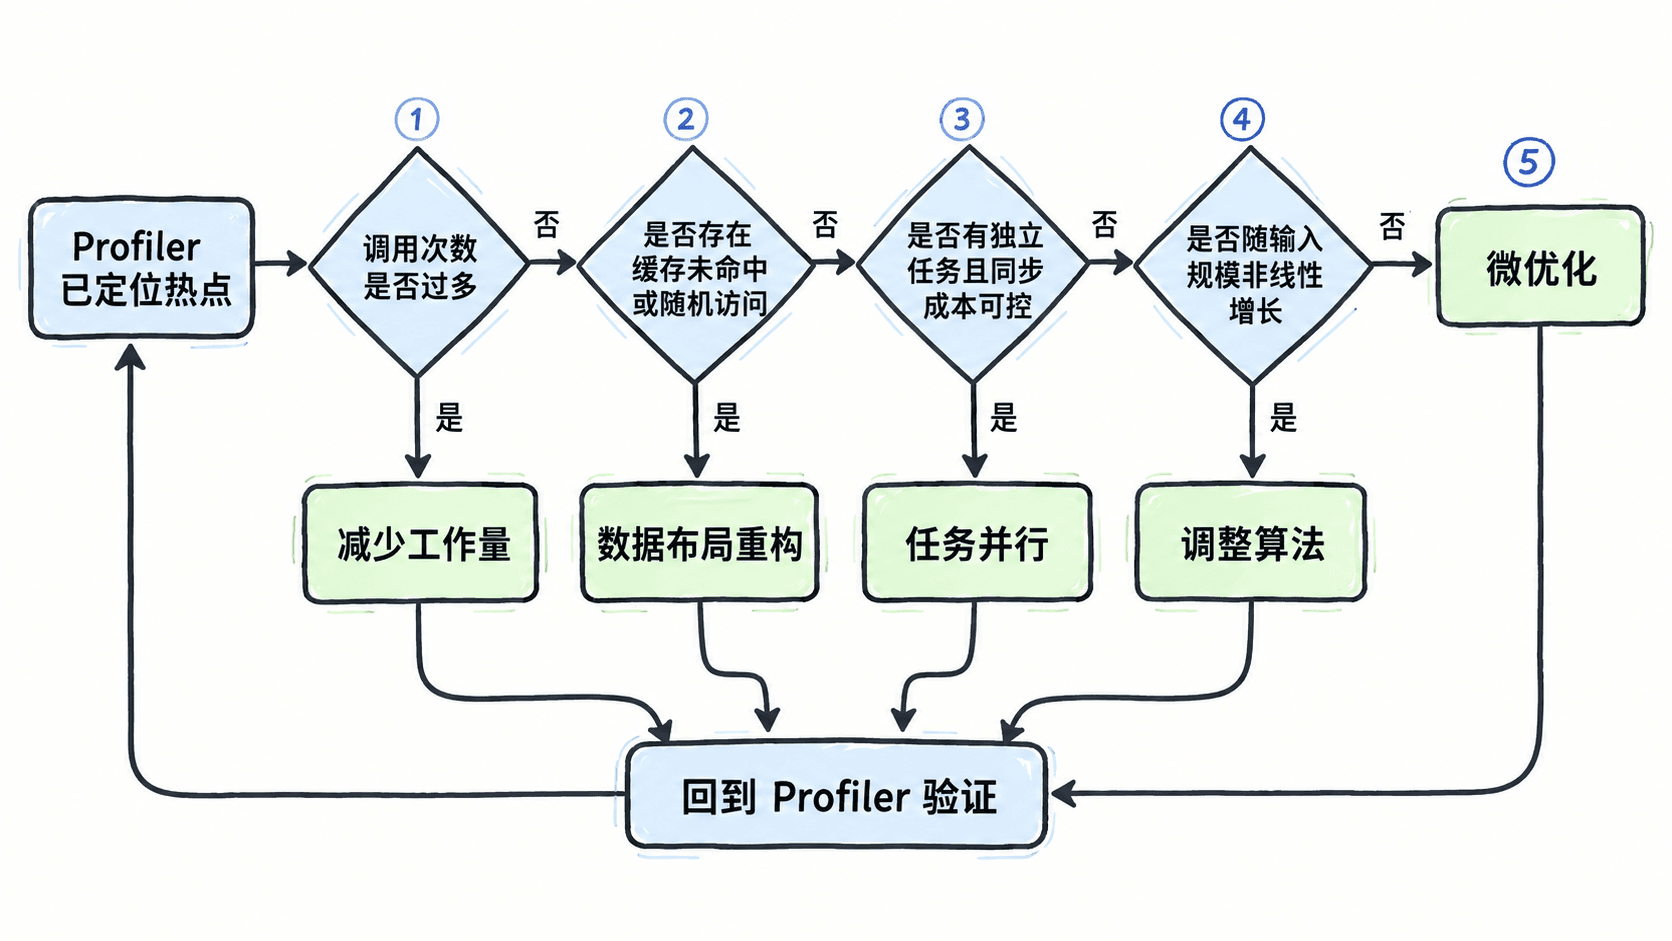
Profiler 找到 CPU 热点后,最危险的做法是直接钻进某一行做微优化。更有效的顺序是先问“能不能少做”,再问“数据能不能更适合 CPU”,之后才考虑并行与指令级细节。本篇用决策顺序比较减少调用、数据重构、任务并行和算法调整的适用边界。
学习目标
- 根据热点成因选择合适的优化层级,而不是只盯单函数耗时
- 判断减少工作量、改善数据布局、并行化和算法替换各自何时有效
- 用同场景、同输入、同采样条件验证优化是否真正改善帧时间
先判断热点为什么会热
先看热点是“单次很贵”还是“调用太多”。例如一个更新函数每次只耗时 3 微秒,但每帧调用 2 万次,优先方向通常不是把 3 微秒压成 2.5 微秒,而是减少调用次数、合并工作或跳过不需要更新的对象。
如果函数调用次数并不高,却因为随机内存访问、缓存未命中而慢,就应优先考虑数据重构。如果核心之间存在大量可独立处理的对象,才值得评估任务并行。若输入规模扩大后耗时呈明显非线性增长,则应优先怀疑算法复杂度。
优先减少根本不需要的工作
减少调用次数通常收益最大,因为它连带减少函数开销、内存访问和后续子任务。游戏里常见做法包括按可见性跳过更新、降低远处对象的更新频率、批量处理相同逻辑,以及把“每帧轮询”改成事件驱动。
下面是一个完整 C++ 示例:只有位置发生变化的实体才执行昂贵更新,用来说明“先少做”的思想。示例不测真实性能,只验证昂贵逻辑的调用次数是否被减少。
#include <iostream>
#include <vector>

struct Entity {
    bool dirty;
};

int main() {
    std::vector<Entity> entities = {
        {false}, {true}, {false}, {true}, {false}
    };

    int expensiveUpdates = 0;
    for (const auto& entity : entities) {
        if (!entity.dirty) {
            continue;
        }
        // 真实项目中这里代表动画、AI 或复杂组件更新。
        ++expensiveUpdates;
    }

    std::cout << "expensive_updates=" << expensiveUpdates << '\n';
    return 0;
}
预期输出
expensive_updates=2这个例子只验证“工作是否被跳过”。真正的性能收益仍要回到 profiler,看目标线程的总耗时、调用次数和帧时间是否同步下降。
数据重构解决缓存型热点
当热点函数本身逻辑很简单,但 CPU 时间仍高,并伴随缓存未命中、指针追逐或大量随机访问时,继续改表达式通常没有意义。可以考虑把热点字段连续存放、减少对象间跳转、按访问顺序整理数据,或把 AoS 改为更适合批处理的 SoA。
数据重构的代价是代码和数据生命周期可能更复杂,因此应先证明热点确实受内存行为限制。若只是函数调用太多,换布局并不能替代减少工作量。
并行化不是默认答案
任务并行适合大量相互独立、工作量足够大的任务,例如动画求值、粒子更新或可分块的 AI 计算。若任务粒度太小,线程调度、队列管理、同步和缓存竞争可能吃掉全部收益。
并行前应先确认主线程热点中存在可拆分区间,并估算串行部分。如果 80% 的时间都被可并行工作占据,才有较大空间;如果主要耗时集中在必须串行的世界状态提交,那么先设计并行任务系统并不会自动改善帧时间。
算法调整优先于微优化
当对象数量增长一倍,耗时却接近四倍,说明问题可能来自算法复杂度。例如每个单位都遍历所有其他单位做邻近查询,会接近 ;改为空间网格、四叉树或其他空间索引后,收益往往远大于循环展开或减少一次函数调用。
算法调整风险也最高,因为它可能改变数据结构和行为边界。因此应先用输入规模实验确认增长趋势,再决定是否值得重写。
用同一场景做优化闭环
每次只验证一个主要改动,并保持场景、相机路径、实体数量、帧率限制和采样区间一致。至少同时比较目标线程耗时、热点调用次数和最终帧时间;如果某函数快了,但帧时间没有改善,说明瓶颈可能已转移到其他线程或 GPU。
CPU 热点优化的目标不是让某个函数在局部基准里更漂亮,而是让真实帧的关键路径更短。只要每一次改动都回到 profiler 复测,并确认瓶颈确实向目标方向移动,就能避免把时间花在不可见的微小收益上。