
图形渲染与 Shader / 系统课时
资源上传会不会拖慢一帧
资源上传会不会拖慢一帧
纹理、Buffer 和 Streaming 资源上传常被误判成“只是一次内存拷贝”。实际一帧可能同时承担 CPU 准备、离散 GPU 的总线传输、Copy Queue 执行和渲染队列同步。本课把上传链路拆开观察,并用时间线判断真正拖慢帧的是带宽、提交方式还是等待关系。
学习目标
- 区分 CPU 准备、传输复制和 GPU 同步三类上传成本。
- 从帧时间线判断资源上传是否造成主线程、Copy Queue 或 Graphics Queue 停顿。
- 通过分批上传、环形上传缓冲和异步提交减少资源 Streaming 对单帧的冲击。
把一次上传拆成三段成本
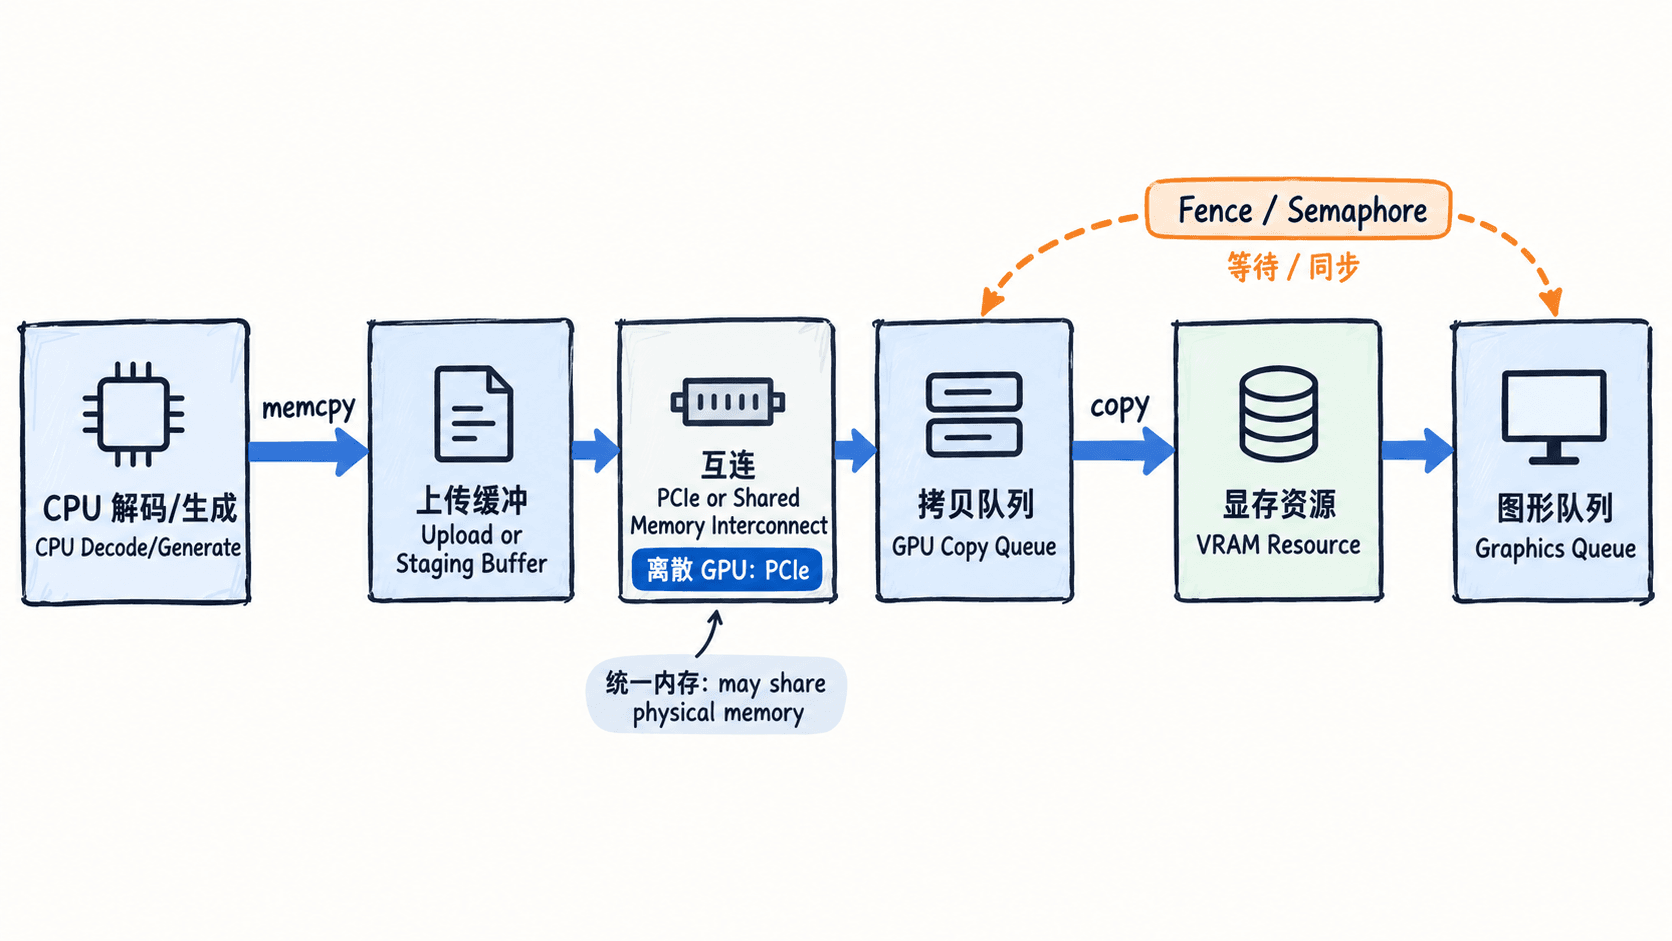
以离散 GPU 为例,数据通常先在 CPU 侧解码或生成,再写入可被复制命令读取的上传缓冲,随后经过 PCIe 传到显存目标资源。复制完成后,渲染队列还要在正确的同步点之后才能消费这份资源。任何一段集中到同一帧,都可能形成尖峰。
集成 GPU 或统一内存架构不一定经过独立 PCIe 传输,因此不能把“上传慢”一律解释成总线带宽不足。即使物理内存共享,缓存维护、资源状态转换、驱动提交和 GPU 等待仍然存在,分析时仍要把 CPU 与 GPU 两侧的时间分开。
真正危险的是“上传后立刻要用”
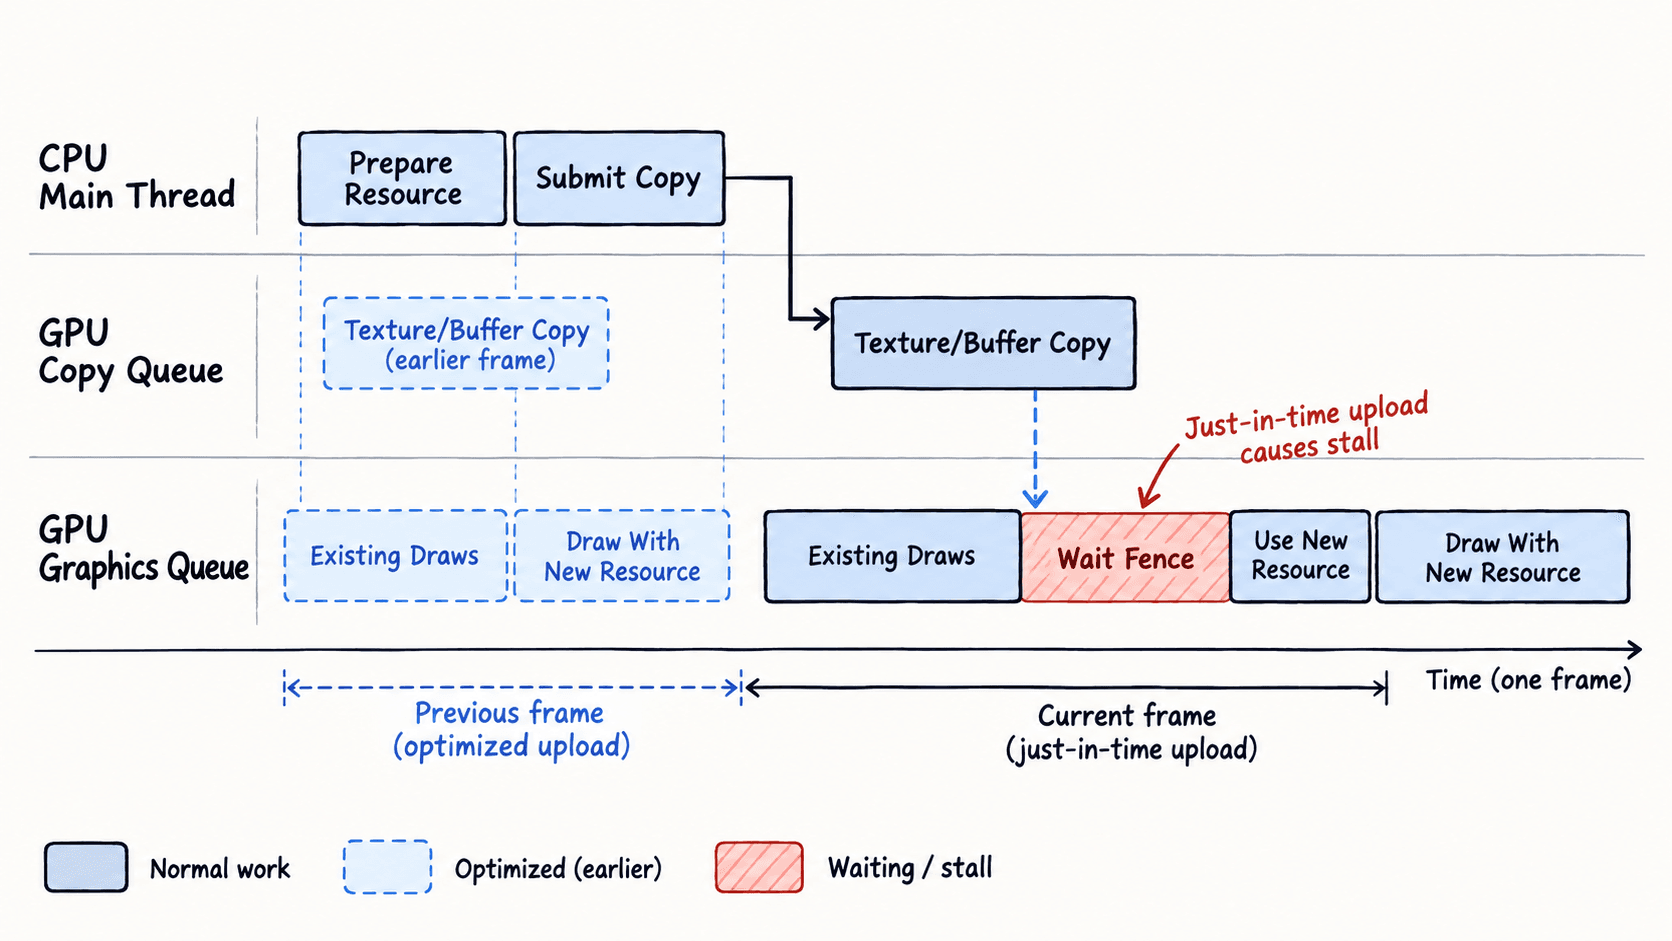
上传本身可以和 CPU 逻辑、甚至部分 GPU 渲染重叠。最容易拖慢一帧的模式是资源刚提交复制,当前帧马上就要求 Graphics Queue 使用它,于是渲染队列必须等待复制完成;如果 CPU 还同步等待 fence,主线程也会一起被阻塞。
在 Vulkan 中,上传到 GPU 本地 Buffer 的典型命令包含复制和后续可见性同步。下面是片段示例,假设 cmd 已开始记录,stagingBuffer 已写入数据,gpuBuffer 已创建且两者位于同一队列族可访问范围;示例展示的是“复制完成后作为顶点缓冲读取”的关键关系。
void recordVertexUpload(
VkCommandBuffer cmd,
VkBuffer stagingBuffer,
VkBuffer gpuBuffer,
VkDeviceSize bytes) {
VkBufferCopy copyRegion{};
copyRegion.srcOffset = 0;
copyRegion.dstOffset = 0;
copyRegion.size = bytes;
vkCmdCopyBuffer(cmd, stagingBuffer, gpuBuffer, 1, ©Region);
// 保证传输写入对后续顶点输入阶段可见。
VkBufferMemoryBarrier barrier{VK_STRUCTURE_TYPE_BUFFER_MEMORY_BARRIER};
barrier.srcAccessMask = VK_ACCESS_TRANSFER_WRITE_BIT;
barrier.dstAccessMask = VK_ACCESS_VERTEX_ATTRIBUTE_READ_BIT;
barrier.srcQueueFamilyIndex = VK_QUEUE_FAMILY_IGNORED;
barrier.dstQueueFamilyIndex = VK_QUEUE_FAMILY_IGNORED;
barrier.buffer = gpuBuffer;
barrier.offset = 0;
barrier.size = bytes;
vkCmdPipelineBarrier(
cmd,
VK_PIPELINE_STAGE_TRANSFER_BIT,
VK_PIPELINE_STAGE_VERTEX_INPUT_BIT,
0,
0, nullptr,
1, &barrier,
0, nullptr);
}这段代码依赖已经初始化好的 Vulkan 设备、命令缓冲和资源,因此不能单独运行。若复制发生在专用 Transfer Queue,而消费发生在另一个队列族,还需要正确处理队列所有权转移,并用 semaphore 等机制建立跨队列依赖;不能直接照搬这里的同队列写法。验证时应在 GPU 时间线上看到 Copy 命令先完成,随后目标 Buffer 才进入顶点读取阶段。
从一帧时间线找出瓶颈位置
先记录每帧上传字节数和资源数量,再把 CPU 与 GPU 时间线对齐。如果帧尖峰同时伴随 CPU 解码、内存分配或大块 memcpy,问题首先在 CPU 侧;如果 Copy Queue 长时间满载而 Graphics Queue 等 fence,则更像传输带宽或提交过晚;如果复制很快却出现明显 Queue Wait,则重点检查同步关系。
Streaming 问题还要关注“突发性”。平均每帧 20 MB 的上传和连续几帧突然上传数百 MB,对帧稳定性的影响完全不同。性能目标应限制单帧上传预算,而不是只看一段时间内的平均吞吐量。
把突发上传改成可预算的流水线
纹理和静态 Buffer 尽量提前预取,不要等到对象即将绘制时才上传。大量小资源应合并复制命令,减少频繁提交;动态顶点、常量或实例数据适合使用持久映射的环形 Upload Buffer,再按帧或 fence 回收已经完成的区域。
资源 Streaming 可以设置“每帧最多上传多少字节或消耗多少 CPU 时间”的预算,把一次大峰值拆到多个帧。对于纹理,还可以先上传较低 mip 保证资源可用,再逐步补齐高分辨率 mip,这通常比同一帧上传完整纹理更容易保持稳定帧时间。
验证时同时看吞吐和等待
优化后不要只确认“上传速度更快”,还要确认关键渲染队列不再等待。对同一场景比较每帧上传字节数、CPU 准备时间、Copy Queue 占用、Graphics Queue Wait、主线程 fence 等待和 P95/P99 帧时间,才能判断尖峰是否真正被拆散。
如果上传量很高但 Copy Queue 与渲染稳定重叠,说明吞吐量本身未必是问题;相反,即使只上传少量资源,只要在关键绘制前产生同步等待,也可能拖慢整帧。资源上传优化的目标是让数据更早、更批量、更可预算地到达 GPU,而不是单纯追求更高的瞬时带宽。