
图形渲染与 Shader / 系统课时
哪些 Pass 最值得先查
哪些 Pass 最值得先查
一帧里可能有主光照、阴影、反射、透明、后处理等多个 Pass。真正有效的优化不是逐项“都省一点”,而是先找出占用 GPU 帧时间最多、波动最大或被重复执行的 Pass,再判断它是否值得改质量、分辨率、次数或实现方式。
学习目标
- 能按 GPU 帧时间贡献给 Pass 排优先级,而不是凭名称猜成本
- 能区分“单次很贵”和“调用很多次”的两类热点
- 能用最小数据集验证一次 Pass 优化是否真的改善整帧
先看帧时间贡献,不先看名字
同一个 Pass 在不同场景里的成本可能完全不同。后处理在一个项目里可能只占 0.4 ms,在另一个项目里却因为高分辨率、多层 Bloom 和景深达到 3 ms。判断优先级时,第一指标应是它对目标帧的实际耗时贡献。
可以先记录一帧中主要 Pass 的 GPU 时间,并按耗时从高到低排序。假设目标是 60 FPS,单帧预算约 16.67 ms,而 GPU 当前需要 18.2 ms,那么首先应处理贡献最大的几个 Pass,而不是从所有 Pass 平均削减。
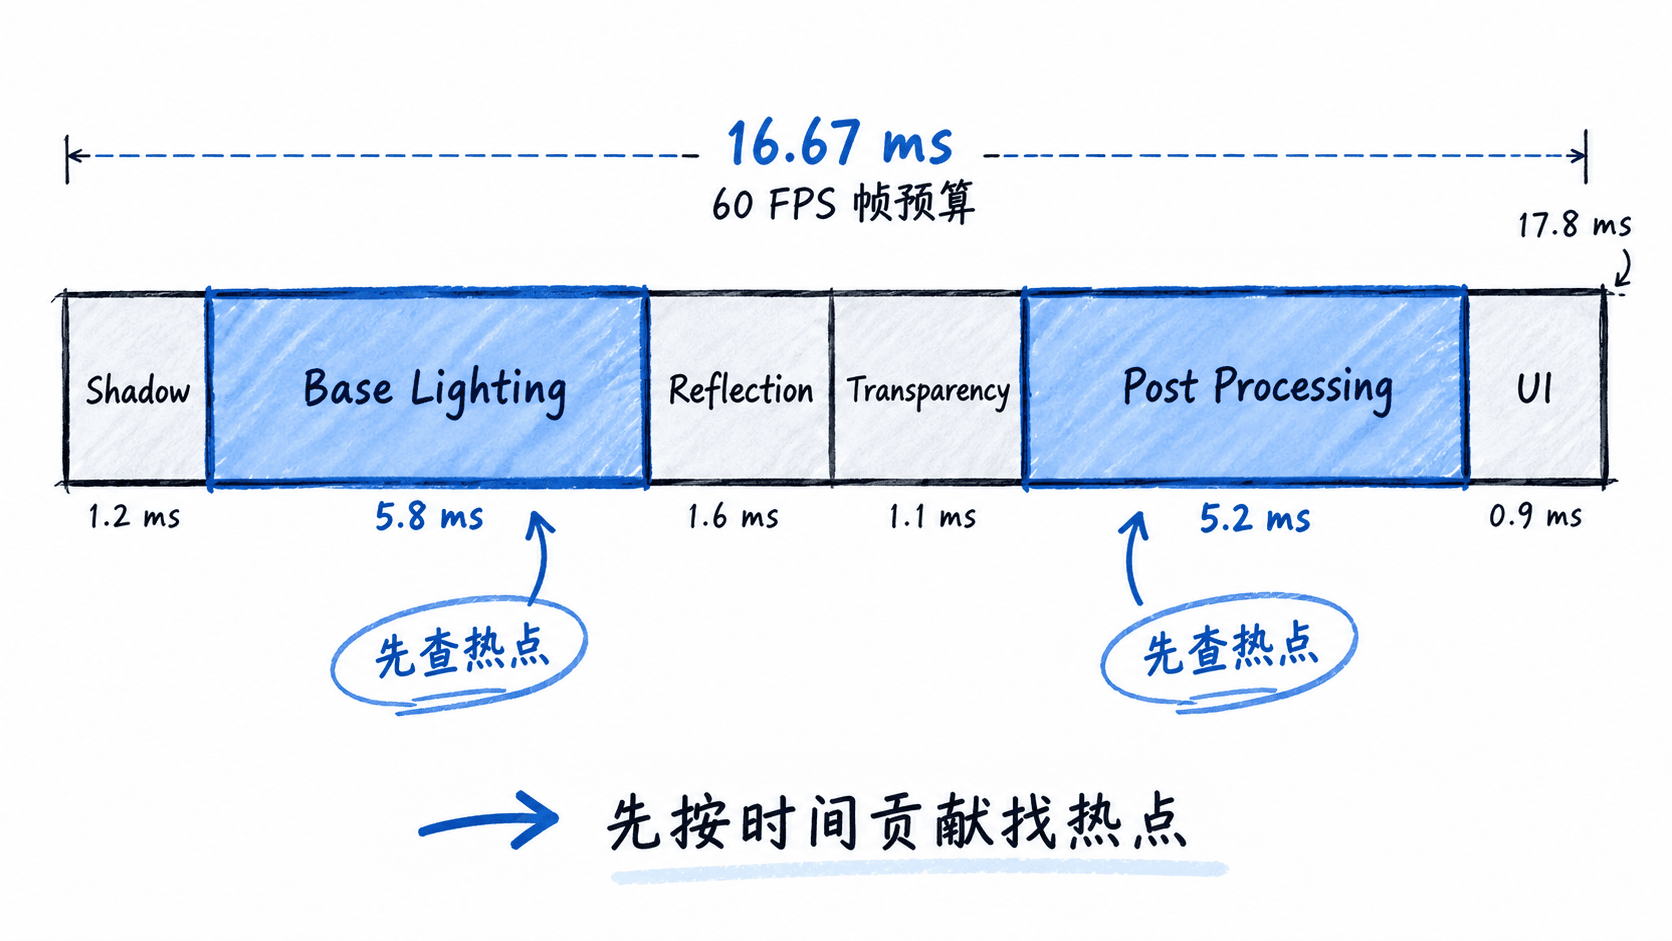
同时看单次成本和执行次数
只看“某个 Pass 一次用了多少毫秒”还不够。一个 0.2 ms 的 Pass 如果执行 10 次,总成本就是 2 ms;一个 1.2 ms 的 Pass 如果只执行一次,反而更便宜。因此排查时至少记录名称、次数、总耗时和平均耗时。
| Pass | 次数 | 总 GPU 时间 | 平均每次 |
|---|---|---|---|
| Shadow | 4 | 3.6 ms | 0.9 ms |
| Base Lighting | 1 | 4.8 ms | 4.8 ms |
| Reflection | 2 | 2.4 ms | 1.2 ms |
| Bloom | 1 | 0.7 ms | 0.7 ms |
这组数据里,Base Lighting 是单次最贵的 Pass,Shadow 则因为执行 4 次形成第二大总成本。两者都比 Bloom 更值得先查,但优化方向不同:前者应关注像素成本、材质和光照复杂度,后者还要检查级联数量、光源数量和更新频率。
用简单排序避免“平均用力”
把一次捕获导出的 Pass 时间整理成列表,就能快速得到总耗时排名。下面的 Python 示例只做一件事:按每个 Pass 的总 GPU 时间降序排列,并计算它占这些已统计 Pass 总时间的比例。
passes = [
    {"name": "Shadow", "count": 4, "total_ms": 3.6},
    {"name": "Base Lighting", "count": 1, "total_ms": 4.8},
    {"name": "Reflection", "count": 2, "total_ms": 2.4},
    {"name": "Bloom", "count": 1, "total_ms": 0.7},
]

total = sum(item["total_ms"] for item in passes)

for item in sorted(passes, key=lambda x: x["total_ms"], reverse=True):
    share = item["total_ms"] / total * 100
    avg = item["total_ms"] / item["count"]
    print(f'{item["name"]}: {item["total_ms"]:.1f} ms, '
          f'{share:.1f}%, avg {avg:.2f} ms')
预期输出
Base Lighting: 4.8 ms, 41.7%, avg 4.80 ms
Shadow: 3.6 ms, 31.3%, avg 0.90 ms
Reflection: 2.4 ms, 20.9%, avg 1.20 ms
Bloom: 0.7 ms, 6.1%, avg 0.70 ms
这类排序不能替代 GPU Profiler,但能强制你先处理“大头”。如果前三个 Pass 已占到大部分 GPU 时间,那么先优化排名靠后的 0.1~0.3 ms 项目,通常很难让整帧产生可感知变化。
再判断热点是否稳定且可控
一次捕获中的第一名不一定就是最终目标。应在相同相机位置、相同画质和相同负载下重复采样,确认热点是否持续存在。若某个 Pass 只在爆炸特效、雨天或大量透明物体出现时突然升高,它属于场景型热点,需要针对触发条件分析。
还要区分“可控成本”和“不可直接控成本”。例如分辨率、阴影级联、反射更新频率、后处理质量通常可以直接调节;而某些基础光照 Pass 的成本可能来自材质数量、过度绘制或着色器复杂度,需要继续向 Draw Call、像素覆盖和 Shader 指令拆解。
优化后只看整帧是否真的下降
修改某个 Pass 后,应重新抓取同一测试场景并对比 GPU 帧时间。某个 Pass 从 3.6 ms 降到 2.5 ms,但整帧只减少 0.2 ms,可能说明工作被转移到了其他 Pass、出现新的同步等待,或测试条件并不一致。
当主光照、阴影、反射或后处理中的某一项已经占据明显的大块帧时间时,它就是优先调查对象;如果各项都很小却整帧仍然很慢,则应转向带宽、同步、CPU 提交或隐藏的重复渲染,而不是继续在小 Pass 上平均用力。