
图形渲染与 Shader / 系统课时
材质复杂度如何落到帧时间
材质复杂度如何落到帧时间
材质“看起来复杂”不等于它已经拖慢一帧。真正需要回答的是:这份材质让 GPU 多做了哪些工作,这些工作是否落在当前瓶颈阶段,以及它们最终让某个渲染 Pass 增加了多少毫秒。
学习目标
- 把材质指令、纹理采样、分支和着色器变体与 GPU 帧时间联系起来
- 用对照实验判断复杂材质是否真的构成 GPU 瓶颈
- 区分“着色器更复杂”和“帧时间真的更长”
从材质复杂度映射到 GPU 成本
材质复杂度通常体现在四类成本:算术指令增加、纹理采样增加、动态分支引入,以及更多着色器变体。它们不会以同样方式影响性能,因为 GPU 的执行时间还取决于分辨率、覆盖像素数、缓存命中率、带宽和并行度。
例如,一个只覆盖屏幕 5% 的复杂材质,可能比覆盖全屏的简单后处理更便宜。反过来,一个高频使用、覆盖大量像素的材质,即使每像素只多一次采样,也可能在高分辨率下形成稳定的毫秒级成本。
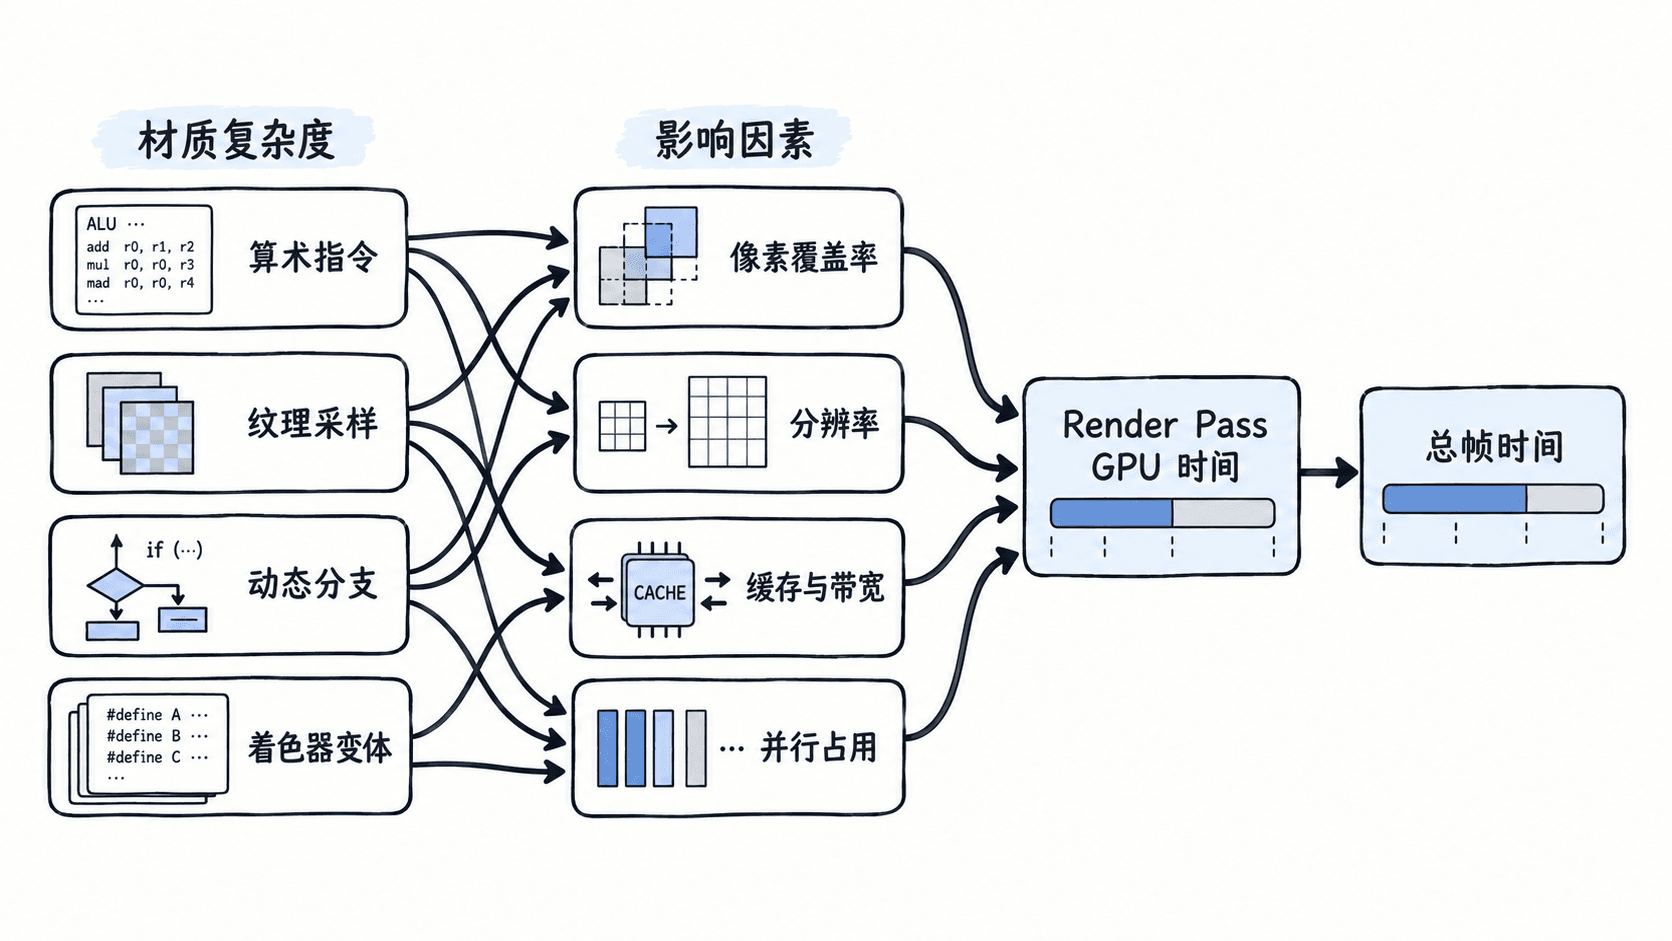
指令数量不是最终结论
着色器编译器显示的指令数只能描述静态复杂度,不能直接等价为耗时。现代 GPU 会隐藏部分算术延迟,而纹理读取可能被缓存,也可能因为访问模式差而受内存带宽限制。
下面是一个用于说明成本来源的 HLSL 片段示例。它假设纹理、采样器和输入结构已由引擎绑定,不能独立运行。
float3 ShadeMaterial(float2 uv, float3 normal, float roughness)
{
    float3 base = BaseColorTex.Sample(LinearSampler, uv).rgb;
    float3 detail = DetailTex.Sample(LinearSampler, uv * 4.0).rgb;
    float facing = saturate(dot(normalize(normal), float3(0, 0, 1)));

    if (roughness < 0.35)
    {
        base += detail * pow(facing, 8.0);
    }

    return base;
}
这个片段同时包含两次纹理采样、算术运算和一个动态分支。验证时不要只看“多了几行代码”,而要比较该材质对应 Pass 的 GPU 时间,并观察不同视角、分辨率和覆盖面积下是否持续变慢。
用 A/B 对照把成本落到毫秒
判断材质是否成为瓶颈,最可靠的方法是做受控替换。先固定场景、相机、分辨率和渲染设置,采集稳定区间内的 GPU 帧时间;再把目标材质替换为极简材质,比较同一个 Pass 的耗时变化。
假设原材质所在 Pass 为 4.8 ms,替换后为 3.1 ms,而其他 Pass 基本不变,那么可以认为这份材质贡献了约 1.7 ms 的可疑成本。如果总帧仍由另一段 10 ms 的 Pass 主导,它虽然昂贵,却还不是当前首要瓶颈。
预期结果可整理成下面这样的对照记录:
原材质: TargetPass = 4.8 ms, GPU Frame = 15.9 ms
简化材质: TargetPass = 3.1 ms, GPU Frame = 14.2 ms
差值: TargetPass -1.7 ms, GPU Frame -1.7 ms
实际数值会随设备和场景变化,重点是看同一采样条件下的差值,而不是追求某个固定阈值。
纹理、分支与变体分别怎么看
纹理采样多时,要结合缓存和带宽判断。高分辨率纹理、无规律 UV、过多独立采样通常更容易放大带宽压力;如果降低纹理分辨率或减少采样后 GPU 时间明显下降,说明问题更接近纹理访问而不是纯算术。
动态分支只有在同一执行批次内出现明显分歧时才可能造成额外浪费。不要看到 if 就判定昂贵,应通过固定条件或改成无分支版本做对照。着色器变体则更多影响编译、缓存、切换和批处理,变体数量大不代表单次像素着色一定更慢。
什么时候可以确认它是瓶颈
可以把结论收敛到三个条件:替换或简化材质后,同一 Pass 的 GPU 时间稳定下降;下降量能解释总 GPU 帧时间的变化;并且该 Pass 位于当前帧的关键路径,而不是被更慢阶段完全掩盖。
满足这三点时,优化才有明确方向。此时再去减少采样、压缩计算、调整分支或合并变体,才能把“材质复杂”转化为可验证的帧时间收益。