
图形渲染与 Shader / 系统课时
几何开销从哪里来
几何开销从哪里来
当降低分辨率几乎不能改善 GPU 帧时间,而减少模型、实例或阴影投射物后性能明显恢复,就需要把注意力转向几何阶段。本课围绕顶点、三角形、实例数量和几何处理流程,建立从现象到热点的定位方法,而不是简单把“面数高”当成唯一原因。
学习目标
- 理解顶点、三角形和实例数量分别会增加哪些 GPU 工作
- 能通过控制变量实验判断几何阶段是否成为主要瓶颈
- 能区分模型复杂度、实例膨胀和无效小三角形等不同问题
几何阶段不只是在数三角形
一帧中的模型通常要经历顶点数据读取、顶点着色、图元组装、裁剪、光栅化等步骤,随后才进入像素阶段。如果启用了骨骼蒙皮、顶点位移、曲面细分或多次阴影渲染,同一批几何还可能被重复处理。
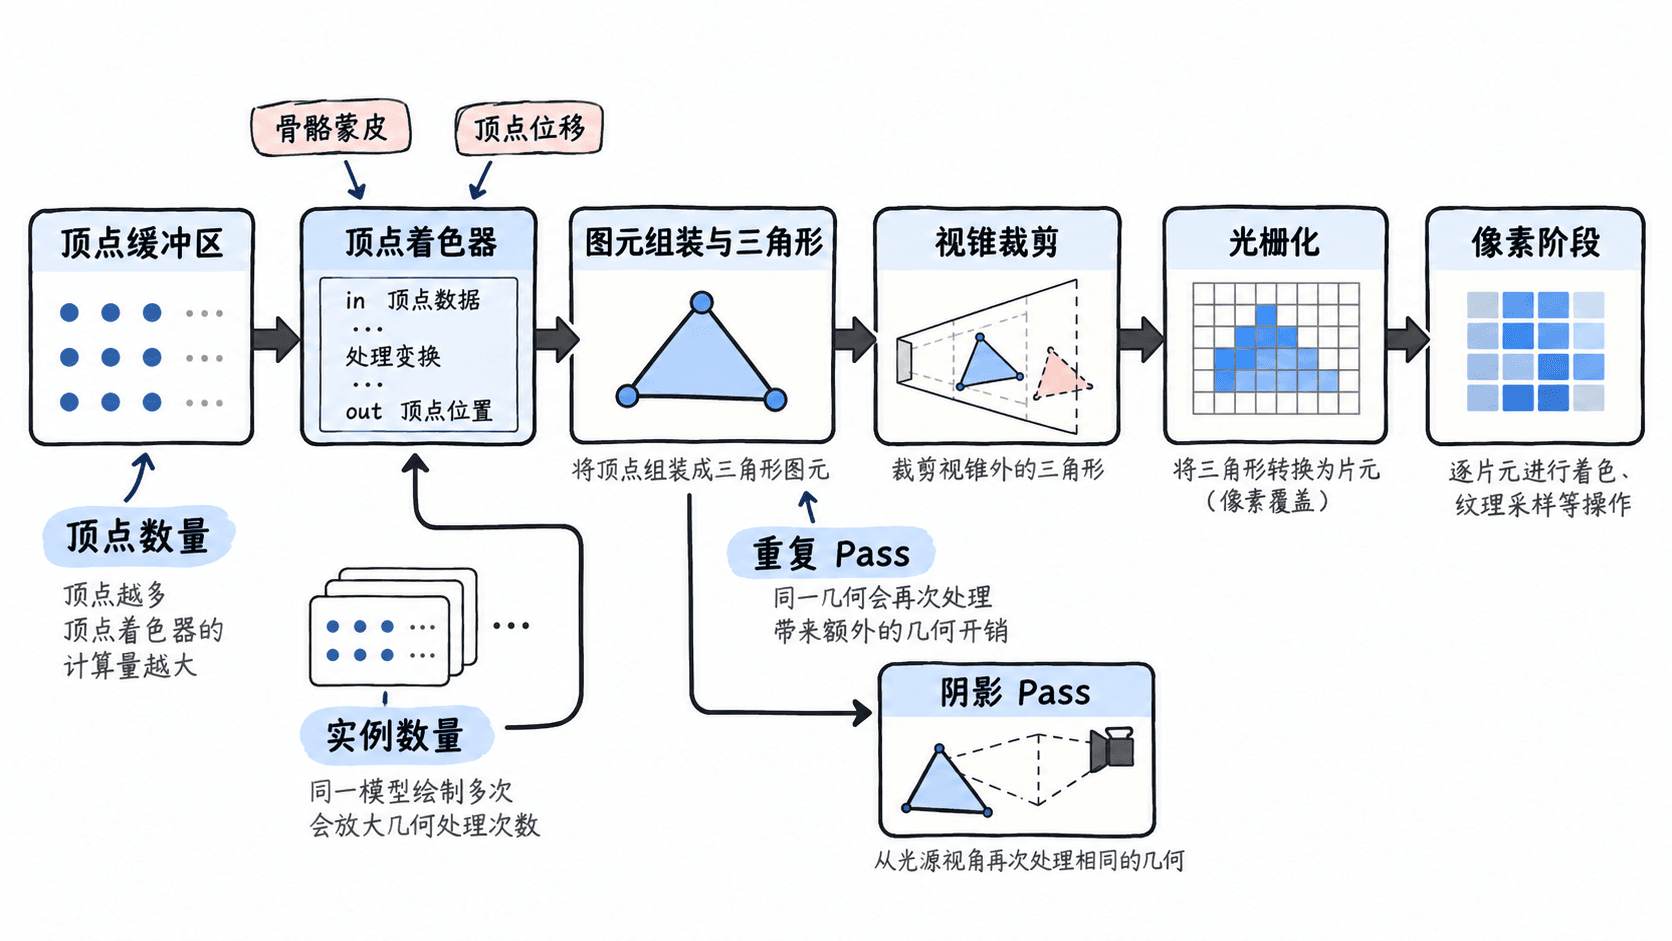
因此,“场景有 500 万个三角形”只是一个起点。真正影响成本的还包括这些三角形是否每帧可见、是否被多个 Pass 重复绘制、顶点着色器是否昂贵,以及大量三角形是否小到只覆盖几个甚至不到一个像素。
用分辨率不敏感现象缩小范围
几何瓶颈的一个典型信号是:大幅降低渲染分辨率后,GPU 时间变化很小。原因是分辨率主要减少像素阶段工作,而顶点着色和图元处理的数量基本没有同步下降。
可以继续做控制变量实验:保持摄像机位置和材质不变,逐步降低模型 LOD、隐藏高面数对象或减少可见实例。如果 GPU 时间随几何数量下降,就说明调查方向正确。相反,如果模型数量减半仍没有明显变化,热点可能仍在阴影、像素、带宽或其他阶段。
顶点数量和顶点着色器共同决定成本
每个需要处理的顶点都要执行顶点着色器。普通静态网格可能只做坐标变换,而蒙皮角色通常还需要读取骨骼索引与权重,并组合多个骨骼矩阵。顶点位移动画或复杂风场也会继续增加单顶点成本。
下面是一个简化的 HLSL 片段示例,依赖引擎提供矩阵和顶点输入结构,不能独立运行。它说明即使三角形数量不变,增加每顶点计算也会提高几何阶段负担。
float4 TransformVertex(float3 position, float3 offset)
{
    // 顶点位移发生在每个参与绘制的顶点上
    float3 animatedPosition = position + offset;
    return mul(ViewProjectionMatrix, float4(animatedPosition, 1.0));
}
如果一个模型拥有大量顶点,这段计算会随顶点数重复执行。真实角色蒙皮通常比示例复杂得多,因此排查角色密集场景时,除了面数,还应比较静态模型、蒙皮模型以及关闭顶点动画后的 GPU 时间。
小三角形可能让吞吐效率下降
三角形并不是越小越便宜。大量远距离高精模型会生成密集的小三角形,其中一些只覆盖几个像素。GPU 仍需完成顶点处理、图元组装和光栅化,而实际产生的有效像素却很少,几何处理效率会下降。
LOD 的价值就在这里:物体离摄像机越远,屏幕占用越小,就越没有必要保持近景模型的全部细节。排查时可以强制使用更低一级 LOD。如果画面变化可接受而 GPU 时间明显下降,应优先检查 LOD 切换距离和远景模型复杂度。
实例数量会把工作按对象放大
实例化可以减少 CPU 侧提交成本,但不会让几何处理本身消失。绘制 1000 棵相同的树时,即使使用 GPU Instancing,每个可见实例仍然需要处理对应顶点。单个模型有 20 万顶点时,大量实例同时进入视野依然可能形成巨大的顶点工作量。
另一个容易忽略的来源是重复 Pass。同一个角色除了主渲染,还可能进入方向光阴影、点光源阴影、深度预处理或其他专用 Pass。模型统计面板显示的原始三角形数量因此不一定等于一帧真正处理的几何总量。
定位时应依次尝试降低 LOD、减少可见实例、关闭部分阴影投射和简化顶点计算,每次只改变一个条件并记录 GPU 时间。只要某个改动稳定降低对应几何 Pass 的耗时,就能把“GPU 跑不动”进一步收敛到具体的几何来源,而不是停留在笼统的“模型太复杂”。