
可观测性与稳定性 / 系统课时
复盘恢复过程并修正Runbook
复盘恢复过程并修正Runbook
灾难恢复演练结束后,真正有价值的产物不是一句“恢复成功”,而是可量化的恢复时间线、暴露出的遗漏与人工依赖,以及据此修订后的 Runbook。本节把一次演练记录整理成可执行的改进项,并验证下一次恢复是否能更快、更稳定地完成。
学习目标
- 根据恢复时间线定位主要耗时、等待和返工环节
- 区分 Runbook 缺陷、备份策略缺陷与自动化不足
- 将复盘结论转化为可验证、可执行的 Runbook 修改项
先用时间线还原实际恢复过程
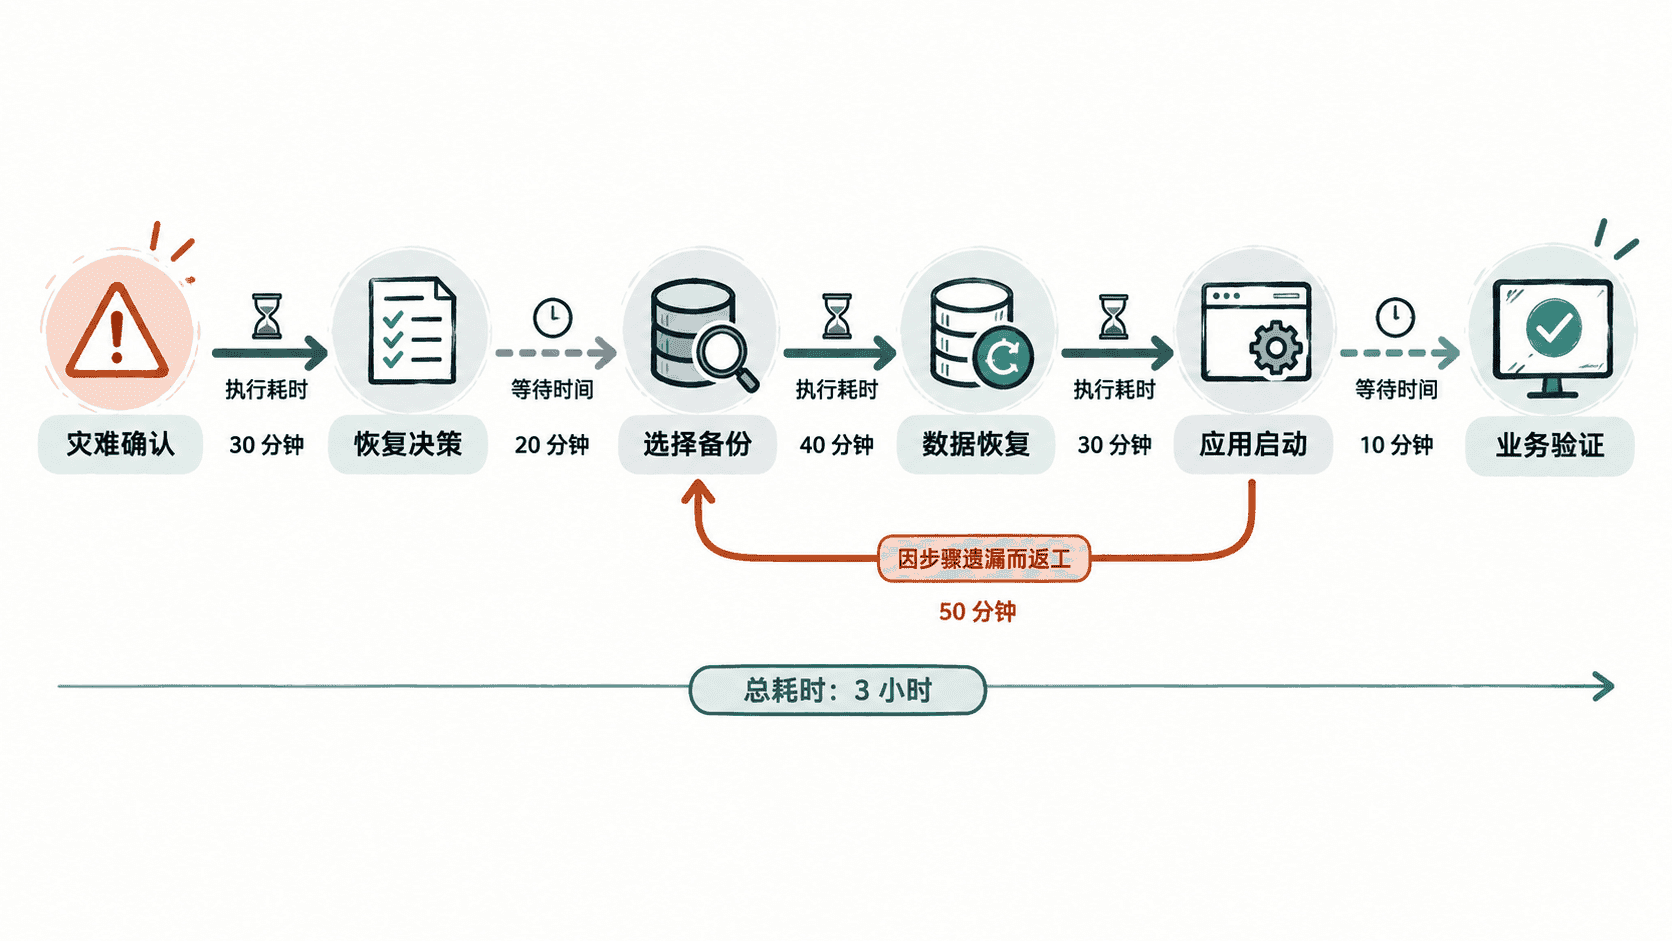
复盘应以演练中的实际记录为准,而不是依赖参与者事后回忆。至少记录故障确认、恢复决策、备份定位、数据恢复、服务启动、业务验证等关键节点,并计算从灾难发生到业务恢复所消耗的时间。
例如把演练事件保存为 recovery-timeline.csv 后,可以先快速查看时间线。以下命令假设文件已经按事件发生顺序记录:
cat recovery-timeline.csv预期输出:
time,event
<TIME>,declare disaster
<TIME>,select backup
<TIME>,restore database
<TIME>,start application
<TIME>,business validation passed
<TIME> 应替换为演练中的真实时间。除了最终恢复耗时,还要关注两个更容易暴露问题的指标:等待时间和返工次数。例如“找不到备份位置等待 12 分钟”通常比“数据库恢复执行 12 分钟”更值得优先改进,因为前者往往可以通过文档或自动化直接消除。
把问题归因到可修改的位置
复盘不能停留在“某一步很慢”。每个异常都应继续追问:下一次演练要修改什么,才能让同类问题不再依赖现场经验解决。
常见问题可以归入三类。Runbook 缺陷包括命令缺失、执行顺序错误、验证条件模糊;备份与恢复能力缺陷包括备份不可用、恢复速度不足、恢复点不符合要求;人工依赖则包括只有某个人知道密钥位置、必须临时询问资源名称或依靠人工判断下一步。
例如,记录“恢复数据库失败一次”还不够。若原因是 Runbook 没写清目标实例必须为空,应把前置检查直接加入步骤;若原因是备份文件损坏,则应改进备份验证机制,而不是只修改恢复文档。
用恢复目标检查结果是否达标
复盘时应把实际恢复结果与组织已经定义的 RTO、RPO 对照。RTO 关注业务中断多久能够恢复,RPO 关注恢复后最多允许损失多少时间范围的数据。
例如目标 RTO 为 60 分钟,而实际恢复用了 82 分钟,就需要继续拆分多出的 22 分钟来自哪里。若实际恢复点比故障发生时间早 25 分钟,而目标 RPO 是 15 分钟,即使服务已经成功启动,这次演练仍暴露了恢复点不达标的问题。
把复盘结果写回 Runbook
Runbook 修改应落到操作者下一次真正会执行的内容,而不是追加一段笼统的“注意事项”。对于每个问题,至少明确触发条件、操作动作和验证结果。
例如原步骤只写“恢复数据库”,演练中却发现操作者不知道应该选择哪个备份。修订后可以要求先列出候选恢复点、确认目标时间,再执行恢复;恢复结束后还必须检查数据库可连接和关键数据时间点。
对高风险步骤,还应补充失败后的停止条件。比如校验失败时禁止继续启动应用,避免错误数据进入后续业务流程。涉及删除、覆盖或切换生产资源的命令,应明确环境、对象和回滚方式。
把改进项变成下一次可验证的动作
复盘最终应形成有负责人、有完成条件的整改项。不要写“优化恢复流程”,而应写成“将备份完整性校验加入每日任务,并在下一次演练前验证一次失败告警”这类能够验收的动作。
可以优先处理会直接导致恢复失败或 RTO、RPO 不达标的问题,再处理降低人工操作和缩短时间的问题。Runbook 更新后,还要让未参与本次演练的人按照新版文档执行一次关键路径;如果对方仍需要口头补充信息,说明文档还没有真正消除隐性依赖。
一次有效的灾难恢复复盘,最终应让“发生了什么、为什么耗时、哪里依赖人工、下次如何验证改进”都有明确答案。只有当演练发现的问题被写入 Runbook、备份策略或自动化任务,并在后续演练中重新验证,复盘才真正完成闭环。