
可观测性与稳定性 / 系统课时
测量实际RTO与数据缺口
测量实际RTO与数据缺口
恢复演练结束后,真正有价值的不是一句“恢复成功”,而是得到可复核的恢复耗时和数据缺口。本节把恢复过程拆成时间节点,计算实际 RTO 与恢复点造成的数据缺失范围,并定位最值得优化的人工和技术步骤。
学习目标
- 能通过演练时间线计算实际 RTO,而不是凭主观估计
- 能根据故障时间与恢复点计算数据缺口,并正确理解它与 RPO 的关系
- 能识别恢复流程中的主要耗时和人工操作点
先定义测量边界
RTO 描述从服务中断到恢复到约定可用状态所经历的时间。演练必须先约定“恢复完成”的判定条件,例如数据库可查询、应用健康检查通过且关键交易读取正常,否则不同演练得到的 RTO 无法直接比较。
数据缺口关注的是恢复后的数据停在什么时间点。假设故障发生于 10:18,而最终只能恢复到 10:13 的状态,那么恢复点与故障点之间相差 5 分钟。这个观测值可用于检查既定 RPO 是否得到满足,但 RPO 本身是目标,不是本次实际丢失量。
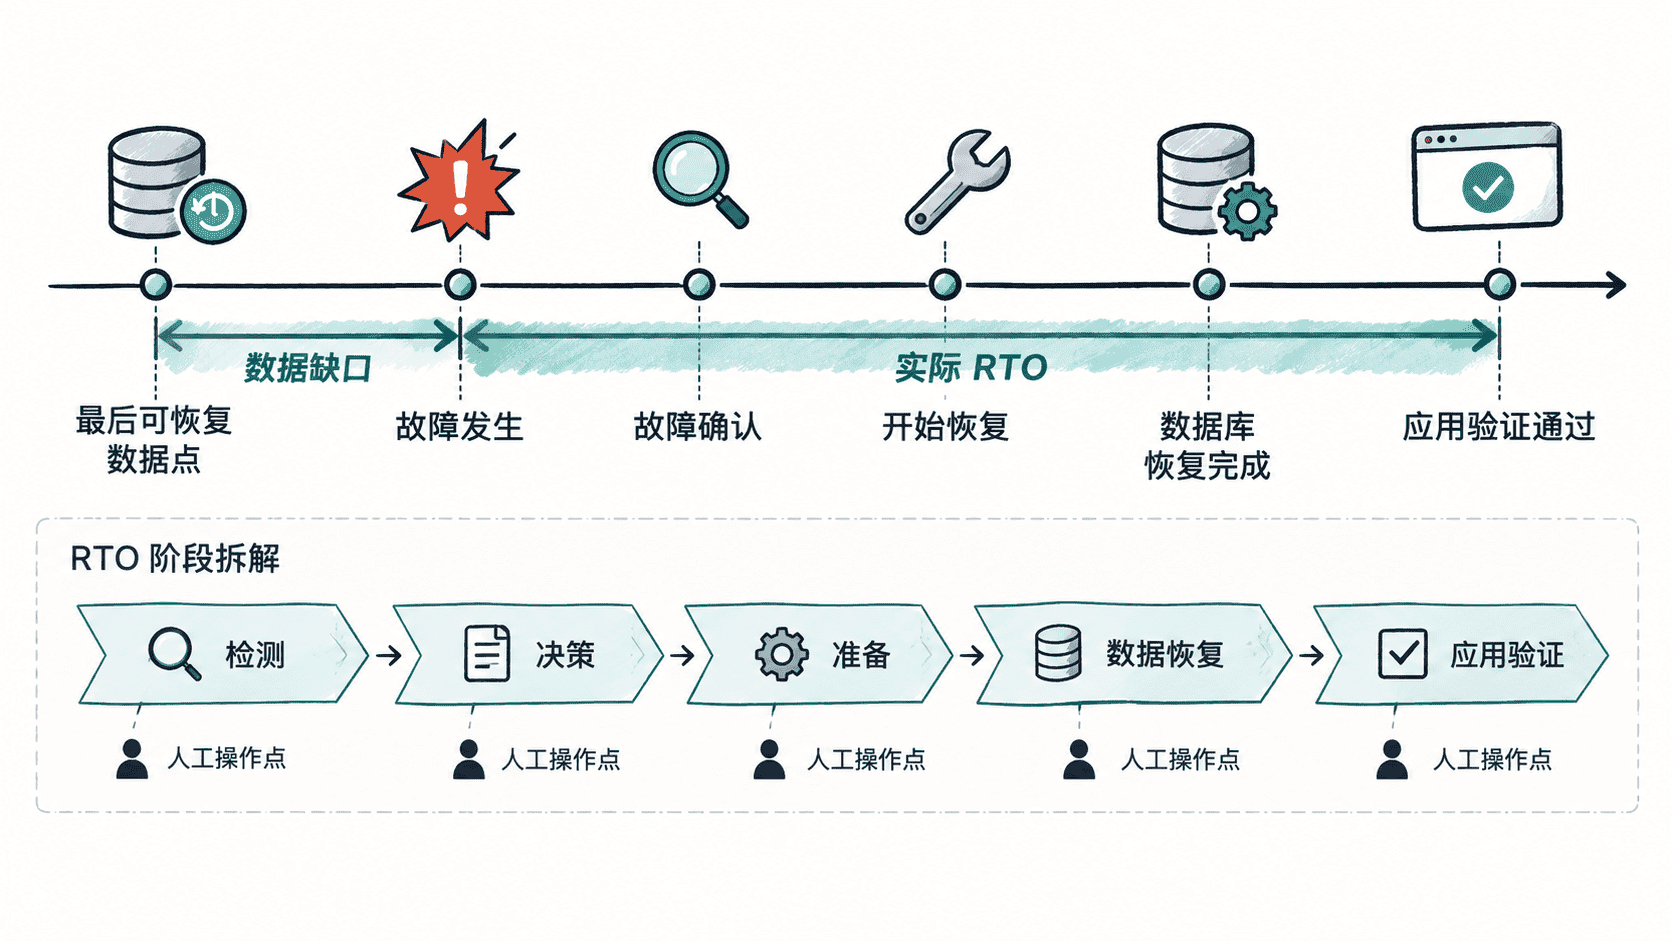
记录恢复时间线
不要只记录总耗时。恢复流程中每个关键事件都应留下时间戳,尤其是需要人工确认、寻找凭据、创建资源和修改应用连接的步骤。可以在演练记录文件中统一使用 UTC 时间,避免跨时区环境产生歧义。
printf '%s %s\n' "$(date -u +%Y-%m-%dT%H:%M:%SZ)" "restore-start" >> recovery-timeline.log
# 执行实际恢复操作后记录下一个里程碑
printf '%s %s\n' "$(date -u +%Y-%m-%dT%H:%M:%SZ)" "database-restored" >> recovery-timeline.log
printf '%s %s\n' "$(date -u +%Y-%m-%dT%H:%M:%SZ)" "application-verified" >> recovery-timeline.log
cat recovery-timeline.log
预期输出
<TIME> restore-start
<TIME> database-restored
<TIME> application-verified
<TIME> 是实际执行时生成的 UTC 时间。真实演练还应记录故障发生和故障确认时间;如果这些事件来自监控平台,应保留其原始时间戳,而不是在演练结束后凭记忆补写。
计算实际指标
假设一次演练记录如下:故障发生 10:18,恢复点 10:13,10:22 开始执行恢复,10:37 数据库完成恢复,10:44 应用验证通过。若约定应用验证通过代表业务恢复,则实际 RTO 为 26 分钟,数据缺口为 5 分钟。
如果既定 RTO 是 30 分钟,这次演练在该条件下满足目标;如果既定 RPO 是 3 分钟,则 5 分钟的数据缺口说明当前备份或日志保护策略没有达到目标。一次演练只能证明当前数据规模、基础设施和操作流程下的结果,不能保证未来故障一定相同。
找出时间花在哪里
总 RTO 达标并不意味着流程已经可靠。应继续拆分检测、决策、资源准备、数据恢复和应用验证耗时。如果 26 分钟中有 10 分钟用于寻找备份位置或等待人工审批,这部分通常比继续优化数据库恢复命令更值得优先处理。
同时标记所有人工操作点,例如选择恢复点、获取凭据、修改连接地址和执行验证查询。人工步骤不一定要全部自动化,但必须有明确负责人、输入条件和失败处理方法,否则真实事故中的压力会放大操作延迟。
用结果修正恢复方案
比较目标与实测值时,应同时保留测试条件,包括备份大小、恢复实例规格、网络带宽、数据量以及是否存在并行操作。条件变化后,历史 RTO 只能作为参考。
如果 RTO 超标,应先针对耗时最长的阶段优化,例如预创建恢复环境、自动化基础设施准备或并行执行验证。如果数据缺口超过 RPO,则应调整备份频率、增量备份或数据库日志保护策略,并再次演练验证。最终记录应让团队能够回答两个问题:业务实际用了多久恢复,以及恢复后的数据究竟停在什么时间点。