
可观测性与稳定性 / 系统课时
磁盘损坏后先保什么
磁盘损坏后先保什么
磁盘或文件系统出现异常时,最危险的动作往往不是“什么都不做”,而是在根因未知时继续写入、反复修复或立即重启。本课建立一套先保护证据和可恢复数据、再决定服务处置方式的顺序,降低故障扩大和覆盖数据的风险。
学习目标
- 根据故障现象判断数据、日志与服务状态的保护优先级
- 识别会造成二次写入或破坏现场的高风险操作
- 使用只读检查获取必要证据,并为后续恢复或取证保留条件
第一原则是减少新的写入
发现 I/O 错误、文件系统转为只读、文件异常消失或磁盘健康告警后,不要把“尽快恢复服务”等同于“立即重启”。数据库、日志系统、临时文件和后台任务都可能持续写盘,使损坏范围扩大,也可能覆盖后续诊断需要的信息。
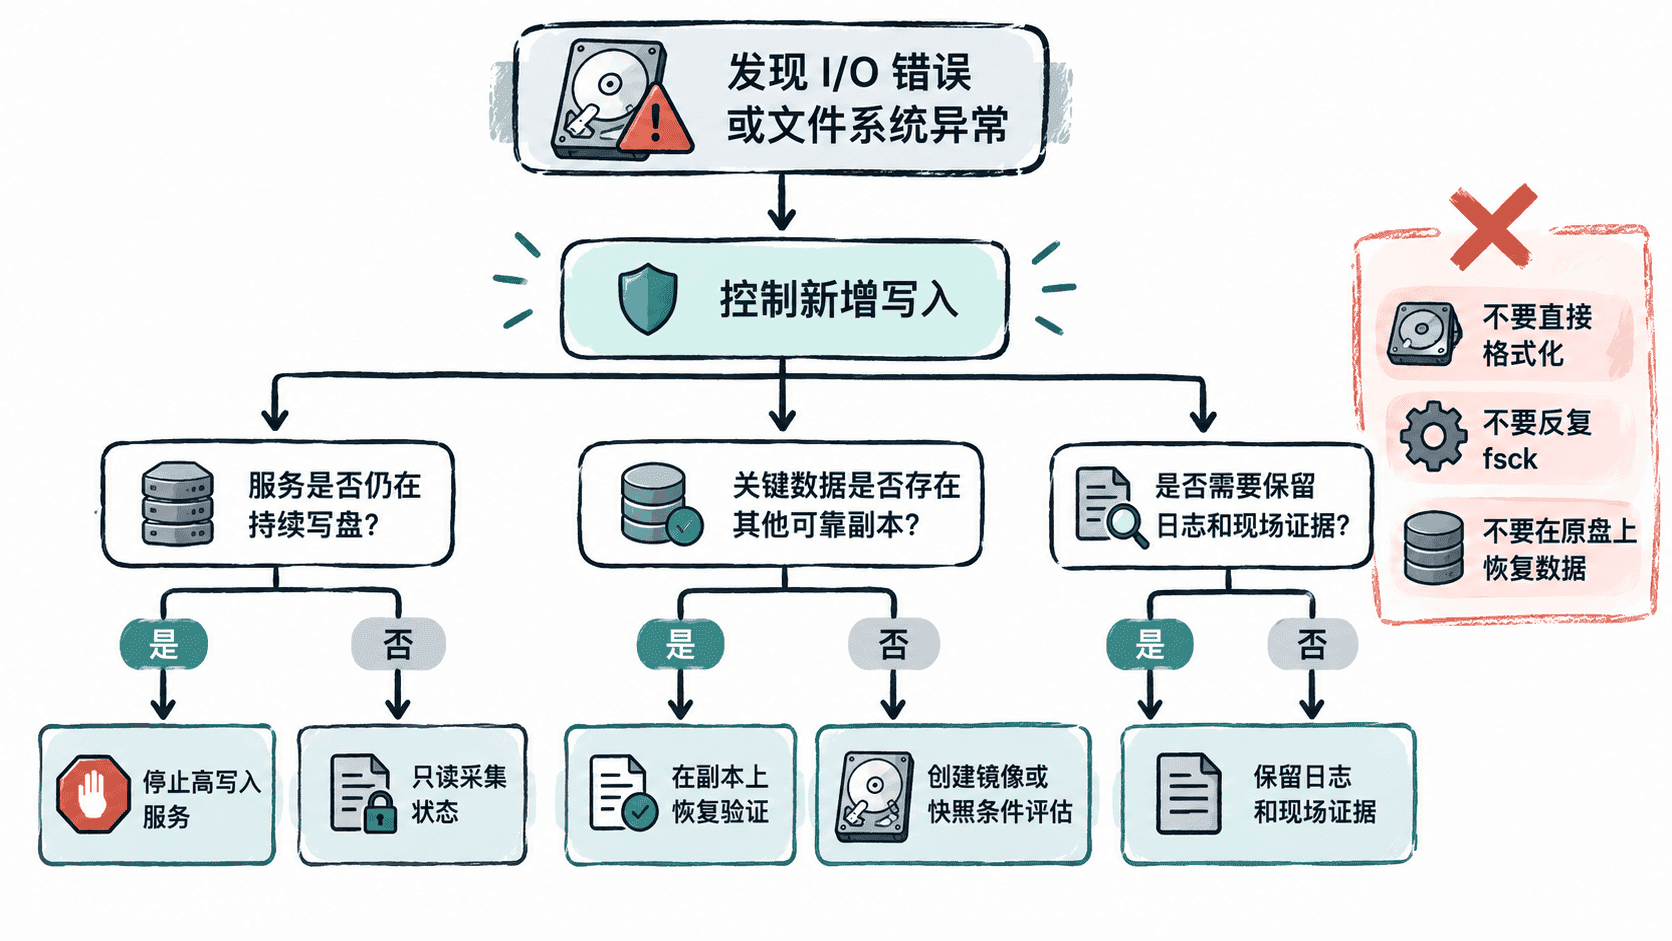
第一步通常是停止非必要写入,或者把业务流量迁离故障节点。是否立即停止服务要结合系统架构判断:如果节点有健康副本,可优先摘流量并停止写入;如果它保存唯一数据,则更应避免未经评估的修复动作。
先采集不会明显改变现场的信息
Linux 主机上可以先读取内核最近报告的磁盘和文件系统错误。下面的命令只用于查看日志,不执行文件系统修复。
sudo dmesg --level=err,warn | tail -n 50预期输出取决于实际故障;存在块设备 I/O 异常时,可能看到类似信息,其中设备名和时间值会不同:
<TIME> blk_update_request: I/O error, dev <DEVICE>, sector <ID>如果没有相关内核告警,命令也可能没有输出,因此不能仅凭这一项排除磁盘问题。还应结合存储控制器告警、云磁盘事件、文件系统状态以及应用日志判断。
数据、日志和服务状态怎么排序
不存在适用于所有事故的固定排序,但可以用“不可替代性”判断。唯一存在于故障盘上的业务数据通常优先于可重新部署的程序文件;能够解释损坏时间和范围的关键日志,则可能决定应该恢复到哪个时间点。
服务运行状态的价值取决于场景。对于无状态服务,进程和本地缓存通常可以舍弃;对于数据库或其他有状态服务,内存中的状态可能帮助诊断,但为了保住它而允许应用持续写入损坏磁盘,往往会增加风险。
已有经过验证的异地副本时,处置空间更大,可以隔离故障节点并从副本重建。如果故障盘包含唯一副本,则重点从“快速恢复在线服务”转向“最大限度保存可恢复数据”,两种场景不能使用同一套动作顺序。
不要在原盘上直接试错
文件系统检查和修复工具可能修改元数据,因此不能把“先跑一次修复看看”作为默认诊断动作。格式化、重新分区、初始化文件系统以及把恢复文件写回同一块故障盘,风险更高。
如果存储条件允许,应优先保留原介质,并在快照、镜像或克隆副本上开展进一步恢复。云盘快照也不是无条件安全按钮:要先确认平台的快照语义、应用一致性要求,以及创建快照是否会影响当前故障设备。
决定什么时候恢复服务
服务恢复应建立在“可恢复数据已经受到保护”之后。至少要确认可靠备份、镜像、快照或健康副本中的一种确实可用,并记录故障发生时间、受影响设备和已执行操作。随后再选择修复文件系统、替换磁盘或重建主机。
重建后不要只检查服务进程是否启动,还要验证关键数据能读取、必要写入能够持久化,并确认日志中没有继续出现 I/O 或文件系统错误。磁盘事故中的核心顺序是:先限制变化,再保存不可替代的信息,最后才在可控副本或新介质上恢复服务。