
可观测性与稳定性 / 系统课时
处理备份失败与空间告警
处理备份失败与空间告警
备份任务失败时,真正困难的不是看到一条红色告警,而是快速判断故障发生在源端、传输链路还是目标端。本课建立一套固定排查顺序,并把磁盘满、权限、网络、锁等待和目标不可用转化为可执行的告警升级路径。
学习目标
- 按固定顺序定位常见备份失败原因
- 区分任务失败、空间不足和持续异常的告警优先级
- 在修复后验证备份链路已经真正恢复
先判断失败发生在哪一段
一条备份链路通常至少包含源数据、备份进程、网络和目标存储。只看“backup failed”很容易直接重跑任务,却掩盖磁盘已经写满、凭据失效或目标端不可达等持续性问题。
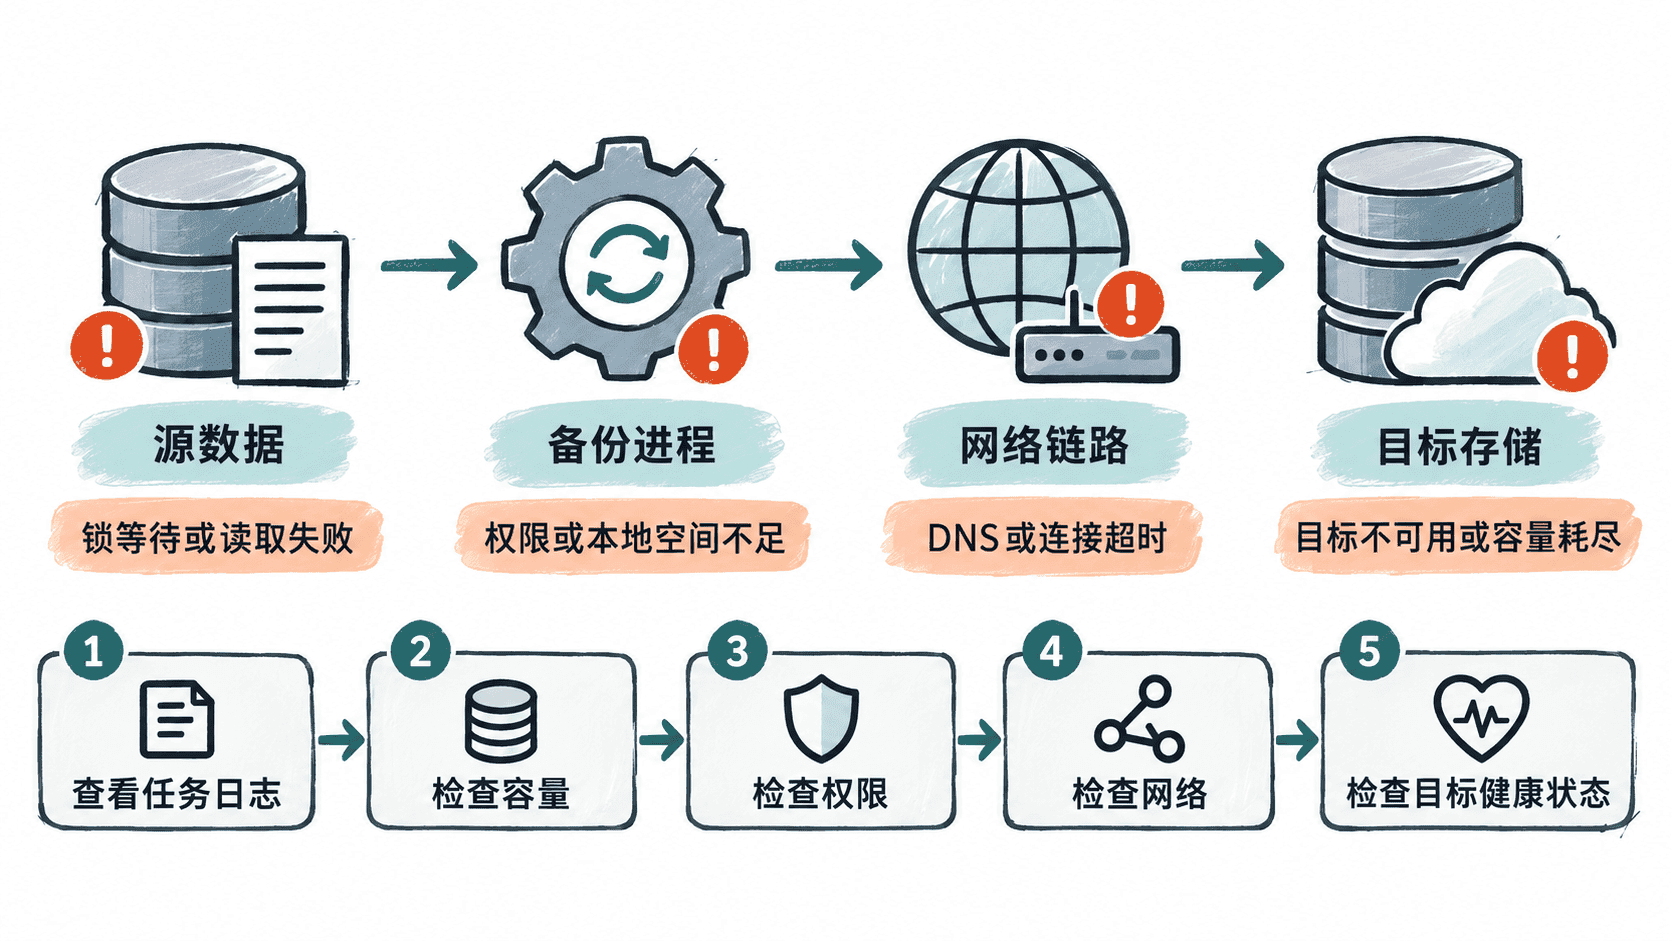
排查时先保存任务的退出码、开始与结束时间以及错误日志,再检查资源状态。这样可以避免任务重跑后覆盖关键现场,也能判断错误是瞬时抖动还是持续故障。
用一组检查快速缩小范围
下面以 Linux 备份节点为例。<PATH> 替换为备份工作目录或目标挂载点;主机名和端口应使用实际备份目标。命令本身不会修改数据,适合先做只读检查。
df -h <PATH>
df -i <PATH>
ls -ld <PATH>
test -w <PATH> && echo writable || echo not-writable
getent hosts backup.example.com
nc -vz backup.example.com <PORT>
预期输出
Filesystem      Size  Used Avail Use% Mounted on
<DEVICE>        <SIZE> <USED> <AVAIL> <PERCENT> <PATH>
Filesystem      Inodes IUsed IFree IUse% Mounted on
<DEVICE>        <INODES> <IUSED> <IFREE> <PERCENT> <PATH>
<PERMISSIONS> <OWNER> <GROUP> <PATH>
writable
<IP> backup.example.com
Connection to backup.example.com <PORT> port [tcp/*] succeeded!
容量、inode、权限、解析和端口都正常,只能说明基础路径可用,不能证明备份业务成功。实际输出中的设备名、容量、百分比、IP 和权限会因环境不同而变化。
如果 df -h 接近满盘而 df -i 正常,重点处理容量;如果 inode 耗尽,即使还有字节空间也可能无法创建新文件。not-writable 则应继续检查运行备份任务的真实用户、目录 ACL、挂载属性以及凭据,而不是直接放宽整个目录权限。
网络检查也要分层。DNS 解析失败和 TCP 连接失败不是同一种问题;端口可连接但备份仍失败时,再检查认证、远端配额、对象存储权限或服务端错误。
识别锁等待和目标不可用
数据库备份可能因为长事务、元数据锁、快照冲突或备份工具自身互斥锁而等待。此时任务进程仍存在,不代表它在有效推进。监控应同时观察任务持续时间、输出文件增长或已处理数据量,超过历史合理区间后再告警。
目标不可用则常表现为连接超时、认证失败、远端只读、配额耗尽或服务返回错误。此类问题不要无限自动重试:短暂网络抖动可以有限次数重试,而认证失败、空间耗尽等确定性错误应尽快升级给责任人。
让告警表达可执行的信息
一个有效的备份告警至少应携带任务名称、数据源、目标位置、最近成功时间、失败时间、错误类别和日志入口。仅发送“备份失败”会让值班人员重新收集上下文,延长恢复时间。
告警可以按影响逐级升级:单次瞬时失败先进入低级别通知并触发有限重试;连续失败或超过备份窗口时升级;剩余空间逼近安全阈值时提前预警;已经无法写入、连续多个恢复点缺失或超过允许的数据丢失窗口时进入高优先级处置。
空间阈值不要只设置一个百分比。容量很大的存储即使剩余 10% 仍可能足够数天,而小卷剩余 10% 可能几个小时就写满。更可靠的做法是同时考虑剩余字节数和近期增长速度,为清理、扩容或迁移预留时间。
修复后验证完整链路
故障解除后不能以“告警消失”作为结束条件。应重新执行一次受控备份,确认任务返回成功状态,并检查新备份对象确实生成、大小合理且校验信息可读取。关键系统还应继续执行一次恢复抽样,证明产物不是只有文件名存在。
告警系统也需要验证状态恢复:失败事件应关闭或恢复为正常,最近成功时间必须推进到新的时间点。如果任务重跑成功但监控仍显示旧状态,应修复指标采集或告警状态,而不是人工忽略告警。
稳定的处理路径应形成闭环:发现异常 → 保留现场 → 分层定位 → 修复根因 → 重跑备份 → 验证产物 → 恢复监控状态。这样处理的是备份能力本身,而不只是消除一条错误消息。