
可观测性与稳定性 / 系统课时
模拟生产节点完全丢失
模拟生产节点完全丢失
灾难恢复演练不能只测试“文件还能不能解压”,而要模拟原生产节点已经无法登录、无法修复的情况。本节从宣布节点失效开始,冻结业务变更、记录恢复基线,并按 Runbook 建立清晰的恢复边界,为后续重建提供可信起点。
学习目标
- 能构造不破坏真实生产数据的节点完全丢失场景
- 能在恢复开始前冻结变更并保存故障与恢复基线
- 能按照 Runbook 的阶段顺序启动灾难恢复流程
定义这次灾难的边界
“节点完全丢失”意味着恢复人员不能依赖原节点上的磁盘、配置文件、缓存或人工修改记录。演练时不必真的销毁服务器,可以把目标主机从恢复流程中隔离,并明确规定:从这一刻起,所有恢复材料只能来自外部备份、配置仓库、密钥系统和资产记录。
需要先记录灾难声明时间 <TIME>、受影响服务、原节点标识以及最后确认可用的备份点。动态时间和节点 ID 以实际环境为准。
printf 'disaster_declared_at=%s\naffected_service=%s\nlost_node=%s\n' \
  '<TIME>' 'orders-api' '<ID>' > recovery-baseline.txt
cat recovery-baseline.txt
预期输出
disaster_declared_at=<TIME>
affected_service=orders-api
lost_node=<ID>
这个文件不是备份本身,而是本次演练的恢复基线。真实环境还应把它保存到故障工单、事件系统或其他不会随故障节点一起丢失的位置。
冻结变更再开始恢复
灾难发生后继续发布应用、修改数据库结构或轮换配置,会让“备份时状态”和“当前期望状态”不断漂移。恢复负责人应先建立变更冻结:暂停常规部署和配置修改,只允许经过记录的恢复操作进入环境。
冻结后至少确认三类信息:当前对外流量是否已经隔离故障节点;恢复期间谁有权修改基础设施和数据;选择哪个恢复点作为本次恢复输入。若这些条件没有确定,后续即使成功启动服务,也难以证明恢复结果对应哪个时间点。
按 Runbook 启动恢复
完整灾难恢复通常包含故障确认、变更冻结、恢复点选择、环境重建、数据恢复、服务验证和流量恢复。多个角色和阶段存在依赖关系,用流程图能更清楚地看到什么时候允许进入下一阶段。
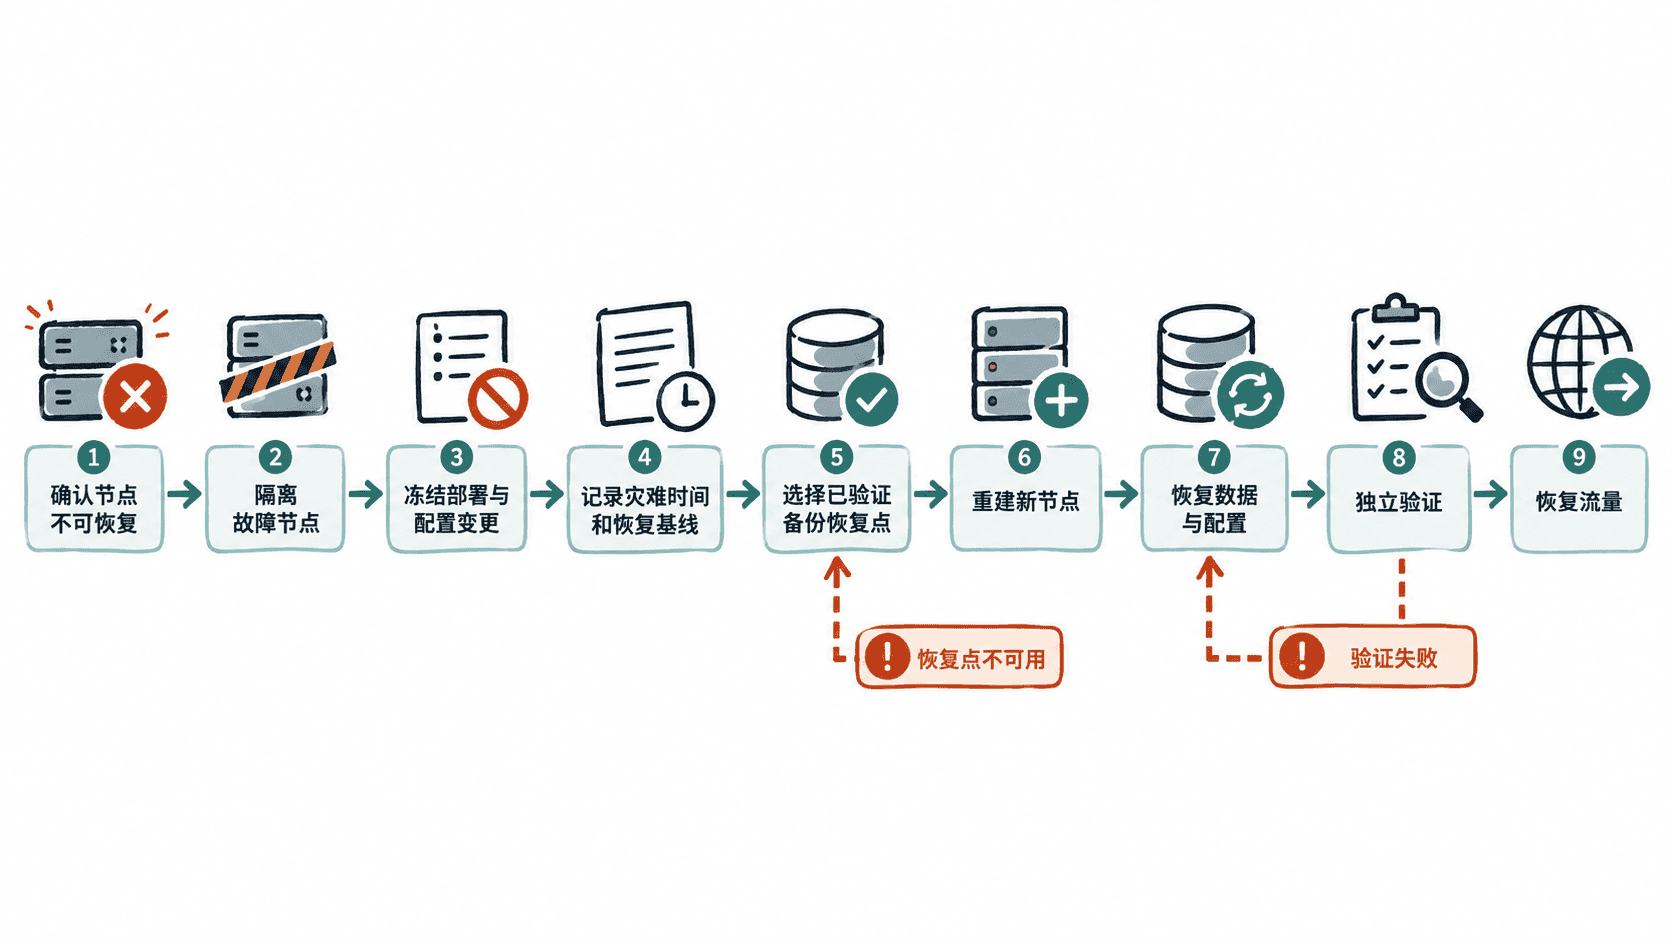
Runbook 的关键不是把命令排列在一起,而是定义每一步的进入条件和退出条件。例如,“开始重建节点”的进入条件应包括恢复点已经确定、目标环境已经隔离;退出条件则是新节点能够进入下一阶段的数据和服务恢复。
验证演练真的进入灾难状态
开始重建前,应做一次反向检查:恢复人员是否仍在无意中读取旧节点上的文件。如果某个关键配置只有登录旧主机后才能找到,这次演练已经暴露出备份范围或配置管理缺口,应记录问题,而不是临时复制后假装恢复流程完整。
还要确认恢复所需的备份存储、配置仓库和凭据系统能够从独立管理路径访问。真正的节点级灾难中,与原节点绑定的本地脚本、SSH 私钥或未同步配置都不能视为可靠恢复来源。
演练进入下一阶段的标准应很明确:原节点被视为不可用,变更已经冻结,恢复点已经选定,所有后续动作都有记录。做到这一点,接下来的环境重建才是在验证灾难恢复能力,而不是修复原机器。