
可观测性与稳定性 / 系统课时
监控备份是否真的按时产生
监控备份是否真的按时产生
备份任务显示“运行正常”仍可能留下保护空窗,例如调度器没有触发、上传失败或最近一次成功备份已经过期。本篇把备份监控转换为几个可计算信号,用最后成功时间、备份年龄、任务结果和目标容量及时发现失效的数据保护链路。
学习目标
- 区分任务执行成功与备份持续有效
- 使用最后成功时间和备份年龄检测漏备份
- 同时监控失败状态、产物新鲜度与目标容量
不要只盯着任务退出码
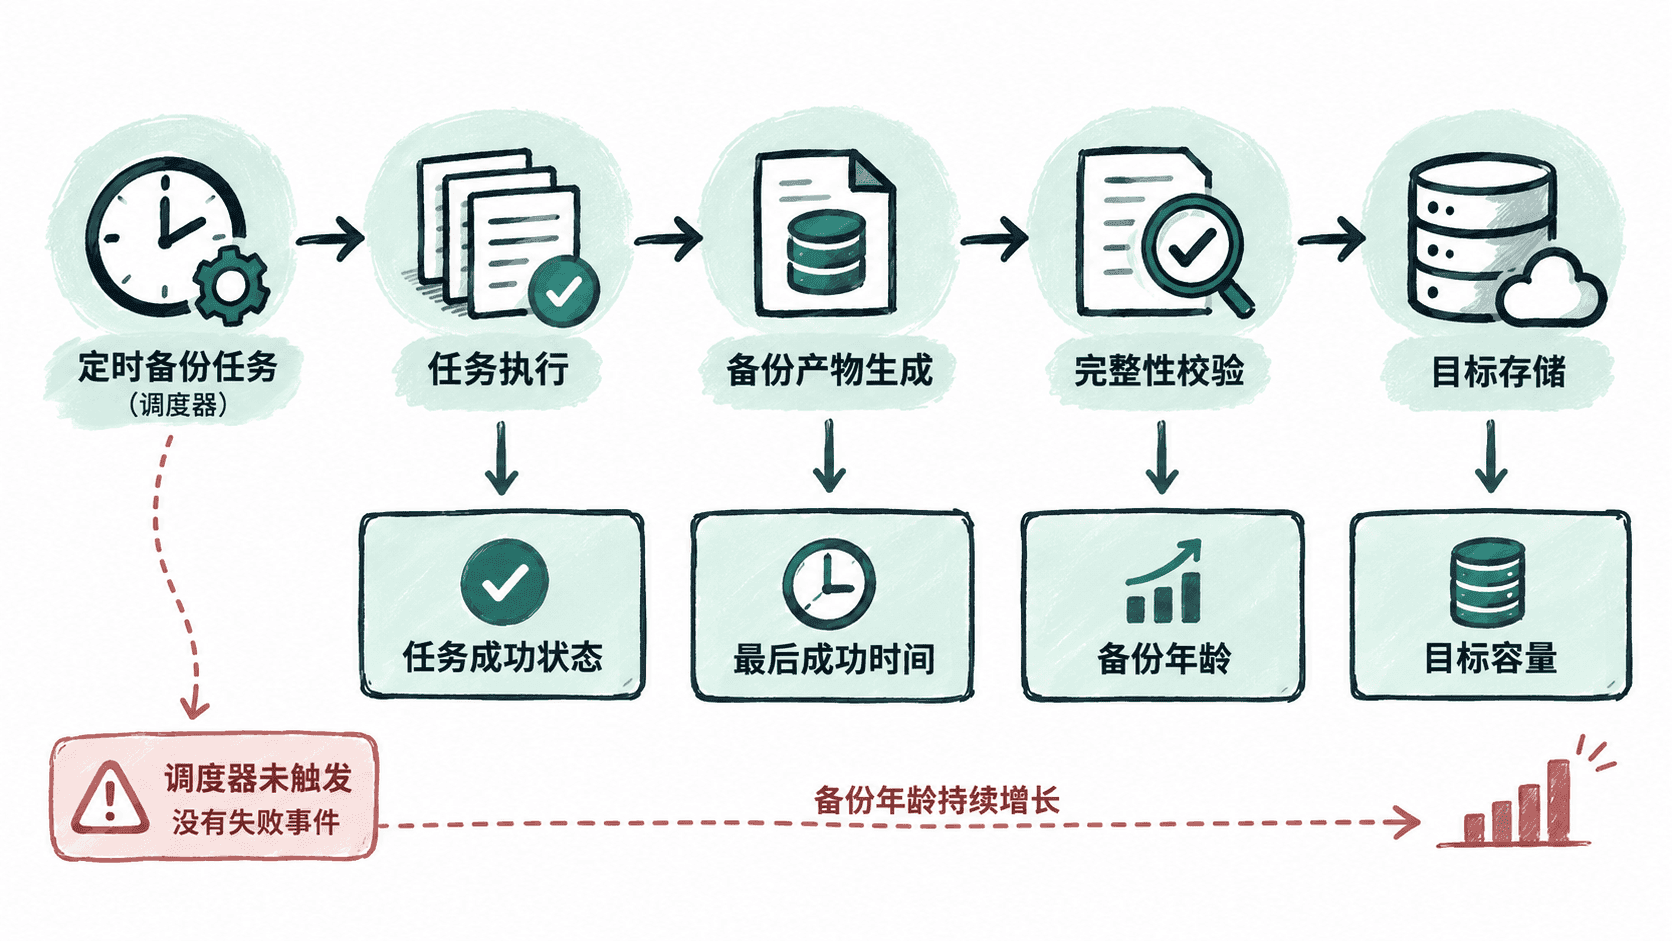
假设系统要求每 24 小时至少产生一次有效备份。如果只监控“最近一次任务是否成功”,调度器停止运行时甚至不会产生失败记录;如果只检查文件是否存在,一个三天前的旧备份也可能被误判为正常。
更可靠的监控至少包含四类信号:最近任务是否成功、最后一次成功备份的时间、当前时间距离该时间有多久,以及备份目标是否还有足够容量。对于需要完整性校验的系统,“成功备份”还应限定为产物生成、传输和校验全部通过。
用时间戳监控备份年龄
一个通用做法是在备份通过校验后写入“最后成功时间”的 Unix 时间戳。以下示例用文本文件演示,生产环境通常会把同类值暴露为监控指标。
set -euo pipefail

STATE_FILE="/var/lib/backup-monitor/last-success"
MAX_AGE_SECONDS=90000

LAST_SUCCESS="$(cat "$STATE_FILE")"
NOW="$(date +%s)"
AGE_SECONDS="$((NOW - LAST_SUCCESS))"

printf 'backup_age_seconds=%s\n' "$AGE_SECONDS"

if [ "$AGE_SECONDS" -gt "$MAX_AGE_SECONDS" ]; then
  echo "CRITICAL: backup is stale"
  exit 2
fi

echo "OK: backup is fresh"
当最后成功备份仍在允许窗口内时,预期输出中的秒数取决于实际时间:
backup_age_seconds=<AGE>
OK: backup is fresh
如果超过 90000 秒,则预期结果为:
backup_age_seconds=<AGE>
CRITICAL: backup is stale
这里把阈值设为 25 小时,而不是精确的 24 小时,是为了给正常调度和执行耗时留出余量。实际阈值应根据备份周期、最长正常耗时和业务允许的恢复点目标确定。
把信号转换成可告警指标
若监控系统支持自定义指标,可以暴露 backup_last_success_timestamp_seconds、backup_last_run_success、backup_size_bytes 和目标存储可用空间。最关键的是最后成功时间,因为它能覆盖“任务根本没运行”这种没有失败事件的情况。
以 Prometheus 表达式为例,若要求成功备份年龄不得超过 25 小时,可以计算当前时间与最后成功时间的差值:
time() - backup_last_success_timestamp_seconds > 25 * 60 * 60预期结果:条件为真时返回超过阈值的时间序列,可据此触发“备份过期”告警;条件为假时不会返回对应序列。指标名是本篇示例约定,实际部署时应与备份程序暴露的指标保持一致。
容量异常也会让备份悄悄失效
目标容量应与新鲜度一起监控。磁盘或对象存储配额逼近上限时,下一次备份可能无法完成;备份大小突然显著下降,也可能意味着数据范围、过滤规则或导出过程发生异常。
容量告警不要只设置一个“磁盘已满”阈值。至少应确保剩余空间足以容纳下一次备份及必要的临时空间,并观察备份大小的趋势。对于增量备份,大小波动本身可能正常,应结合备份类型建立基线,避免机械比较相邻两次文件大小。
真正有效的备份监控最终关注的是“当前是否存在足够新的、经过校验且能够定位的恢复点”。任务状态负责解释执行故障,备份年龄发现保护空窗,容量信号提前暴露存储风险;三者结合,才能避免把一个仍在运行的定时任务误认为可靠的数据保护。