
可观测性与稳定性 / 系统课时
处理演练中暴露的断点
处理演练中暴露的断点
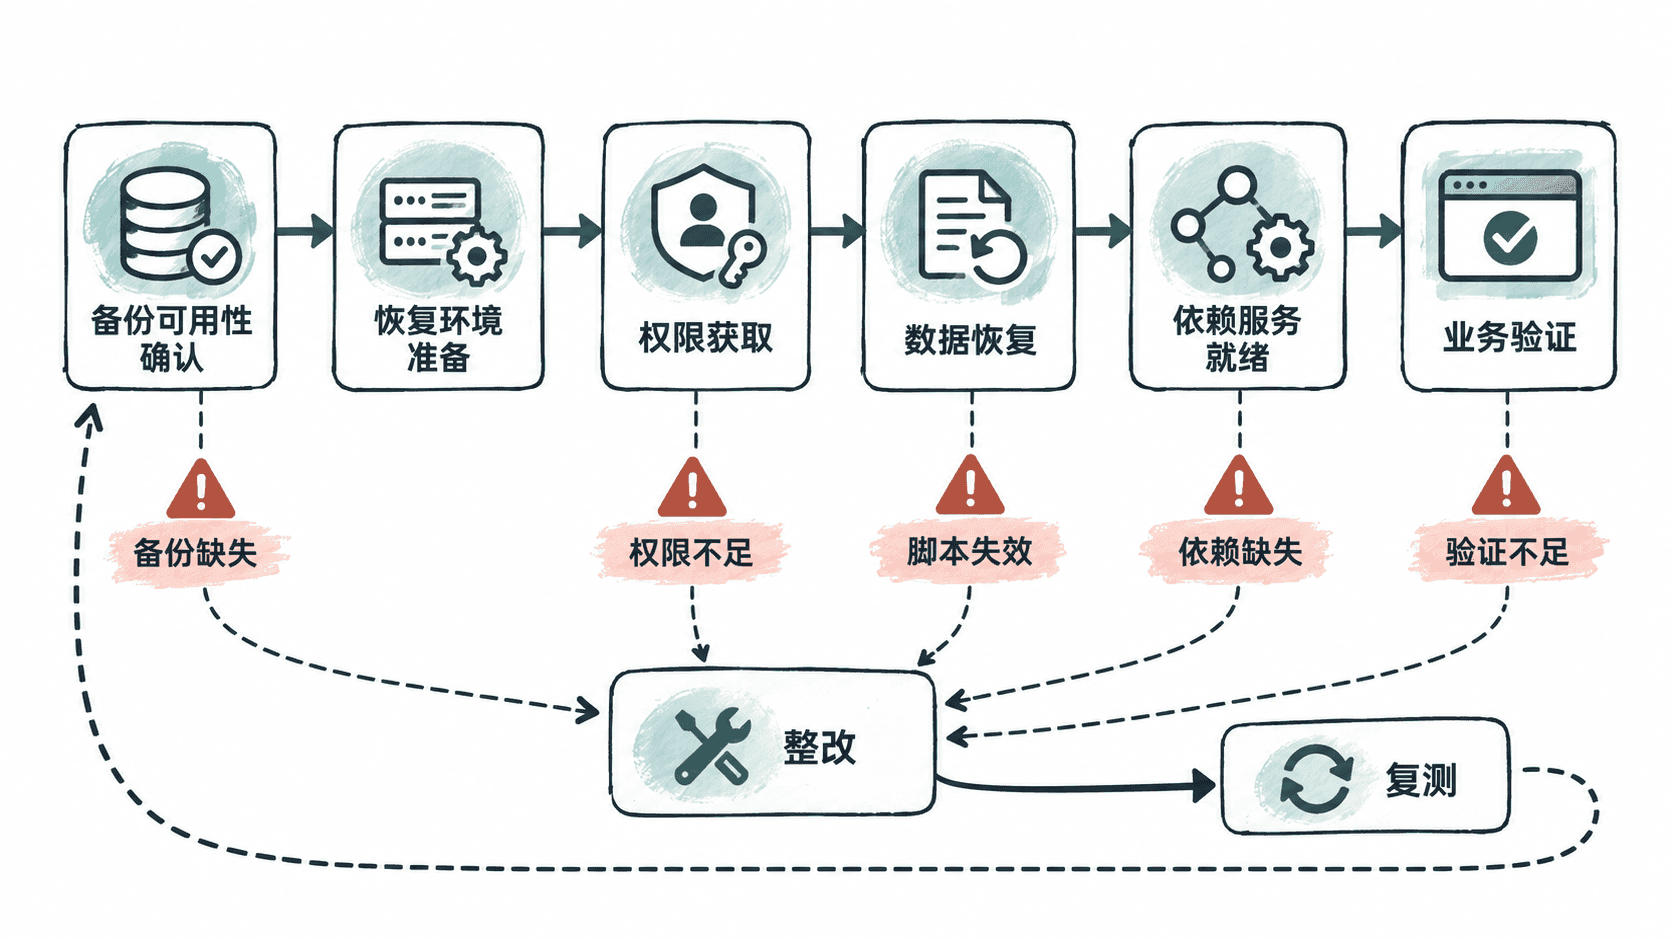
恢复演练真正有价值的结果不是“成功恢复一次”,而是找出生产事故中可能让恢复停住的断点。缺备份、权限不足、脚本失效、依赖遗漏和验证不完整,都应转化为可跟踪、可复测的改进项,而不是留在演练记录里。
学习目标
- 按恢复链路定位演练中的真实断点,而不是只记录最终失败现象
- 区分备份、权限、自动化、依赖和验证问题,并确定修复优先级
- 把改进项落实到责任人、验证方法和下一次复测中
从失败位置还原恢复链路
演练失败后,先记录“在哪一步停住”,再分析为什么。一个典型恢复链路会经过备份可用性确认、恢复环境准备、权限获取、数据恢复、服务启动和业务验证。只记录“恢复失败”无法指导改进,因为多个环节都可能产生相同结果。
演练时可以建立一份事件记录,把命令、时间和失败现象保存下来。下面的示例用于确认某个预期备份文件是否实际存在,并同时检查其基本属性。
BACKUP_FILE="<PATH>"
if test -r "$BACKUP_FILE"; then
  stat "$BACKUP_FILE"
else
  echo "BACKUP_UNAVAILABLE: $BACKUP_FILE"
  exit 1
fi
预期输出(文件存在且可读时,时间、大小等实际值可能不同):
  File: <PATH>
  Size: <SIZE> ...
如果得到 BACKUP_UNAVAILABLE,恢复流程就不应继续假装执行成功。此时需要进一步确认是备份任务没有生成文件、保留策略已经删除文件、路径记录错误,还是当前恢复账号没有读取权限。
把断点归到可处理的问题
缺备份是最高优先级问题之一。除了修复备份任务,还应验证恢复所需的时间点、保留周期和副本位置是否真正覆盖灾难场景。备份任务显示成功,并不等于目标恢复点一定存在且可读。
缺权限通常表现为恢复账号无法读取备份、挂载存储、创建目录或启动服务。改进重点不是临时给管理员权限,而是明确灾难恢复角色所需的最小权限,并提前准备可审计的紧急授权流程。
缺脚本包括恢复步骤完全依赖人工记忆,也包括脚本已经存在但参数、路径或环境假设过期。关键步骤应自动化;暂时不能自动化的步骤,也必须写清输入、操作、成功判据和失败处理。
缺依赖常在主服务恢复后暴露,例如数据库已经启动,但 DNS、密钥、证书、配置中心或下游服务尚未恢复。恢复清单因此必须描述服务依赖,而不能只列机器和数据文件。
验证不足最容易造成“技术上恢复了,业务仍不可用”。进程存活、端口监听只能证明基础状态,还要验证关键读写路径、数据时间点和必要的外部依赖。
把发现变成改进项
每个断点至少应留下四项信息:根因、修复动作、责任人和复测条件。不要用“优化恢复流程”这种无法验收的描述,而要写成可以明确判定完成与否的任务,例如“为恢复账号补充对象存储只读权限,并在隔离环境重新下载最近一个备份”。
优先级应结合两件事判断:这个断点是否会直接阻止恢复,以及它发生后是否存在可靠替代路径。完全没有可用备份通常比一个可以手工替代的自动化脚本故障更紧急;同样,只有单人掌握的关键凭据流程也应尽快消除单点依赖。
用复测关闭问题
修复完成不等于问题关闭。真正的关闭条件是按照正式恢复流程重新执行相关步骤,并获得可验证结果。权限问题要由恢复角色重新操作,脚本问题要从干净环境执行,备份问题则要实际读取或恢复目标副本。
对于影响完整恢复链路的修改,局部复测通过后还应安排一次端到端演练,确认一个修复没有引入新的顺序或依赖问题。最终留下的不是一张“问题已处理”表,而是一条已经通过演练证明可执行的恢复路径。