
可观测性与稳定性 / 系统课时
理解物理备份恢复路径
理解物理备份恢复路径
数据库规模增大后,逐表导出再导入往往恢复太慢。物理备份直接保存数据库的数据文件,并结合事务日志或归档日志把数据推进到一致状态,适合需要缩短大规模数据库恢复时间的场景。
学习目标
- 理解基础物理备份与事务日志在恢复过程中的分工
- 能按“恢复基础数据,再重放日志”的路径理解恢复过程
- 判断物理备份更适合哪些恢复规模与目标
物理备份保存的是什么
逻辑备份保存 SQL、表数据等逻辑对象,而物理备份面向数据库实际使用的数据文件、控制信息及相关存储结构。恢复时通常不需要重新执行海量建表和插入操作,而是先还原一份可供数据库引擎识别的数据副本。
但数据文件副本并不天然等于某一时刻的一致数据库。在线备份期间,业务仍可能持续修改数据,不同数据页被复制时对应的时间点也可能不同。因此,成熟的物理备份机制通常还要依赖 WAL、redo log 等事务日志完成一致性恢复。
恢复为什么需要日志
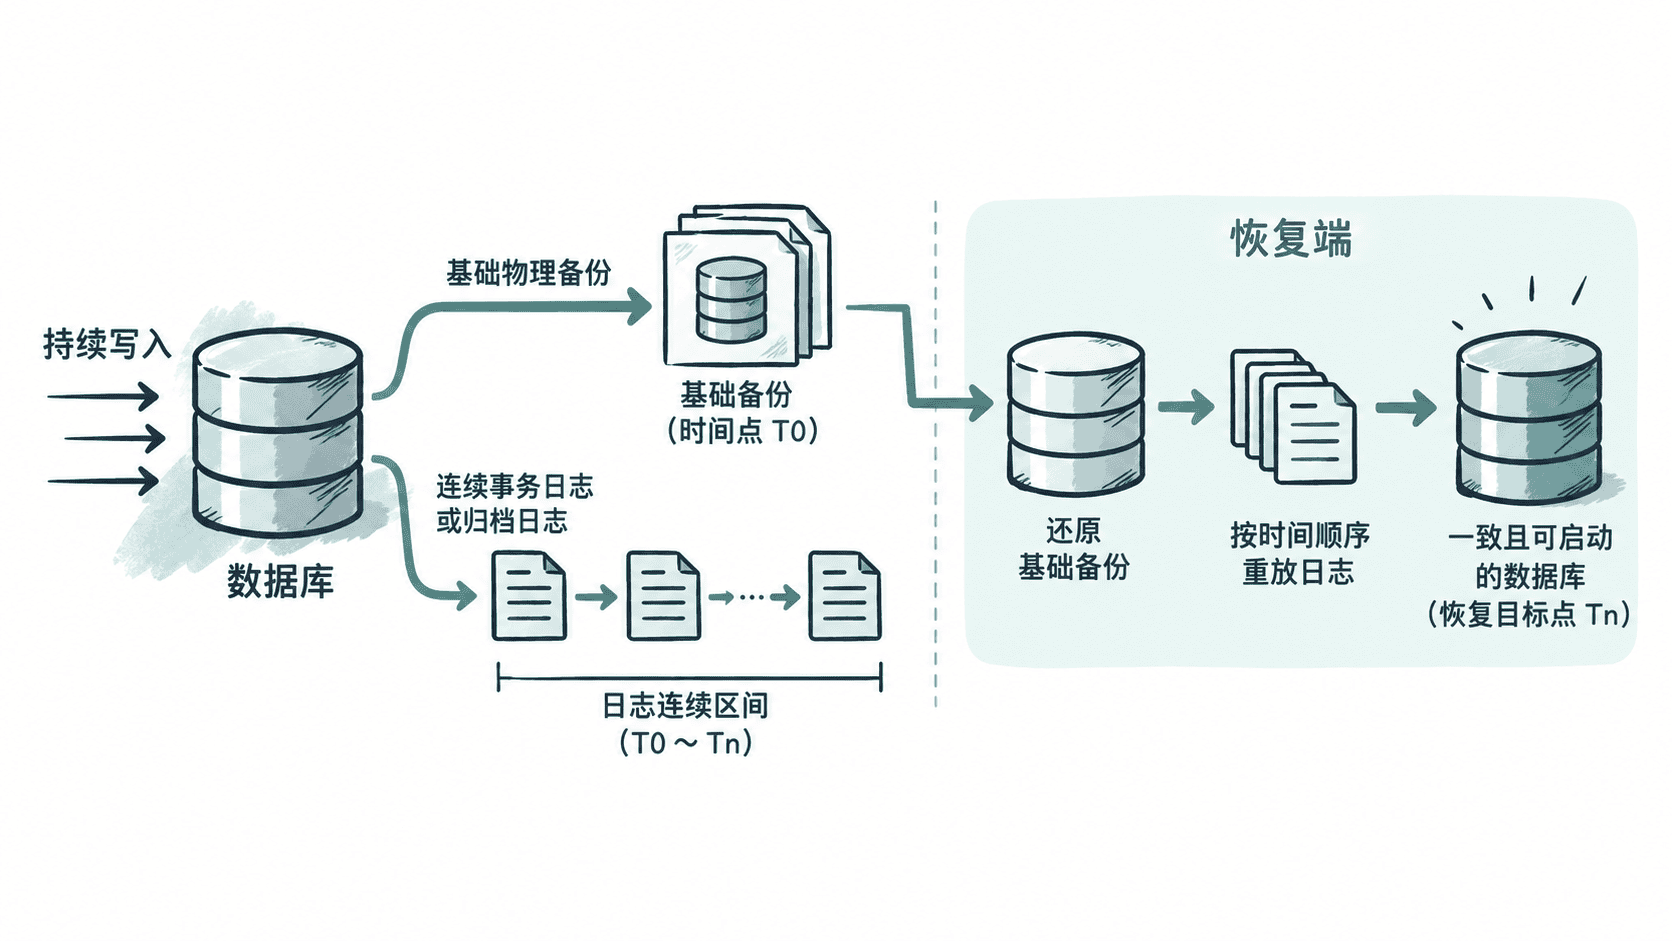
假设基础备份记录了数据库在某个时间范围内复制出的数据页,而备份开始以后又发生了新的事务。恢复程序需要读取事务日志,把基础数据推进到一个合法的一致点;如果日志保存得更久,还可以继续推进到更晚的恢复目标。
可以把恢复链理解为:基础备份提供大块数据,事务日志提供基础备份之后的变化。两者必须能够衔接,日志中间出现缺口时,即使基础备份文件本身完整,也可能无法达到预期恢复点。
以 PostgreSQL 为例,可以先用 pg_basebackup 创建基础备份,同时要求服务器具备正确的复制与 WAL 配置。下面命令演示从已配置好复制权限的数据库获取基础备份;<HOST>、<PORT> 与 <PATH> 需要替换为实际值。
pg_basebackup -h <HOST> -p <PORT> -U replicator -D <PATH> -Fp -Xs -P预期输出
<PROGRESS>% (<BYTES>/<BYTES> kB), <TABLESPACE>/1 tablespace进度数字取决于数据库大小和运行环境;命令成功退出后,<PATH> 中应形成基础备份。这里的 -Xs 会在备份过程中流式包含所需 WAL,但长期的时间点恢复仍需要独立、连续的 WAL 归档策略。
一条完整恢复链怎样形成
实际灾难恢复通常从“选择哪份基础备份”开始,而不是简单寻找最新目录。恢复目标确定后,需要找到目标点之前可用的基础备份,并确认从该备份到目标点之间所需日志连续存在。
恢复顺序通常是:停止向目标实例写入,准备干净的数据目录,还原基础备份,配置日志来源和恢复目标,再启动数据库让引擎执行日志重放。数据库完成崩溃恢复或时间点恢复后,还要进行业务级校验,而不能仅以进程启动成功作为验收标准。
什么时候优先考虑物理恢复
物理备份的优势通常出现在数据量较大、恢复时间要求较紧,或者需要依靠事务日志进行时间点恢复时。它能避免逐对象重建大量数据,但也更依赖数据库版本、存储格式以及日志链的完整性。
如果目标只是迁移少量表、恢复单个逻辑对象或跨版本重组数据,逻辑备份往往更灵活。若目标是整库快速重建,则应重点测量“基础备份还原时间 + 日志重放时间”,并确认现有归档保留周期能够覆盖计划中的恢复目标。