
可观测性与稳定性 / 系统课时
先恢复基础设施还是数据
先恢复基础设施还是数据
灾难恢复不是把所有备份同时还原得越快越好。数据库依赖存储和网络,应用又依赖数据库、缓存或消息系统;顺序错误会制造连接失败、重复重试和无效等待。本课用依赖关系确定恢复顺序,并通过逐层验证建立可执行的恢复链路。
学习目标
- 根据服务依赖而不是主观优先级确定恢复顺序
- 理解网络、存储、数据服务和应用层之间的恢复门槛
- 在每一层设置验证点,避免故障向上层扩散
恢复顺序来自依赖关系
判断“基础设施还是数据先恢复”时,不能简单规定所有环境都先恢复基础设施或先恢复数据库。真正的规则是:先恢复当前对象赖以运行的条件,再恢复对象本身。
典型 Web 系统中,数据库的数据文件需要可用存储,数据库进程需要主机、网络和名称解析,应用又需要数据库达到可接受的恢复点。因此常见顺序是基础计算与网络 → 存储 → 数据库等有状态服务 → 应用依赖 → 应用实例 → 流量入口。
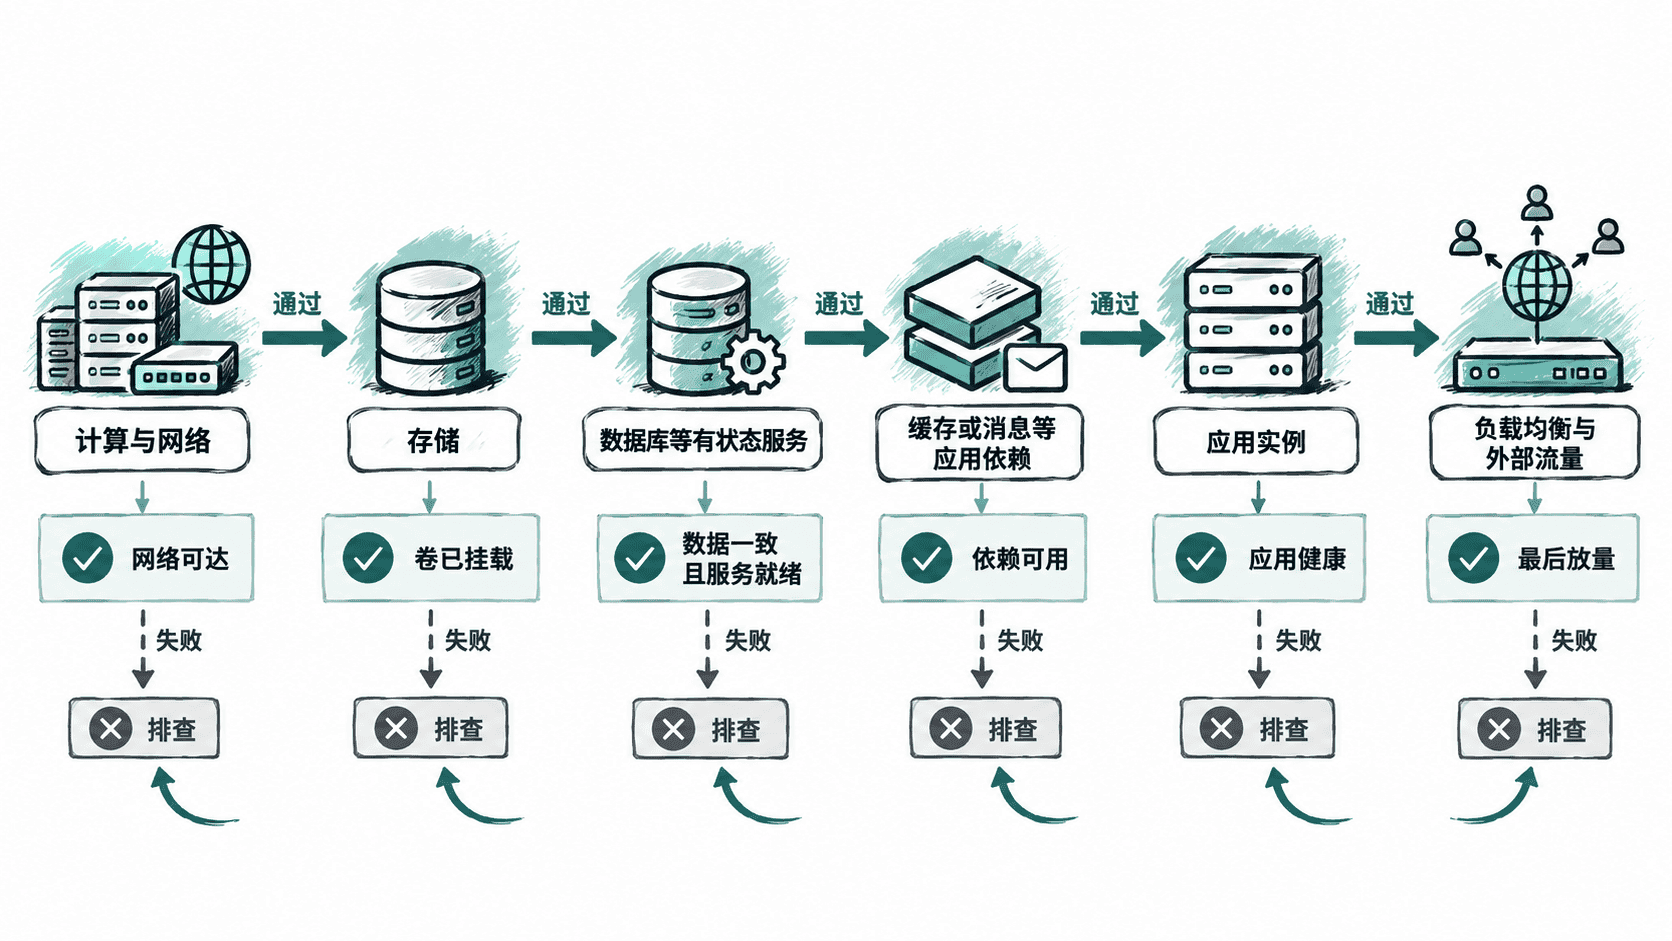
这里的“基础设施”也不是一个必须全部完成的大阶段。如果某个非关键网络与当前恢复链路无关,没有必要等待它。应围绕关键业务的最短依赖路径恢复,而不是等整个数据中心的所有组件都恢复后才开始数据库工作。
数据恢复之前先满足承载条件
数据库备份通常不能恢复到一个尚不存在或状态不确定的目标环境。开始还原前,应确认目标主机或实例可运行、目标存储容量足够、文件系统已经正确挂载,并且恢复节点能够访问备份源。
网络也要恢复到“够用”而非“全部完成”。例如数据库恢复节点只需要先具备访问对象存储、DNS 和必要管理端点的路径;面向用户的负载均衡可以稍后恢复,避免尚未完成校验的应用提前接收生产请求。
数据层恢复后设置验证门
数据文件恢复完成并不表示数据库已经可以供应用使用。还需要确认恢复点、数据库进程状态以及应用真正使用的访问路径。以 PostgreSQL 为例,可以在数据库恢复并启动后执行一个最小连接验证。
psql "host=<HOST> port=<PORT> dbname=<DATABASE> user=<USER>" \
  -c 'SELECT current_database(), pg_is_in_recovery();'
预期输出
 current_database | pg_is_in_recovery
------------------+-------------------
 <DATABASE>       | <RECOVERY_STATE>
(1 row)<HOST>、<PORT>、<DATABASE>、<USER> 和 <RECOVERY_STATE> 应替换或核对为实际环境值。命令成功只能证明数据库连接和查询路径可用;是否已经达到要求的恢复时间点,还必须依据所采用的备份与时间点恢复方案单独验证。
对于缓存、消息队列等组件,也要区分“进程启动”和“业务可用”。如果它们保存不可丢失状态,就按有状态服务执行恢复和一致性检查;如果数据可由数据库或上游重新生成,则可以在数据库之后重新创建,从而缩短关键恢复路径。
应用最后启动,流量最后放开
数据层及必要依赖通过验证后,再启动应用。此时应先让应用在不承接外部生产流量的状态下完成数据库连接、迁移兼容性和内部健康检查,确认它使用的是刚恢复的正确环境。
如果应用启动会自动执行数据库迁移、消费积压消息或运行定时任务,需要在恢复方案中明确控制这些行为。灾难恢复期间,自动化动作可能改变刚刚恢复的数据,因此不能仅凭“应用能启动”就立即解除流量隔离。
最后再恢复负载均衡、DNS 切换或其他流量入口,并逐步观察错误率和关键业务检查结果。这样即使应用层验证失败,也可以在没有真实用户请求干扰的情况下继续修复。
用依赖链处理例外情况
恢复顺序不是固定的产品清单,而是一张依赖图。例如备份文件存放在需要身份认证的对象存储中,那么身份服务或临时恢复凭据就必须提前可用;数据库依赖远程块存储时,对应存储控制面也进入数据库之前的关键路径。
因此生产恢复计划最好把每一步写成“前置条件 → 恢复动作 → 验证门”。只有验证门通过,才继续恢复依赖它的上一层服务。这样既不会为了等待无关基础设施浪费 RTO,也不会因为过早启动应用,把底层尚未解决的问题放大成新的业务故障。