
可观测性与稳定性 / 系统课时
恢复数据库和关键文件
恢复数据库和关键文件
灾难恢复不是把备份文件复制回来就结束,而是要选择满足 RPO 的恢复点,将数据库和关键文件恢复到彼此一致的状态,并记录实际恢复到的数据时间点与耗时。本节用一套可执行流程完成恢复并留下可核验记录。
学习目标
- 根据故障时间、备份时间和恢复目标选择合适恢复点
- 完成数据库与关键文件恢复,并避免覆盖仍有取证价值的数据
- 记录实际数据时间点、恢复耗时和验证结果
先确定恢复点
恢复前先回答两个问题:允许丢失多少数据,以及哪些数据必须保持时间一致。例如数据库恢复到 10:00,而用户上传文件只恢复到 09:00,应用即使启动成功,也可能出现数据库记录存在但文件缺失的问题。
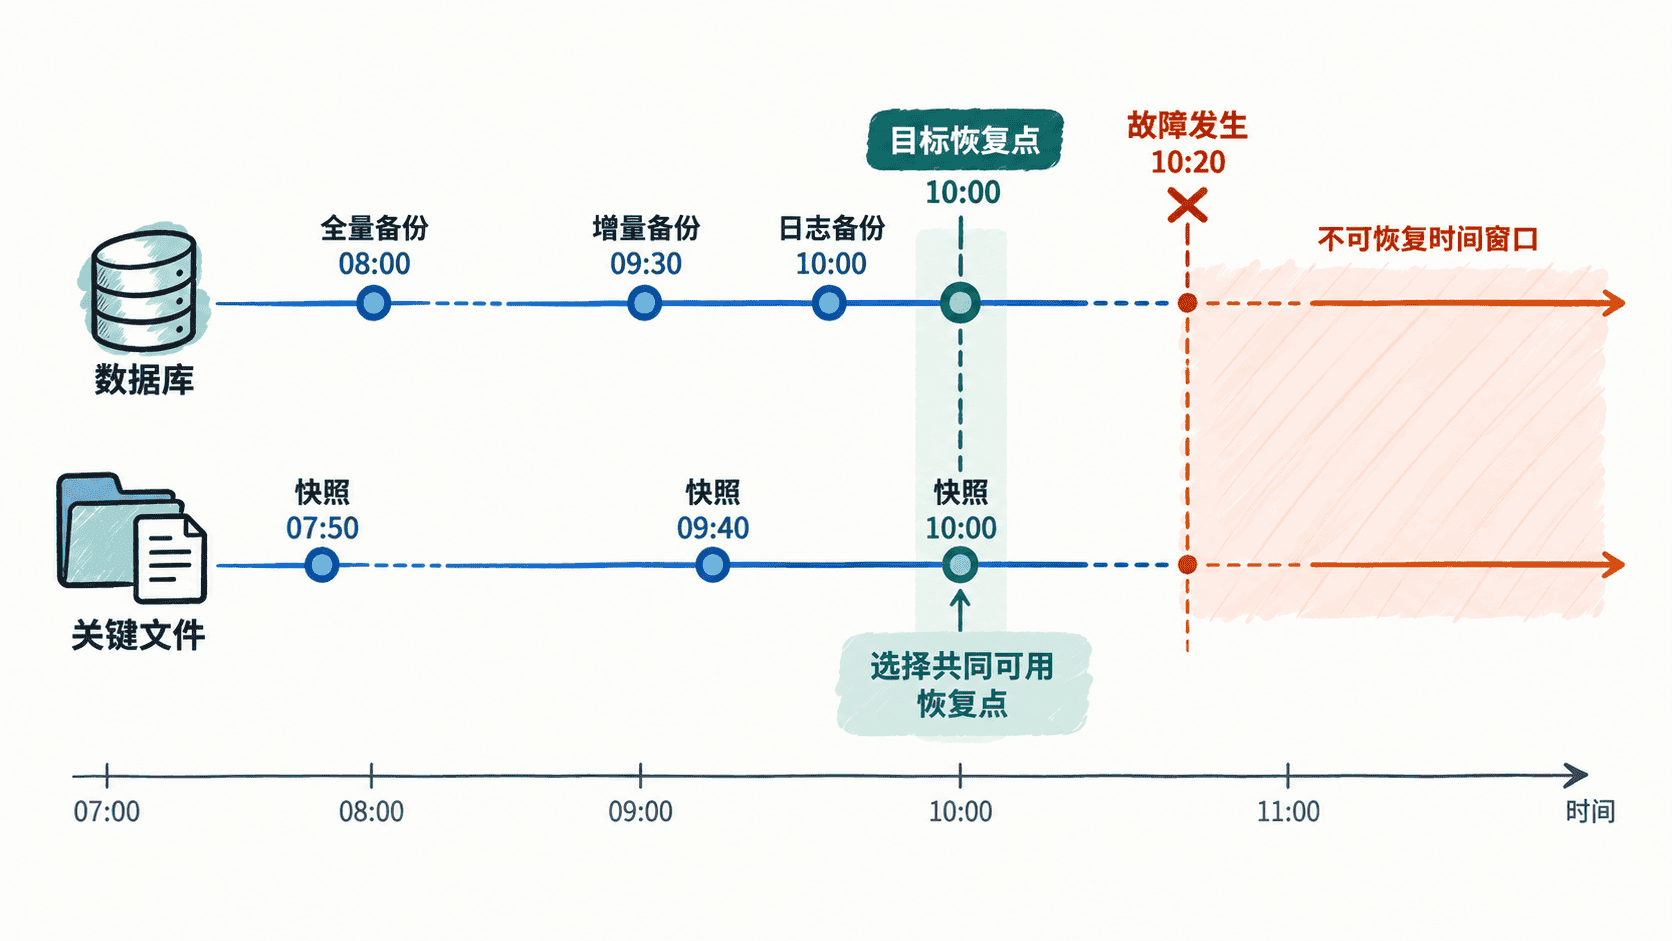
恢复点应来自已经验证可读的备份,而不是单纯选择时间最新的文件。开始恢复前记录备份标识、备份数据截止时间和恢复开始时间;如果数据库支持基于日志的时间点恢复,还要确认完整备份与后续日志链连续。
恢复数据库
下面以 PostgreSQL 的自定义格式逻辑备份为例。假设已经创建空数据库 appdb,备份文件经过完整性检查并位于 /backup/appdb.dump。先恢复到隔离或受控环境,不要直接覆盖仍可能需要调查的原数据库。
pg_restore --dbname=appdb --clean --if-exists --no-owner /backup/appdb.dump预期输出
`text
`pg_restore` 成功时通常不会输出固定的成功文本,因此应以退出码和后续数据库检查为准;实际路径、数据库名和认证方式按环境调整。可继续执行最小查询,确认核心数据已经可访问:

`bash
psql -d appdb -c 'SELECT COUNT(*) AS user_count FROM users;'
预期输出
 user_count
------------
 <COUNT>
(1 row)
<COUNT> 是恢复点对应的实际记录数,不能仅凭“查询成功”判断数据正确,还应与备份时的业务基线或校验记录比较。
恢复关键文件
文件恢复应先落到临时目录,验证后再切换到正式位置。这样可以避免错误备份直接覆盖当前数据,也便于比较文件数量、大小和校验值。以下示例从归档恢复到临时目录:
mkdir -p /restore/app-files && tar -xzf /backup/app-files.tar.gz -C /restore/app-files预期输出
`text
`tar` 正常完成时可以没有输出。随后检查恢复目录的基本状态:

`bash
find /restore/app-files -type f | wc -l
du -sh /restore/app-files
预期输出
<FILE_COUNT>
<SIZE>    /restore/app-files
<FILE_COUNT> 和 <SIZE> 取决于实际备份。若备份阶段保存了 SHA-256 清单,应优先执行校验和验证,而不是只比较文件数量。
记录恢复事实
恢复记录必须区分“希望恢复到哪里”和“实际上恢复到了哪里”。前者来自 RPO,后者由最后一份成功应用的备份、事务日志或文件快照决定。至少记录恢复开始与结束时间、数据库实际数据截止点、文件快照时间、使用的备份标识以及验证结果。
例如可在恢复完成后记录时间:
date -u '+%Y-%m-%dT%H:%M:%SZ'预期输出
<TIME>将结束时间减去开始时间得到本次实际恢复耗时,并与 RTO 比较。<TIME> 是执行时的 UTC 时间,实际值会不同。
恢复完成的判定
数据库能连接、文件能看到,只说明恢复介质已经落地。真正完成还需要确认核心表可查询、关键文件可读取、数据库记录与文件版本相互匹配,并明确记录实际恢复点。如果数据库和文件无法恢复到同一时刻,应把时间差和潜在业务影响作为恢复结果的一部分,而不能用“恢复成功”掩盖数据不一致。