
可观测性与稳定性 / 系统课时
恢复后怎样确认业务可用
恢复后怎样确认业务可用
备份恢复完成、进程重新启动,并不代表业务已经恢复。真正的验收要从进程与端口逐层走到依赖连接和关键业务操作,确认请求不仅能进入服务,还能正确读取、写入并完成完整业务链路。
学习目标
- 按进程、端口、依赖和业务操作的顺序验证恢复结果
- 区分“进程正在运行”“健康检查通过”和“业务真正可用”
- 用可重复的命令和业务探针形成恢复验收证据
为什么启动成功还不够
恢复后的系统可能出现一种危险状态:服务进程存在、端口也在监听,但数据库连接使用了错误地址,缓存不可达,恢复的数据版本不匹配,或者关键写操作失败。此时只检查 systemctl status 或容器状态,很容易过早宣布恢复完成。
验收应遵循由底层到业务层的顺序:进程存在 → 端口监听 → 依赖可达 → 健康检查通过 → 关键业务读写成功。前一层失败时先处理该层,不要直接用上层现象猜测根因。
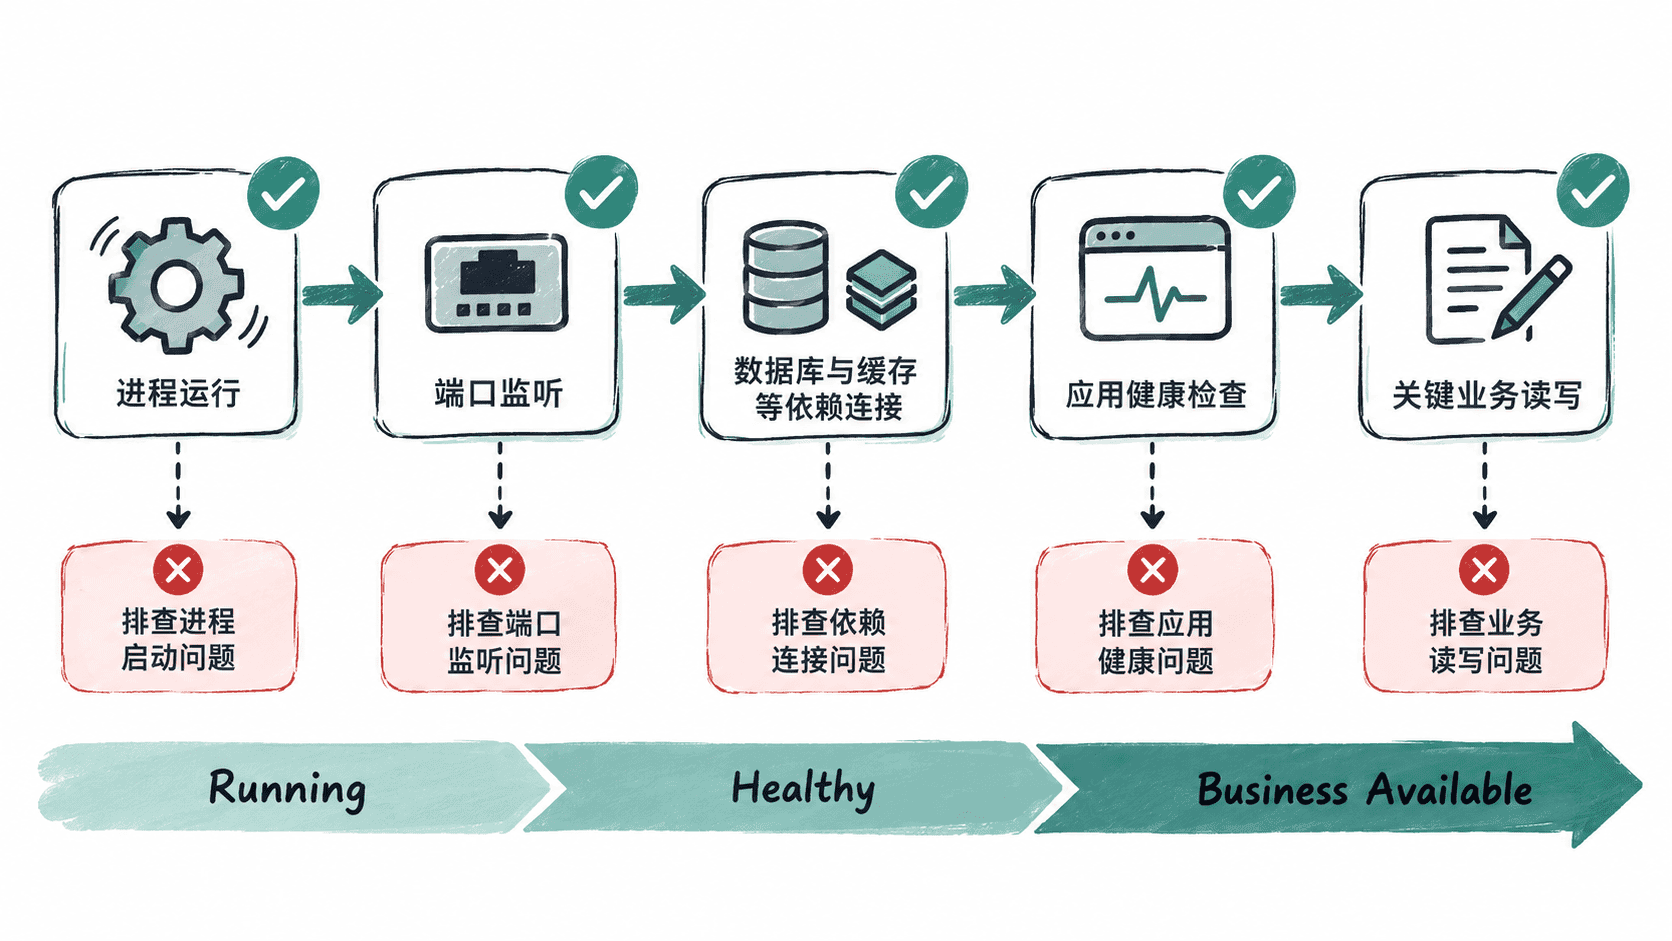
从主机和端口开始验证
先确认恢复后的服务确实由预期进程提供,并监听正确地址和端口。以下以 systemd 管理的 myapp 为例,实际服务名和端口需要替换为恢复环境的值。
systemctl is-active myapp
ss -lntp | grep ':<PORT>'
预期输出
active
LISTEN 0 128 0.0.0.0:<PORT> 0.0.0.0:* users:(("myapp",pid=<ID>,fd=<ID>))
active 只能证明 systemd 认为进程正在运行;LISTEN 进一步证明目标端口已被进程监听。实际 PID、文件描述符和监听地址可能不同。若只监听 127.0.0.1,而业务需要接受远程流量,即使本机测试成功,外部请求仍可能失败。
验证依赖和应用健康状态
应用通常依赖数据库、缓存、消息队列或其他内部服务。恢复后应检查应用日志或专用探针,确认连接指向预期环境,并且认证、网络和数据状态均正常。不要仅以 TCP 端口可连接代替依赖可用性验证,因为端口开放并不能证明查询或认证能够成功。
如果应用提供健康检查接口,可以从实际访问路径执行请求:
curl --fail --silent --show-error http://<HOST>:<PORT>/health预期输出
{"status":"UP"}这里的响应体只是示例,真实系统应以自身健康接口契约为准。若应用没有 /health,应使用已有的只读诊断接口,不能为了验证临时假定一个不存在的端点。
用关键业务操作完成最终验收
最后选择少量但具有代表性的业务路径验证恢复结果。优先覆盖一次读取和一次可安全撤销的写入,例如查询已知测试订单、创建专用探测记录后再删除。生产环境不要拿真实客户数据做破坏性试验。
业务验收至少应回答三个问题:恢复前应存在的数据是否能正确读取;新写入的数据是否真正持久化并能再次读取;涉及数据库、缓存、队列等多个组件的核心链路是否能完成。若系统提供正式的冒烟测试或合成监控,应优先复用它们,而不是临时拼接未经验证的请求。
把验收结果变成恢复证据
灾难恢复验收不能停留在“看起来正常”。记录恢复版本、验证时间、执行人、关键命令结果和业务探针结果,并观察一段时间内的错误率、延迟、积压量和资源使用情况。动态时间可记录为 <TIME>,便于与故障和恢复日志关联。
只有底层服务、依赖和关键业务链路都通过验证,且恢复后的数据能够持续提供正确读写,才能把状态从“服务已启动”提升为“业务已恢复”。