
AI Agent / 系统课时
分析失败类型
分析失败类型
本篇解决 Agent 出现失败后难以定位原因的问题,通过建立失败分类体系,将复杂问题拆分为检索、推理、工具、编辑和验证等环节,最终找到系统瓶颈并制定针对性的优化方案。
学习目标
- 掌握 Agent 常见失败类型及判断方法
- 学会根据日志和结果定位失败环节
- 理解不同失败类型对应的优化方向
建立 Agent 失败分类模型
Agent 的一次任务执行通常包含多个阶段,失败可能发生在任何环节。直接观察最终结果只能知道任务失败,无法知道是知识不足、规划错误还是执行异常。
将失败按照链路拆分,可以快速缩小排查范围:
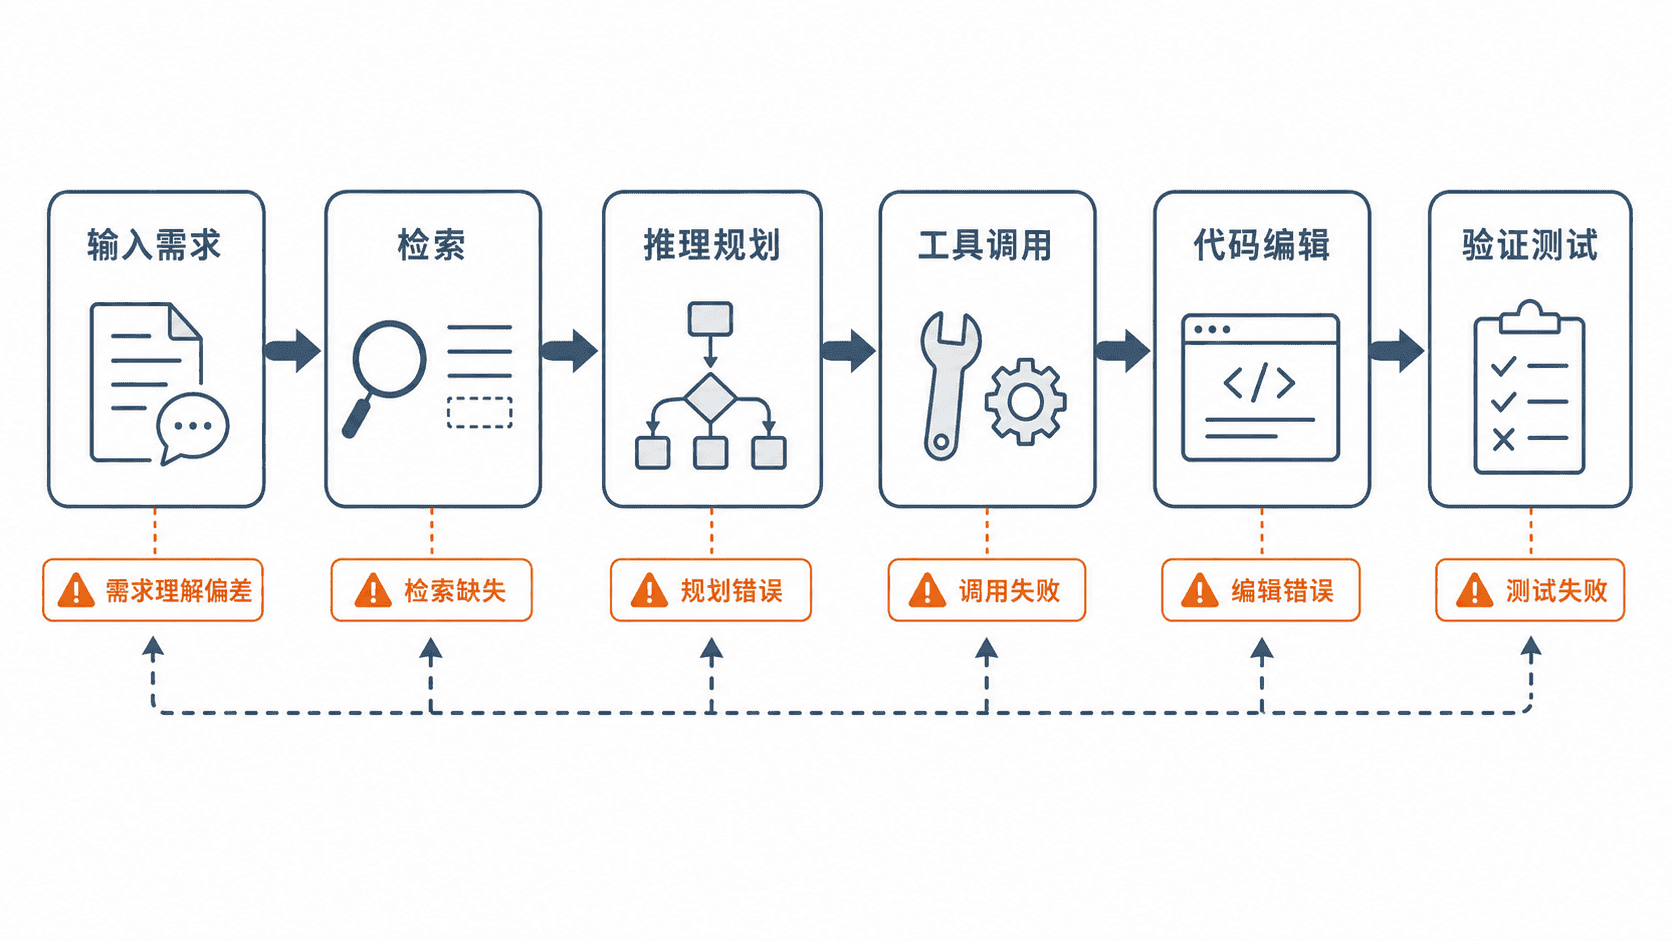
检索失败表示 Agent 没有获得正确的信息;推理失败表示已有信息但规划或判断错误;工具失败表示调用外部能力时出现问题;编辑失败表示修改内容不符合要求;验证失败表示没有正确检查结果。
识别检索失败
检索失败通常表现为 Agent 使用了错误上下文、遗漏关键文件或找到过期信息。排查时需要检查检索结果是否包含完成任务所需的事实。
例如代码 Agent 修改配置文件失败,可能不是修改能力不足,而是没有检索到项目中的实际配置位置。
def check_retrieval(contexts, required_keyword):
    return any(required_keyword in item for item in contexts)

contexts = ["database config", "api router"]
print(check_retrieval(contexts, "database"))
预期输出
True优化方向通常包括改进切片策略、增加元数据过滤或调整检索范围。
识别推理和工具失败
推理失败发生在信息正确但决策错误的情况下。例如 Agent 已经找到异常位置,却选择修改错误文件。
工具失败则通常具有明显外部信号,例如命令执行错误、权限不足、接口超时或参数不符合要求。
排查工具失败时,应优先查看工具调用记录:
{
  "tool": "run_tests",
  "status": "failed",
  "error": "command timeout"
}
预期结果
工具调用记录显示失败原因,可进一步定位超时、参数或环境问题。识别编辑和验证失败
编辑失败表示 Agent 产生了修改,但修改结果不满足代码规范、业务要求或文件约束。例如生成代码能够运行,但破坏已有接口兼容性。
验证失败通常发生在最后阶段,表现为测试未通过、结果检查不足或 Agent 错误判断任务已经完成。
这两类失败需要结合差异分析和测试结果判断,而不是简单要求 Agent 重试。
建立失败分析闭环
实际工程中,可以为每次失败记录阶段、原因、影响和修复措施。
failure:
  stage: tool
  reason: timeout
  impact: test_not_completed
  action: increase_timeout_and_retry
预期结果
失败记录可以用于统计高频问题,并指导后续优化。持续积累失败样本后,团队能够发现系统主要瓶颈。例如大量检索失败说明知识库需要优化,大量验证失败说明测试反馈不足。
本课总结
- Agent 失败需要按执行链路分类,而不是只观察最终结果。
- 不同失败类型对应不同优化方向,定位准确比重复运行更重要。
- 失败记录和统计分析能够形成持续优化闭环。
下一课预告
下一课将进一步学习如何通过反馈机制和自动验证提升 Agent 的长期可靠性。