
AI Agent / 系统课时
理解上下文窗口
理解上下文窗口
本课解决智能体为什么会因为上下文过长而降低推理质量的问题,帮助开发者理解 Token 预算、信息密度和上下文裁剪之间的关系。
学习目标
- 理解上下文窗口和 Token 消耗的关系
- 掌握智能体上下文预算分配的基本方法
- 能够识别无效信息对模型推理造成的影响
上下文窗口解决什么问题
模型每次推理都需要读取输入上下文,包括系统提示、用户需求、历史消息、工具结果和检索内容。上下文窗口表示模型一次能够处理的信息总量。
当输入内容接近限制时,并不是简单地增加信息越好。大量无关内容会降低有效信息比例,使模型更难找到真正影响任务的关键部分。
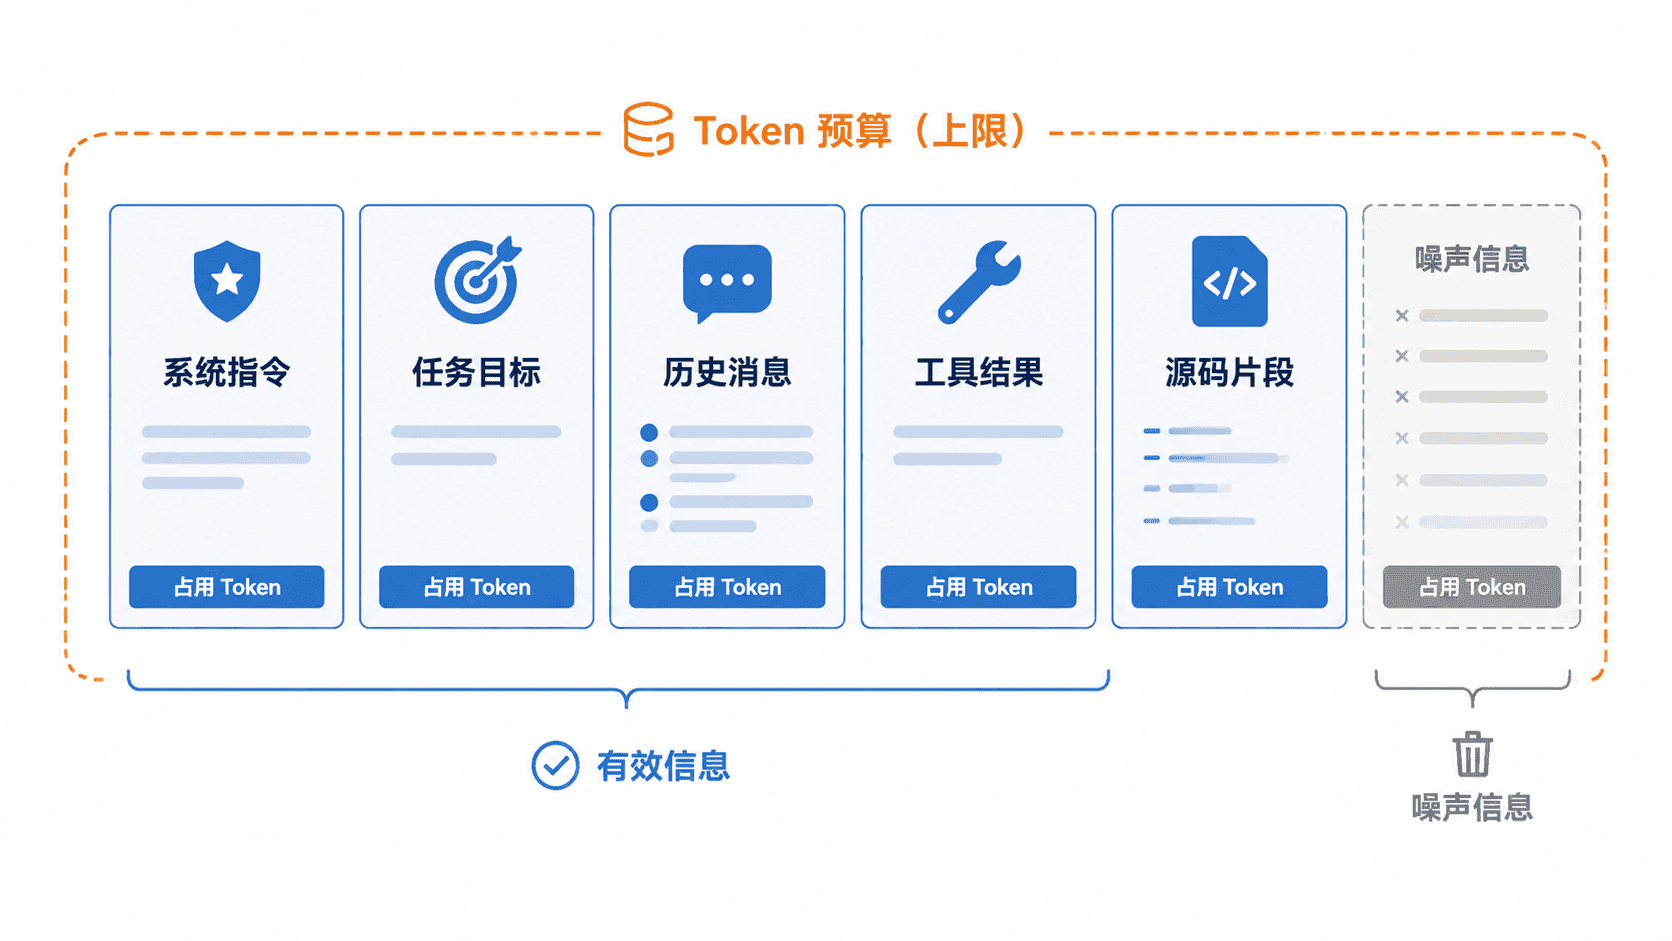
理解 Token 预算
上下文窗口可以看成有限容量的资源,需要提前规划分配。常见划分方式如下:
| 内容类型 | 作用 | 优先级 |
|---|---|---|
| 系统规则 | 定义行为边界 | 高 |
| 当前任务 | 指导当前目标 | 高 |
| 相关源码 | 提供解决问题的信息 | 中高 |
| 历史对话 | 保留上下文连续性 | 中 |
| 无关日志 | 辅助排查 | 低 |
智能体设计中通常不会无限追加内容,而是根据任务动态选择最有价值的信息。
信息密度影响推理质量
上下文质量可以理解为有效信息占比。如果上下文包含大量重复代码、无关历史记录或过期工具结果,模型虽然看到了更多内容,但实际可利用的信息更少。
例如处理一个函数修改任务时,只提供目标文件和相关调用链,通常比发送整个项目源码更容易得到准确结果。
可以使用简单公式理解信息效率:
提高信息密度比单纯扩大上下文规模更重要。
实践中的上下文管理
智能体通常通过 Context Builder 控制输入内容,而不是直接把所有数据发送给模型。
下面是一个简单的上下文预算配置示例。
yaml
contextBudget:
  totalTokens: 12000
  systemPrompt: 1500
  taskDescription: 2000
  sourceCode: 6000
  history: 1500
  toolResult: 1000
配置生效后,Context Builder 会按照预算限制选择和裁剪内容,避免单个来源占满整个窗口。
常见误区
第一个误区是认为上下文越长效果越好。实际上,当无关内容比例升高时,模型定位关键事实的难度也会增加。
第二个误区是只关注 Token 数量,而忽略内容质量。两个长度相同的上下文,如果一个包含精准代码片段,另一个包含大量日志,推理效果可能完全不同。
理解上下文窗口,是后续设计 Context Builder、记忆系统和检索策略的基础。
按自己的节奏,确认真正理解。