
AI Agent / 系统课时
设计 Project IR
设计 Project IR
本篇解决智能体读取大型代码项目时信息过载的问题,通过设计 Project IR(项目语义中间表示),把文件、符号和依赖关系转换成模型更容易理解的数据结构,让后续检索、分析和代码生成拥有稳定输入。
学习目标
- 理解 Project IR 在代码智能体中的作用和设计目标。
- 掌握项目元素如何转换为结构化语义表示。
- 能够设计适合检索和推理的基础 IR 数据模型。
为什么需要 Project IR
代码项目通常包含大量文件、目录、函数、类、接口和依赖关系。如果智能体直接读取原始源码,需要消耗大量上下文,并且难以快速建立项目整体结构。
Project IR 的作用是建立源码与模型之间的中间层。它不替代源码,而是提取对理解项目最有价值的信息,例如文件职责、符号定义、调用关系和模块边界。
通过 IR,智能体可以先回答“项目有哪些模块”“某个函数在哪里定义”“哪些文件会受到修改影响”等问题,再按需读取具体代码。
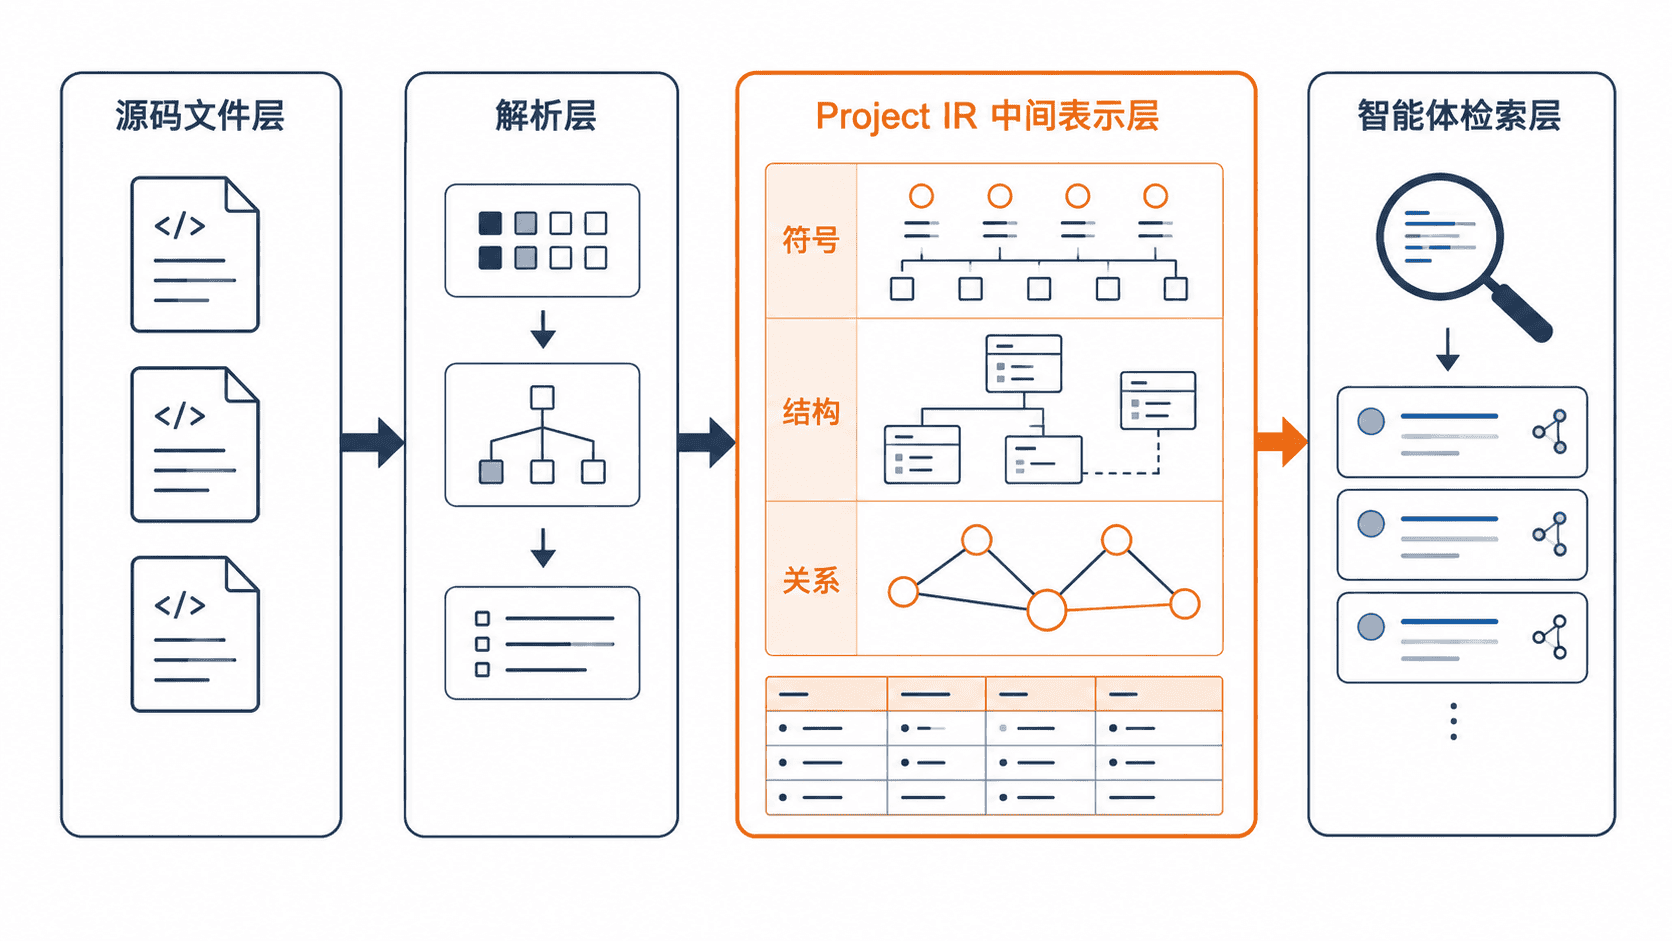
Project IR 的核心组成
一个基础 Project IR 通常包含三类信息:实体信息、关系信息和上下文信息。
实体信息描述项目中的对象,例如文件、类、函数和变量。关系信息描述对象之间的连接,例如函数调用、继承、导入和引用。上下文信息补充对象用途,例如文件路径、模块说明和更新时间。
下面是一个简化的 IR 示例:
{
  "file": "src/user/service.ts",
  "symbols": [
    {
      "name": "UserService",
      "kind": "class",
      "methods": ["createUser", "findUser"]
    }
  ],
  "imports": ["UserRepository"]
}
预期结果
Project IR 节点包含文件、符号和依赖关系,可被智能体直接检索。设计 IR 时的关键原则
Project IR 不是简单复制代码 AST,而是面向智能体任务进行压缩。
第一,保留决策相关信息。例如代码审查需要知道函数职责和调用链,而不是每一个语法节点。
第二,保持可追踪性。IR 中应该保存源码位置,例如文件路径、行号范围,方便智能体从摘要回到真实代码。
第三,支持增量变化。项目不断修改,IR 需要知道哪些节点受影响,避免每次重新生成全部数据。
Project IR 在智能体中的使用流程
智能体处理代码任务时,可以按照以下路径工作:
- 解析项目文件,提取符号和关系。
- 生成 Project IR 并建立索引。
- 根据用户问题检索相关节点。
- 回溯真实源码完成分析或修改。
这种方式让模型先获得项目地图,再进入具体实现细节。
常见设计误区
一个常见错误是把 IR 做成源码摘要集合。这样的数据缺少结构关系,无法支持复杂推理。
另一个错误是保存过多低价值细节,导致 IR 本身变得庞大,失去减少上下文消耗的意义。
好的 Project IR 应该在信息完整性和模型可读性之间取得平衡。
本课总结
- Project IR 是连接源码和智能体推理能力的语义中间层。
- IR 应重点保存实体、关系和上下文,而不是简单复制源码。
- 高质量 IR 需要支持检索、追踪和增量更新。
下一课预告
下一课将介绍如何根据文件变化检测影响范围,并实现项目索引的增量更新机制。