
AI Agent / 系统课时
压缩长文件内容
压缩长文件内容
本篇解决智能体读取超长文件时上下文被大量占用的问题,通过摘要、局部片段和结构索引建立分层读取机制,让 Agent 在保留关键信息的同时减少无效 Token 消耗。
学习目标
- 理解长文件进入上下文时产生的资源浪费原因
- 掌握摘要、索引和局部加载三种压缩策略
- 能够设计适合 Agent 的文件分层读取流程
长文件为什么需要压缩
智能体处理源码、日志、设计文档或知识库文件时,如果直接把完整内容放入上下文,会导致大量 Token 被固定文本占据。真正影响任务决策的通常只是文件中的少量结构信息和相关片段。
压缩长文件不是简单删除内容,而是改变信息进入上下文的方式。系统先保留低成本的导航信息,需要时再展开高价值细节。
三层文件内容模型
一个适合 Agent 的文件通常可以拆分为三层:
第一层是结构索引,用于回答“文件有哪些部分”。例如目录、类名、函数名、章节标题等。
第二层是摘要信息,用于回答“这一部分解决什么问题”。摘要保留主要职责、关键约束和重要结论。
第三层是原始片段,用于回答“具体实现是什么”。只有当前任务需要时才加载完整内容。
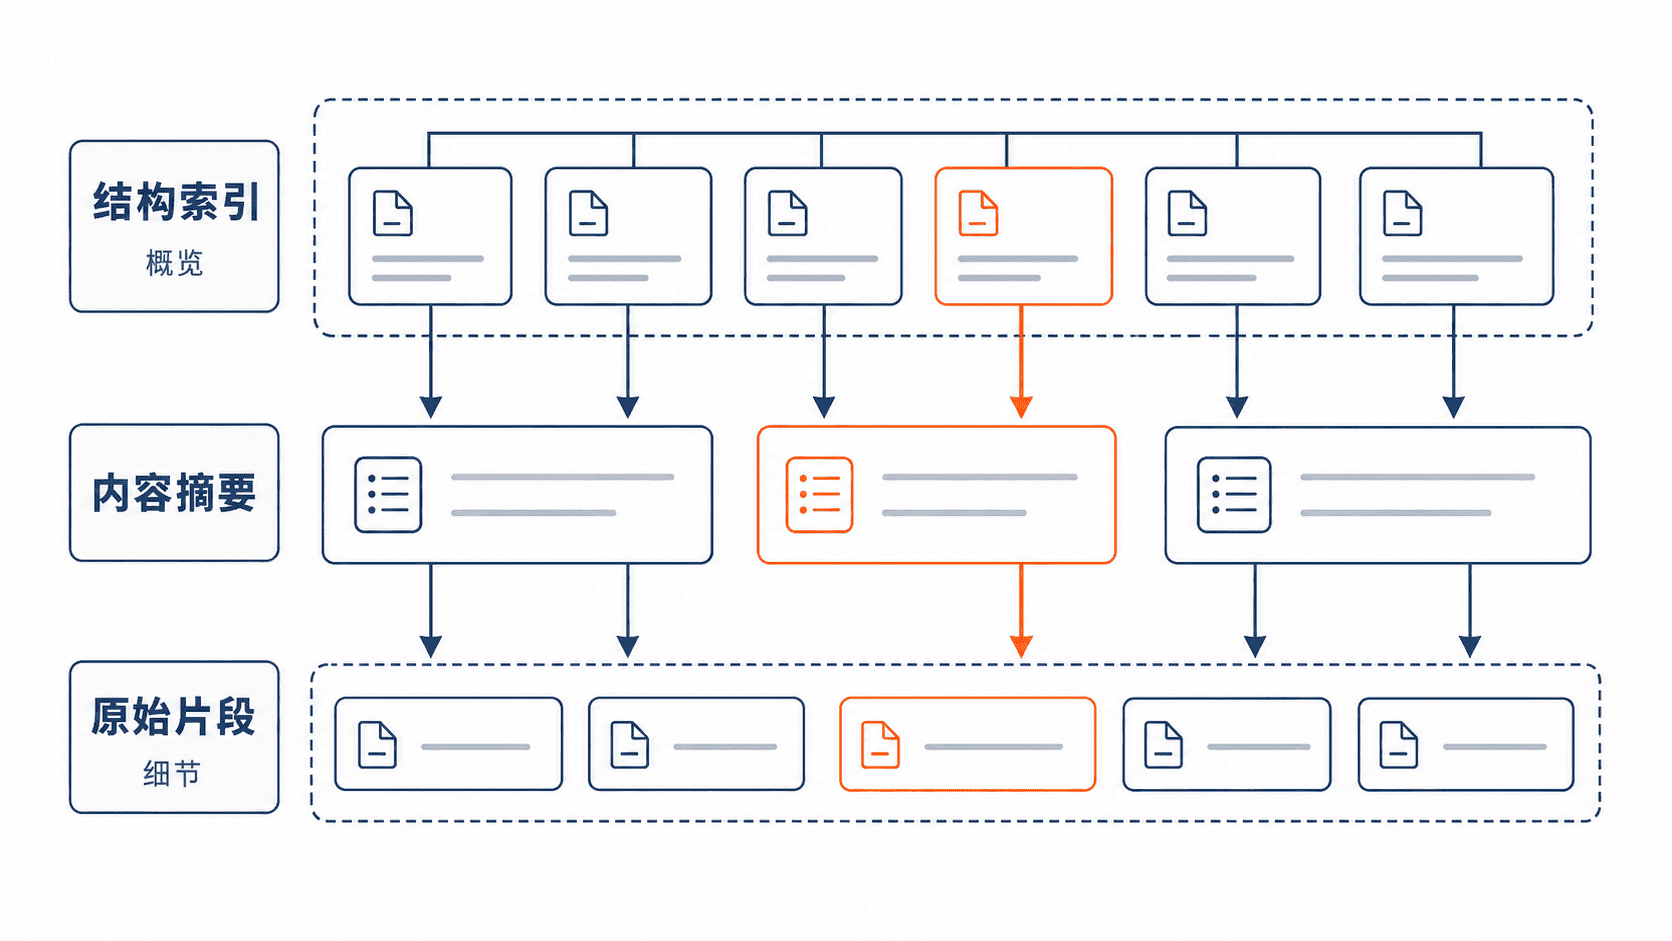
例如,一个包含数千行代码的文件,可以先提供类列表和方法摘要。当 Agent 判断需要修改某个方法时,再读取对应代码范围。
使用摘要减少上下文占用
摘要应该保存影响决策的信息,而不是机械压缩文字。
一个有效摘要通常包含:
- 文件用途和边界
- 核心组件或主要流程
- 外部依赖和重要配置
- 不可违反的约束条件
可以使用脚本为文件生成基础摘要,并在运行时提供给 Agent。
from pathlib import Path


def build_file_summary(path: str) -> str:
    file = Path(path)
    lines = file.read_text(encoding="utf-8").splitlines()

    # 保留文件规模和开头结构信息,作为索引基础
    return f"文件: {file.name}\n行数: {len(lines)}\n开头: {' '.join(lines[:5])}"


print(build_file_summary("example.py"))
预期输出
文件: example.py
行数: <LINE_COUNT>
开头: import os class Example:
实际输出中的行数和开头内容会根据文件不同而变化。
按需加载局部片段
当摘要不足以完成任务时,不应重新读取整个文件,而应该根据索引定位范围。
常见策略包括:
- 根据函数名定位代码区域
- 根据错误日志定位相关模块
- 根据章节标题定位文档片段
- 根据搜索结果加载上下文窗口
这种方式可以让 Agent 在相同 Token 预算下处理更大的项目。
常见错误
最常见的问题是把压缩理解为永久删除信息。如果摘要丢失了关键约束,Agent 可能生成看似正确但无法运行的方案。
另一个问题是摘要层设计过粗。例如只保存“这是用户模块”,却没有保存权限规则、数据关系等关键内容,后续推理仍然会失败。
本课总结
- 长文件压缩的核心是分层加载,而不是简单截断。
- 结构索引、摘要和原始片段共同组成高效上下文模型。
- Agent 应根据任务需要逐步展开文件内容。
下一课预告
下一课将继续介绍如何规划上下文预算,让系统规则、历史消息、工具结果和源码之间保持合理比例。