
AI Agent / 系统课时
增量更新项目索引
增量更新项目索引
本篇解决代码项目频繁修改导致索引重复构建的问题,通过检测文件变化和影响范围,只重新解析必要内容,降低智能体维护项目知识库的成本。
学习目标
- 理解项目索引为什么需要增量更新。
- 掌握文件变化检测和影响分析的基本流程。
- 能够设计简单的增量索引更新方案。
为什么需要增量索引
大型项目包含数千甚至数万文件。如果每次代码修改后都重新扫描整个项目,会产生大量无效解析工作,增加等待时间和计算成本。
增量索引的目标是回答一个关键问题:哪些内容发生变化,哪些索引需要重新生成。
例如修改一个工具函数时,不需要重新解析整个项目,只需要更新该文件对应的符号信息,以及可能依赖它的关系节点。
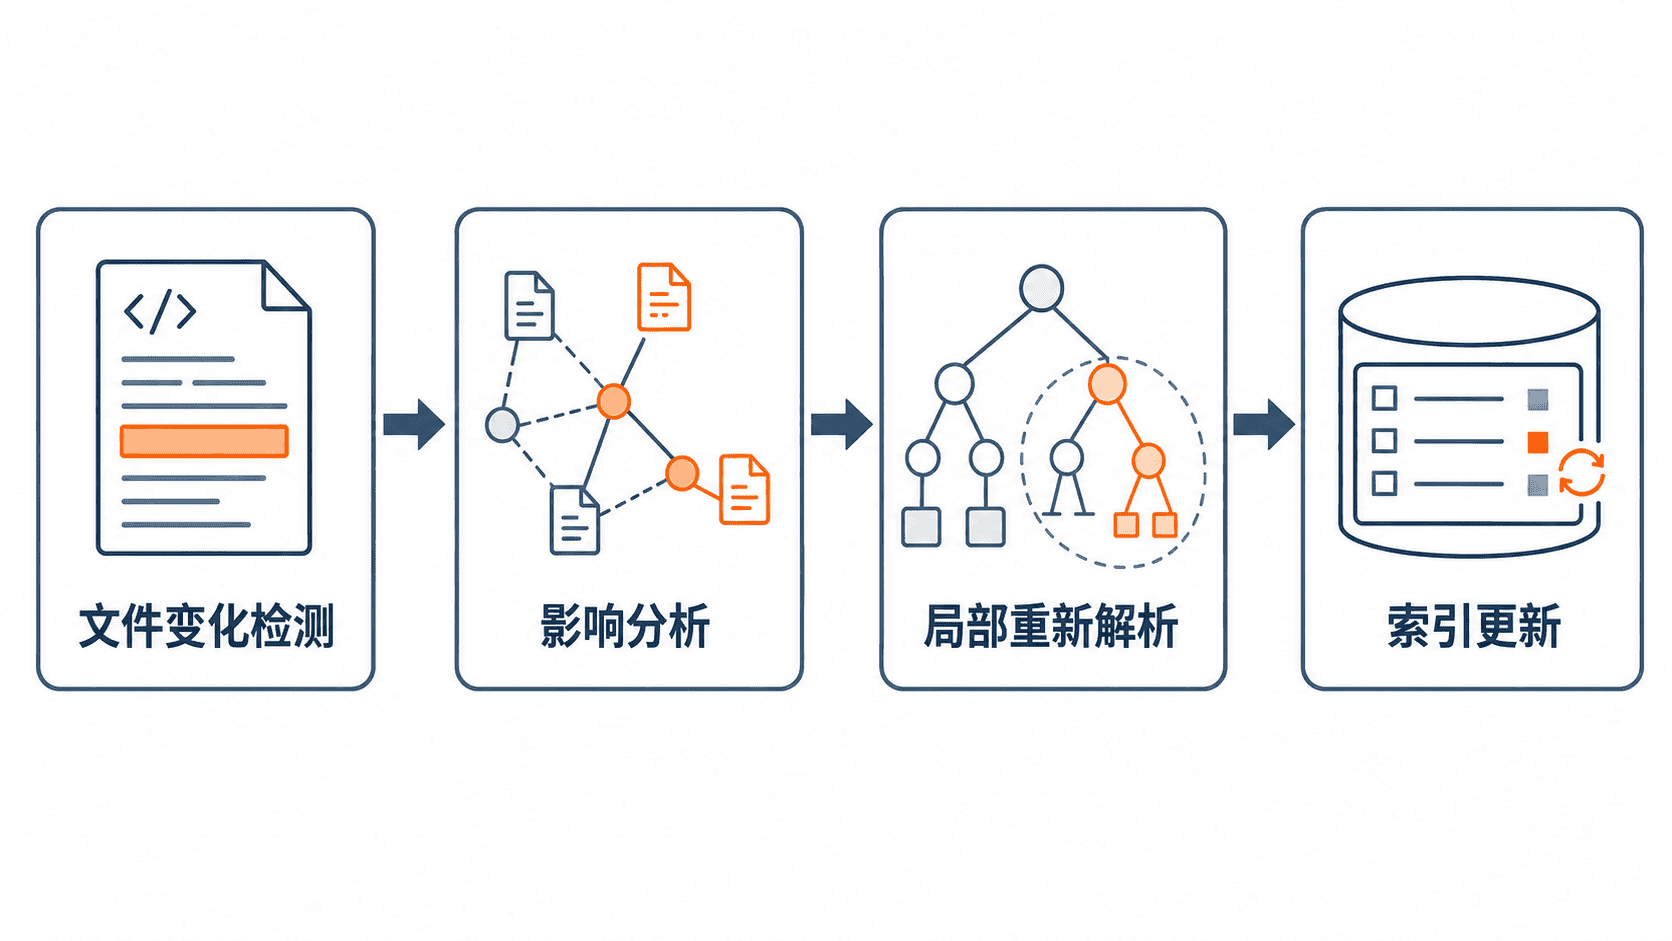
增量更新的核心流程
一个基础增量更新流程通常包含四步:
- 监听文件变化,例如新增、修改或删除。
- 根据路径定位对应索引节点。
- 分析依赖关系,确定受影响范围。
- 重新生成相关 IR 和索引数据。
文件变化可以通过版本控制差异或文件系统事件获得。
python
from pathlib import Path

cache = {}

def update_index(path):
    content = Path(path).read_text()
    cache[path] = {
        "size": len(content),
        "indexed": True
    }
    return cache[path]

result = update_index("src/user.py")
print(result)
预期输出
text
{'size': <SIZE>, 'indexed': True}其中 <SIZE> 表示实际文件字符数量,具体值会随文件内容变化。
判断影响范围
仅知道文件变化还不够,智能体还需要知道变化会影响哪些对象。
例如修改一个公共接口,需要更新调用该接口的模块;修改私有函数,影响范围可能只局限于当前文件。
因此索引系统通常需要保存依赖图,包括:
- 文件导入关系。
- 函数调用关系。
- 类型引用关系。
- 模块依赖关系。
通过这些关系,可以从变化节点向外扩散,计算需要重新处理的范围。
增量索引的数据一致性
增量更新最大的风险是索引状态不完整。例如文件已经删除,但旧符号仍保留在索引中,会导致智能体获得错误信息。
因此更新流程需要处理不同事件:
| 变化类型 | 处理方式 |
|---|---|
| 新增文件 | 解析文件并创建索引节点 |
| 修改文件 | 重新生成对应节点 |
| 删除文件 | 移除节点和相关关系 |
更新完成后,应通过校验任务确认索引和源码状态一致。
常见失败处理
如果智能体发现索引结果与源码不一致,可以按照以下顺序排查:
- 检查文件变化事件是否被捕获。
- 检查变化路径是否正确映射到索引节点。
- 检查依赖关系是否完整。
- 必要时执行一次完整重建作为恢复手段。
增量更新并不是永远替代全量构建,而是在正常情况下减少重复工作,在异常情况下提供恢复路径。
本课总结
- 增量索引通过只处理变化部分降低项目理解成本。
- 影响范围分析依赖可靠的代码关系图。
- 增量更新需要和完整重建机制配合保证一致性。
下一课预告
下一课将继续学习智能体如何利用项目索引完成代码检索和上下文组装。
按自己的节奏,确认真正理解。