
AI Agent / 系统课时
管理多轮执行状态
管理多轮执行状态
本篇解决 Agent 在多次模型调用和工具执行之间丢失上下文的问题,通过设计执行状态结构,让 Runtime 能够保存当前任务进度、历史消息和中间结果,保证复杂任务可以连续运行。
学习目标
- 理解 Agent 多轮执行状态包含的核心信息。
- 掌握状态保存、读取和更新的基本流程。
- 能够设计支持长任务运行的 Runtime 状态模型。
多轮状态包含什么
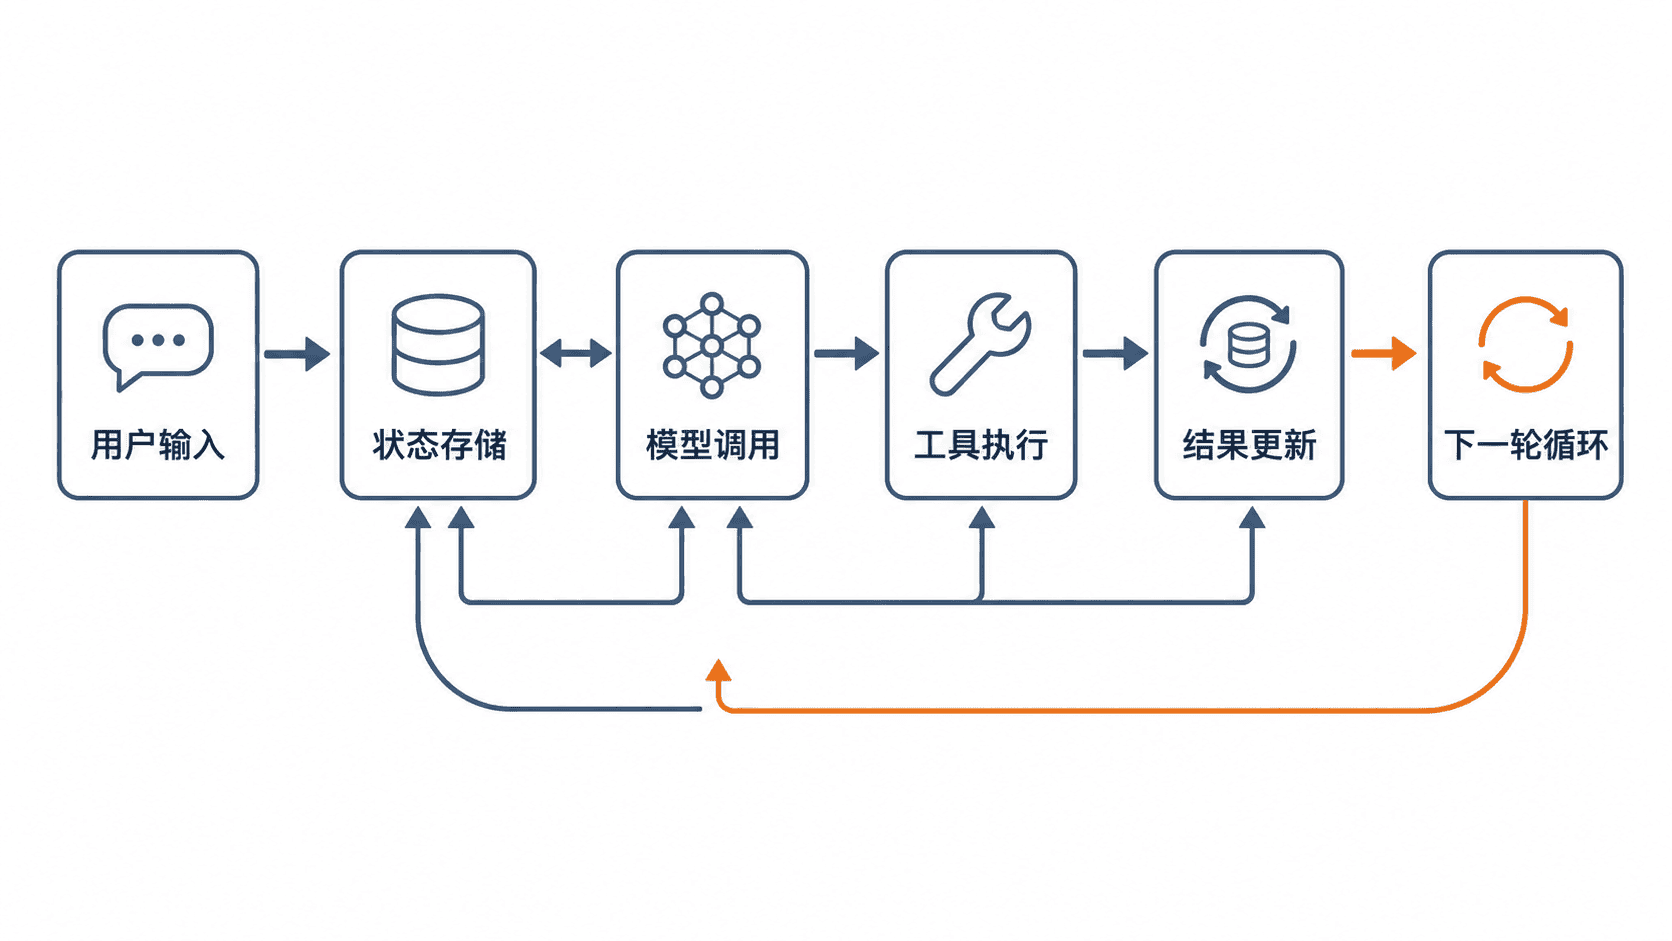
单次模型调用只关注当前输入,但 Agent 任务通常需要经历规划、调用工具、分析结果和继续决策多个阶段。因此 Runtime 需要维护一个状态对象,记录任务在执行过程中的变化。
常见状态包括会话消息、当前步骤、工具结果、任务标识和执行状态。
设计状态模型
状态模型需要区分长期信息和当前执行信息。长期记忆用于跨任务复用,当前状态只服务于一次任务运行。
一个简化状态结构如下:
python
from dataclasses import dataclass, field

@dataclass
class AgentState:
    task_id: str
    step: int = 0
    messages: list = field(default_factory=list)
    status: str = "running"


state = AgentState(task_id="<ID>")
state.messages.append({"role": "user", "content": "hello"})
print(state.status)
预期输出
text
running其中 <ID> 代表实际运行中的任务标识,生产环境会由系统生成。
状态更新流程
每轮执行通常遵循固定顺序:读取当前状态、生成下一步 Action、执行动作、保存结果、进入下一轮。
python
def update_state(state, result):
    state.messages.append(result)
    state.step += 1
    return state

result = {"role": "tool", "content": "success"}
print(update_state(state, result).step)
预期输出
text
1状态更新需要保证原子性,避免工具执行成功但状态保存失败导致任务恢复错误。
状态持久化与恢复
短任务可以将状态保存在内存中,长任务则需要持久化到数据库或缓存系统。持久化时需要保存足够的信息,使 Runtime 能从中断位置继续执行。
实际设计中通常会记录版本号、更新时间和执行节点信息,方便迁移和排障。
常见状态管理问题
状态设计过大会导致上下文膨胀,影响模型调用成本;状态设计过小则无法恢复执行。合理做法是保存任务必要信息,对历史消息进行裁剪或摘要。
本课总结
- 多轮 Agent 执行依赖稳定状态模型保存上下文和进度。
- 状态更新需要与 Action 执行保持一致,避免产生错误恢复点。
- 长任务场景需要结合持久化机制提高可靠性。
下一课预告
下一课将介绍 Agent Runtime 中任务循环的实现方式,学习如何组织观察、决策和执行的完整闭环。
按自己的节奏,确认真正理解。