
AI Agent / 系统课时
实现自动修复循环
实现自动修复循环
本篇解决智能体如何在失败后自动继续修改、执行和验证的问题。最终结果是建立一个受控闭环,让智能体能够持续尝试修复,同时通过失败次数限制避免无限循环。
学习目标
- 理解编辑、执行、观察三个阶段如何组成闭环
- 掌握自动修复循环的核心控制逻辑
- 能够为智能体增加失败保护机制
自动修复循环的基本模型
自动修复循环的核心是让智能体根据执行结果决定下一步动作,而不是一次生成代码后立即结束。
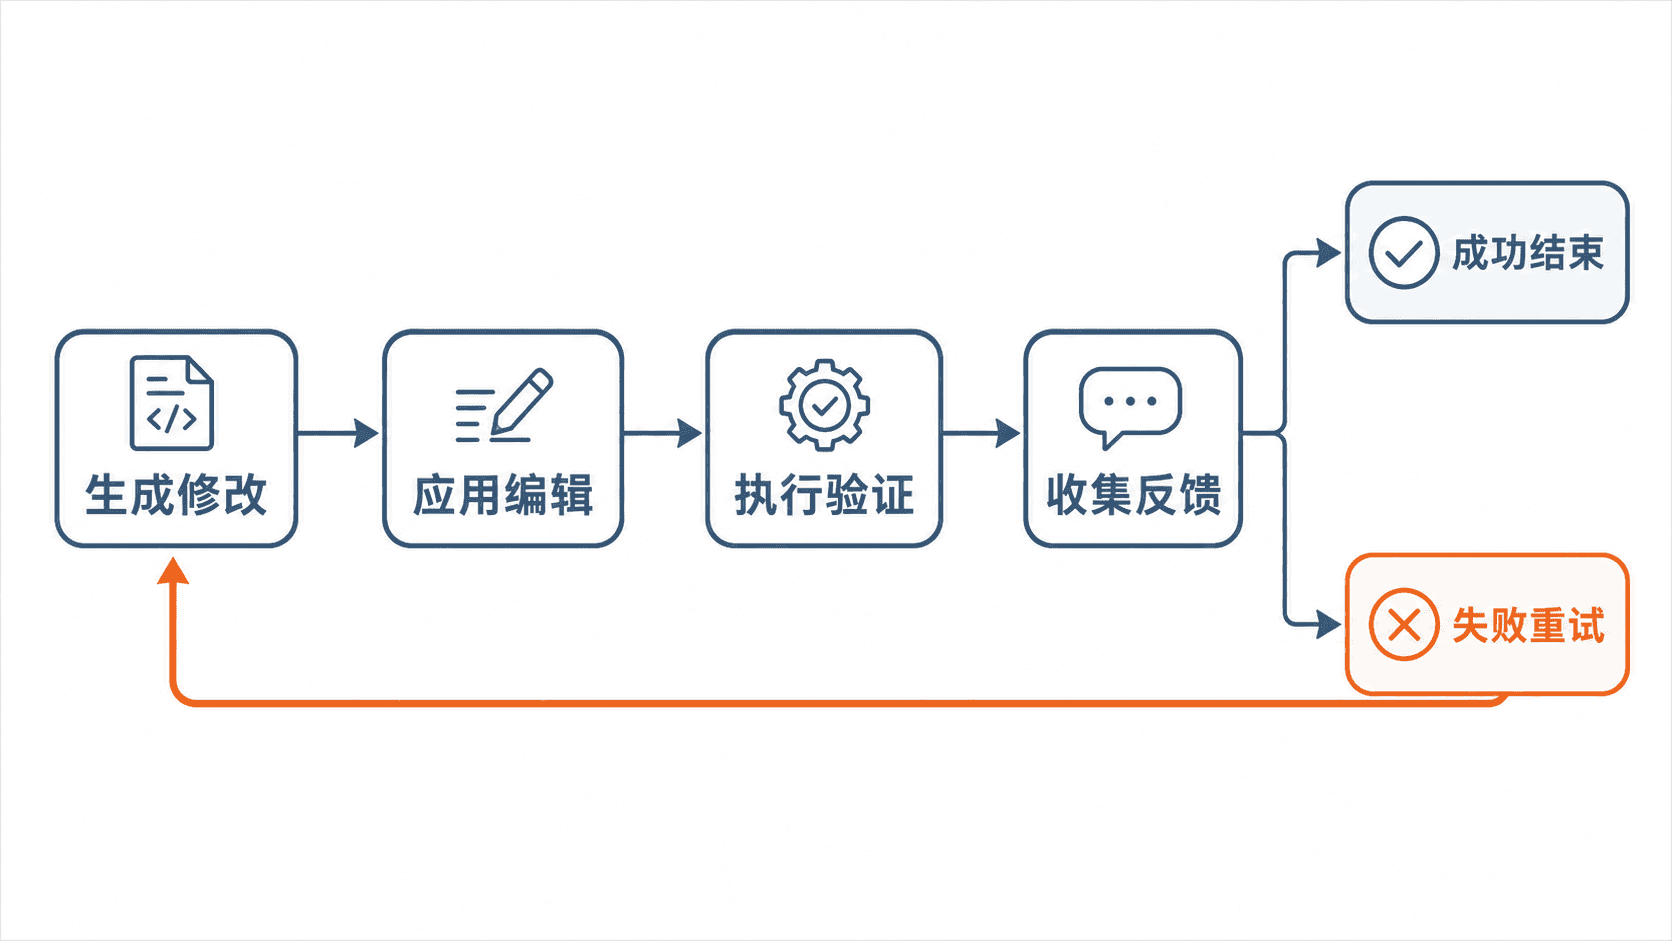
典型流程如下:
- 模型生成修改方案
- 智能体应用修改
- 执行测试或工具调用
- 收集结果并反馈给模型
- 根据结果决定继续或结束
设计循环控制状态
自动修复不能简单使用无限 while 循环,需要明确状态和退出条件。
常见状态包括:
- EDIT:等待模型生成修改
- RUN:执行代码或测试
- OBSERVE:分析执行结果
- DONE:问题解决
- STOP:达到限制或无法继续
下面是一个最小循环控制示例。
python
MAX_RETRIES = 3

attempt = 0
result = "failed"

while attempt < MAX_RETRIES and result != "success":
    attempt += 1

    patch = generate_fix()
    apply_patch(patch)
    result = run_test()

    print(f"attempt={attempt}, result={result}")
预期输出
text
attempt=1, result=failed
attempt=2, result=failed
attempt=3, result=success
限制连续失败次数
失败次数限制是自动修复系统的重要保护机制。没有限制时,模型可能因为理解错误不断修改同一位置,浪费计算资源。
实际系统中通常还会增加更多停止条件:
| 条件 | 作用 |
|---|---|
| 最大尝试次数 | 防止无限循环 |
| 最大执行时间 | 控制资源消耗 |
| 重复修改检测 | 避免无效振荡 |
| 风险操作确认 | 防止自动执行危险动作 |
保存每轮执行记录
每一次循环都应该记录输入、修改和结果,方便后续分析。
json
{
  "attempt": 2,
  "change": "add validation for empty token",
  "test": "failed",
  "nextAction": "retry"
}
预期结果
text
系统可以根据历史记录判断是否继续修复,并支持问题回溯。自动修复循环的边界
自动修复适合处理测试失败、配置错误和局部代码问题,但不应该让模型无限制修改核心业务逻辑。
在生产环境中,需要结合权限控制、人工确认和变更审计,确保循环行为可预测。
本课总结
- 自动修复循环由编辑、执行、观察和反馈几个阶段组成。
- 最大失败次数和状态控制是避免失控的关键。
- 每轮执行记录可以提升可追踪性和问题分析能力。
下一课预告
下一课将继续完善智能体执行体系,介绍如何管理长期任务中的状态与上下文。
按自己的节奏,确认真正理解。