
AI Agent / 系统课时
处理 Patch 冲突
处理 Patch 冲突
本篇解决代码修改引擎在应用 Patch 时因源文件变化、目标片段不存在或匹配结果不唯一导致误修改的问题。学习后可以让引擎在不确定时停止写入,重新定位目标位置。
学习目标
- 理解 Patch 冲突产生的主要原因和风险。
- 掌握安全应用 Patch 的校验与回退流程。
- 实现冲突检测后的重新定位策略。
Patch 冲突为什么必须被检测
代码修改引擎通常依据旧版本文本生成 Patch,但真实项目中的文件可能已经被格式化、重构或其他任务修改。如果直接按照旧位置替换内容,可能覆盖错误区域,造成不可逆损坏。
Patch 冲突通常来自三类情况:目标文本不存在、目标文本出现多次、上下文内容已经变化。可靠的修改器不能把“找不到目标”当作失败后的继续尝试,而应该进入重新分析阶段。
安全应用 Patch 的基本流程
一个稳定的流程应包含定位、验证、应用和确认四个阶段。定位阶段寻找候选位置,验证阶段检查上下文是否仍然符合预期,只有通过验证后才执行修改。
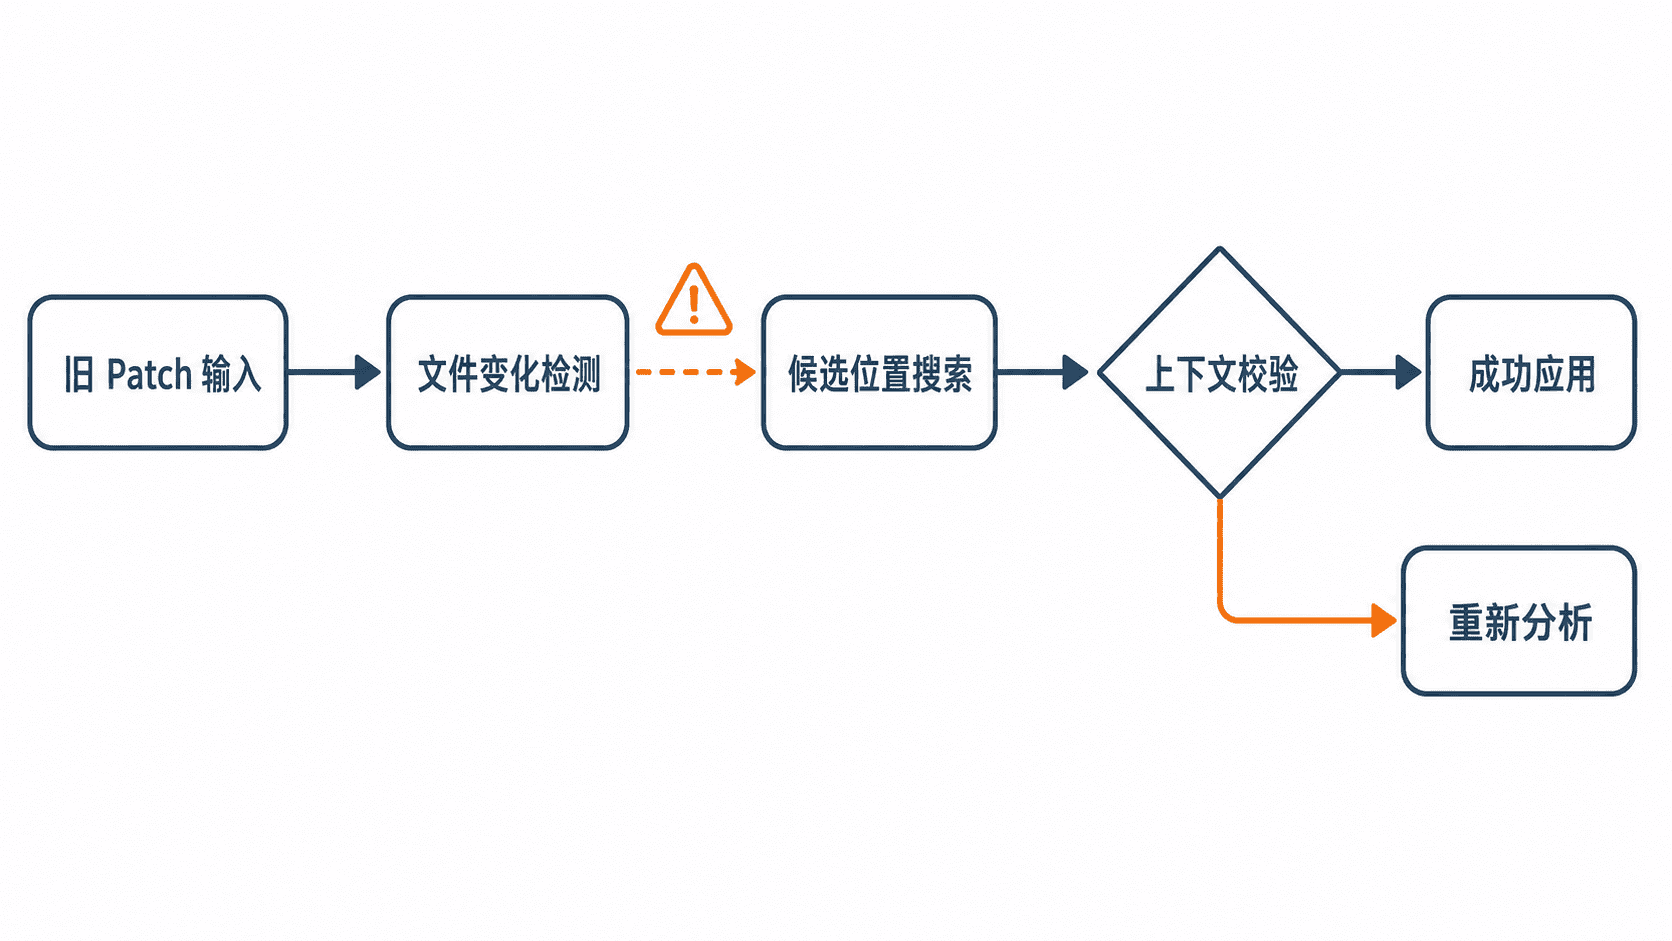
核心判断逻辑可以简化为:
python
from dataclasses import dataclass

@dataclass
class PatchResult:
    applied: bool
    reason: str


def apply_patch(source, old_text, new_text):
    count = source.count(old_text)
    # 只有唯一匹配时才允许自动修改
    if count != 1:
        return PatchResult(False, "target is ambiguous or missing")
    return PatchResult(True, source.replace(old_text, new_text, 1))
预期结果
text
PatchResult(applied=False, reason='target is ambiguous or missing')冲突后的重新定位策略
当 Patch 无法直接应用时,修改引擎可以重新读取当前文件,并结合更稳定的信息定位目标。例如使用函数名、类名、语法结构或符号路径缩小范围,再生成新的修改方案。
不要通过降低匹配条件强行完成修改。模糊匹配可能短期减少失败率,但会增加错误写入风险。代码代理系统更重要的是保证修改可信,而不是追求每次都自动成功。
常见错误
最常见的问题是只保存行号作为目标位置。行号会随着插入、删除和格式化变化,无法作为长期稳定标识。
另一个错误是发现冲突后直接替换相似文本。正确方式应该保留原始 Patch、记录冲突原因,并让后续定位流程重新计算目标。
本课总结
- Patch 应用前必须验证目标唯一性和上下文一致性。
- 冲突处理的核心不是强行修改,而是重新定位。
- 可靠代码修改引擎优先保证正确性,再追求自动化程度。
下一课预告
下一课将进一步实现符号级修改,让代码编辑从文本匹配升级到结构化定位。
按自己的节奏,确认真正理解。