
AI Agent / 系统课时
选择状态与持久化方案
选择状态与持久化方案
本篇解决智能体工程中会话、任务和运行状态如何保存的问题,最终能够根据数据生命周期选择 SQLite、PostgreSQL 或缓存服务,建立适合开发阶段和生产阶段的状态存储方案。
学习目标
- 理解智能体状态数据的分类和持久化边界
- 掌握 SQLite 在本地开发和轻量部署中的使用方式
- 能够判断何时迁移到 PostgreSQL 或独立缓存服务
状态数据为什么需要持久化
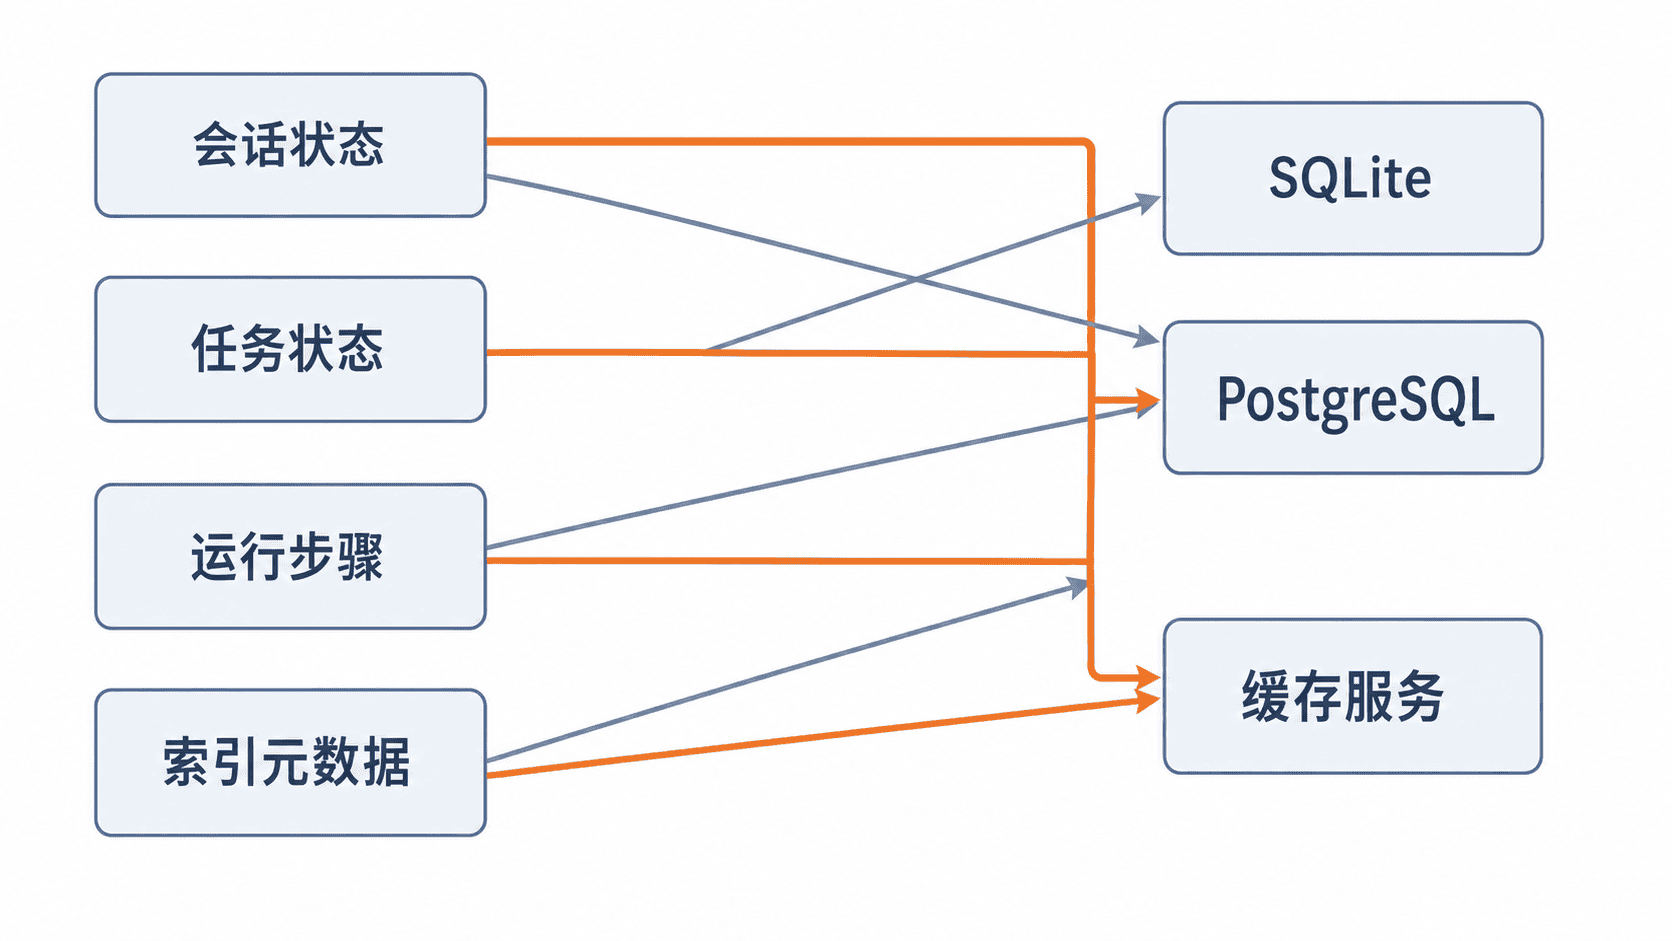
智能体运行过程中会产生短期上下文和长期业务状态。短期上下文用于支持当前推理流程,长期状态则需要跨进程、跨重启保存,例如用户会话、任务进度、工具调用记录和知识索引元数据。
如果所有状态只保存在内存中,应用重启后会丢失执行现场,也无法支持多实例部署。因此需要根据数据访问特点选择合适存储。
使用 SQLite 保存基础状态
SQLite 适合单机开发、原型验证和轻量部署。它不需要独立数据库服务,可以直接保存关系数据,方便快速建立智能体运行记录。
例如可以创建简单的会话表保存用户和智能体之间的交互关系。
python
import sqlite3

conn = sqlite3.connect("agent.db")

# 保存最小会话状态
conn.execute("""
CREATE TABLE IF NOT EXISTS sessions (
    id TEXT PRIMARY KEY,
    user_id TEXT,
    status TEXT
)
""")

conn.execute(
    "INSERT INTO sessions VALUES (?, ?, ?)",
    ("<ID>", "user-1", "running")
)
conn.commit()
预期输出
text
数据库文件 agent.db 创建成功,会话记录写入完成SQLite 的优势是简单可靠,但在高并发、多实例服务中会受到连接和扩展能力限制。
迁移到 PostgreSQL 或缓存服务的判断
当智能体进入生产环境,需要根据数据特点拆分存储职责。
关系型数据例如用户、任务、权限和审计记录适合 PostgreSQL,因为它支持事务、索引和复杂查询。高频变化状态例如临时上下文、任务锁和过期信息,更适合 Redis 等缓存服务。
常见迁移信号包括:
- 多个智能体实例同时访问同一状态
- 数据规模增长导致查询变慢
- 需要事务一致性和复杂统计查询
- 需要低延迟读取临时运行状态
本课总结
- 状态持久化需要先区分会话、任务、运行记录和缓存数据。
- SQLite 适合开发和轻量场景,生产环境通常需要更强的数据服务。
- PostgreSQL 与缓存服务应根据数据访问模式组合使用。
下一课预告
下一课将继续分析代码检索与解析技术,了解智能体如何理解项目结构并定位代码信息。
按自己的节奏,确认真正理解。