
AI Agent / 系统课时
按需读取源码
按需读取源码
本节解决智能体上下文过载的问题,让代码理解过程从“加载整个项目”变为“搜索定位后读取必要文件”。通过建立按需读取策略,智能体可以减少无关信息干扰,在更小的上下文窗口内完成更准确的代码分析。
学习目标
- 理解为什么智能体不应直接读取完整代码库。
- 掌握搜索、定位、读取源码的基本工作流。
- 能够设计适合代码任务的渐进式上下文加载策略。
为什么需要按需读取源码
大型项目通常包含大量文件、依赖和历史代码。如果智能体一次性加载整个仓库,会导致上下文窗口被低价值内容占用,同时降低模型对关键代码关系的判断能力。
按需读取的核心思想是先缩小范围,再深入理解。智能体先根据任务描述寻找可能相关的文件、符号或目录,再读取必要代码片段,而不是把整个项目作为输入。
例如,修复一个登录接口问题时,优先读取认证控制器、用户服务和相关配置,比读取整个前端、测试和脚本目录更有效。
按需读取的基本流程
一个典型源码读取流程可以分为搜索、筛选和加载三个阶段:
- 根据任务关键词搜索文件名、类名、函数名或接口路径。
- 根据调用关系和目录结构筛选高相关候选文件。
- 读取核心代码,并根据发现继续扩展上下文。
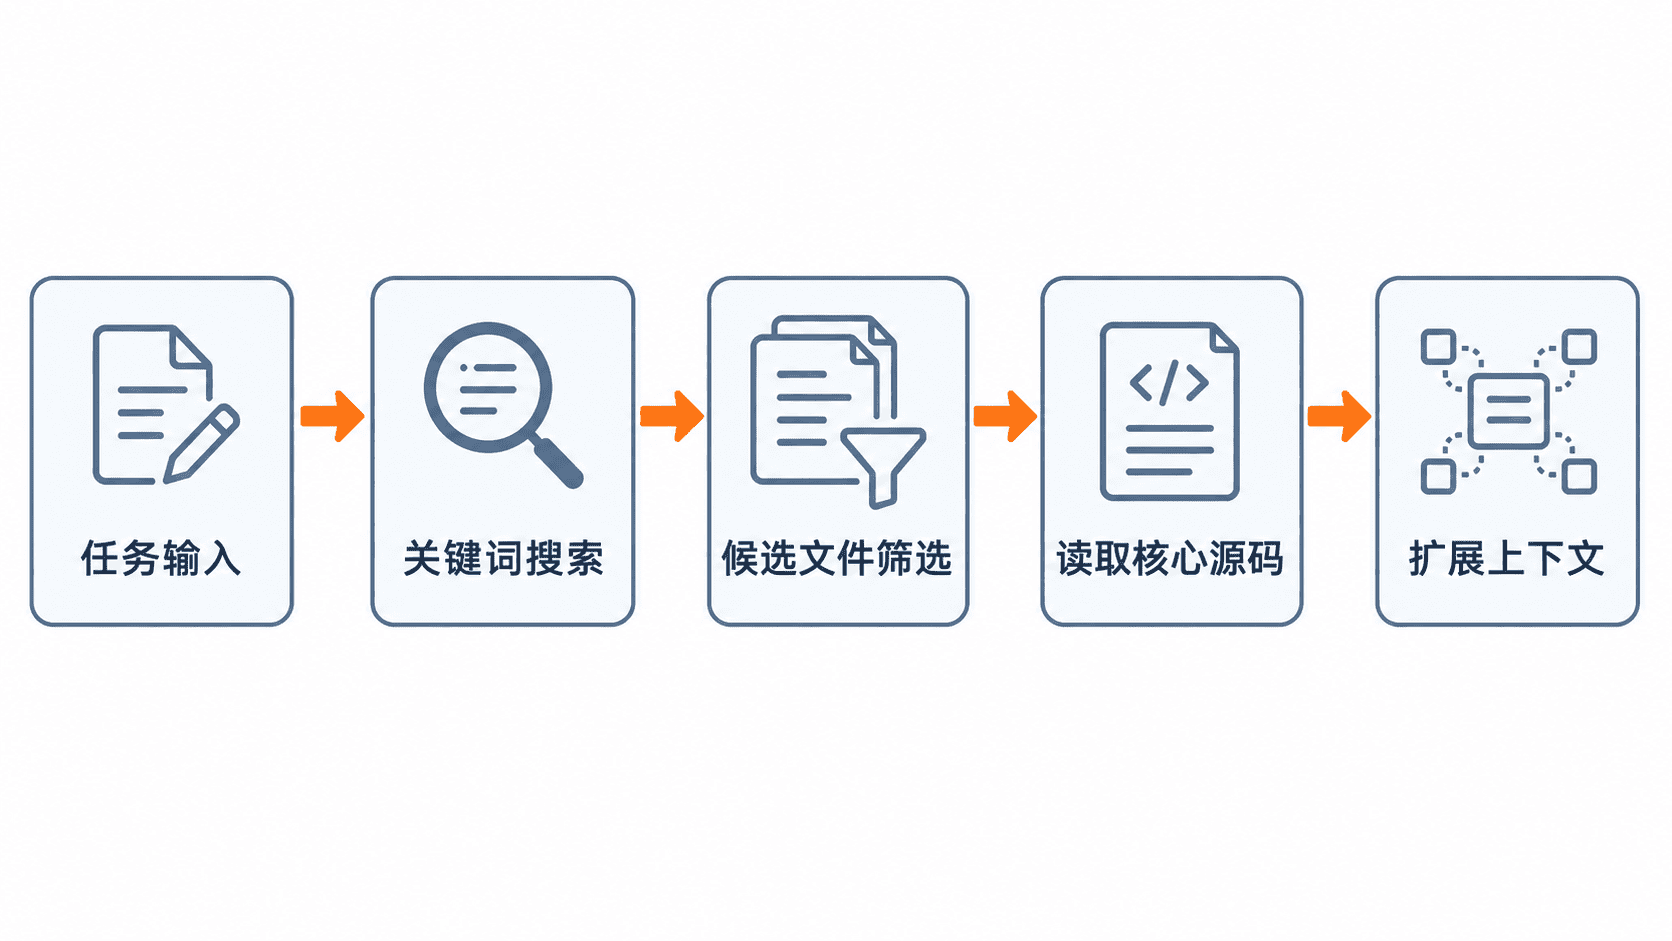
例如,一个代码搜索工具可以先返回候选文件,再由智能体决定读取范围:
python
from pathlib import Path


def find_source_files(root: str, keyword: str):
    """搜索包含关键词的源码文件,避免读取整个项目。"""
    results = []
    for path in Path(root).rglob("*.py"):
        if keyword.lower() in path.read_text(encoding="utf-8", errors="ignore").lower():
            results.append(str(path))
    return results

files = find_source_files("<PATH>", "login")
print(files[:3])
预期输出
text
['app/auth/login.py', 'app/services/user.py']实际项目中的搜索工具可能返回更多元数据,例如符号位置、调用关系和代码摘要,帮助智能体进一步决定读取哪些片段。
渐进式扩大上下文
按需读取并不是只读取一个文件,而是根据当前证据逐步扩大范围。
第一轮通常读取入口代码,例如接口层或命令入口;第二轮读取它依赖的业务逻辑;第三轮才补充配置、测试或相关实现。
这种方式类似人工排查代码问题的过程:先确认入口,再追踪调用链,最后查看细节。
需要避免的错误是读取过少上下文。例如只读取一个函数定义,却忽略它依赖的配置或数据库模型,可能导致智能体提出错误修改方案。
本课总结
- 按需读取源码可以减少无关上下文,提高智能体分析准确率。
- 搜索定位、候选筛选和渐进加载是源码理解的核心流程。
- 上下文应该随着证据增加而扩展,而不是一次性全部注入。
下一课预告
下一节将继续优化上下文工程,学习如何对多个候选上下文进行排序,让智能体优先使用价值更高的信息。
按自己的节奏,确认真正理解。