
AI Agent / 系统课时
区分状态与记忆
区分状态与记忆
本篇解决智能体开发中状态和记忆混用的问题。通过区分当前执行状态、历史会话记忆和长期项目知识,建立合理的数据职责边界,使智能体能够稳定推进任务并正确利用历史信息。
学习目标
- 理解状态、短期记忆和长期记忆的区别。
- 掌握不同信息应该保存在哪里。
- 能够设计基础的智能体信息管理结构。
状态与记忆的职责区别
状态描述的是智能体当前正在执行什么,它通常具有临时性。例如当前步骤、工具调用结果、等待中的审批信息,都属于任务状态。任务结束后,这些状态通常会被清理。
记忆则用于保存未来仍可能有价值的信息。它可以来自历史对话、用户偏好、项目知识或经验总结,生命周期通常比一次任务更长。
| 类型 | 作用范围 | 生命周期 | 示例 |
|---|---|---|---|
| 当前状态 | 当前任务执行 | 分钟到小时 | 当前步骤、工具结果 |
| 会话记忆 | 当前用户交流 | 一次或多次会话 | 用户最近需求 |
| 长期知识 | 跨任务复用 | 长期保存 | 项目规范、技术文档 |
设计信息存储边界
如果把所有信息都当作记忆保存,会导致存储膨胀和检索噪声增加。如果把所有信息都当作临时状态,又会丢失可复用经验。
一个简单的状态结构可以只保存当前执行所需字段:
json
{
  "taskId": "<ID>",
  "currentStep": "calling_tool",
  "pendingAction": "query_database",
  "temporaryResult": "user record loaded"
}
预期结果
text
状态对象仅用于恢复当前任务执行,不代表长期知识。在智能体中的组合方式
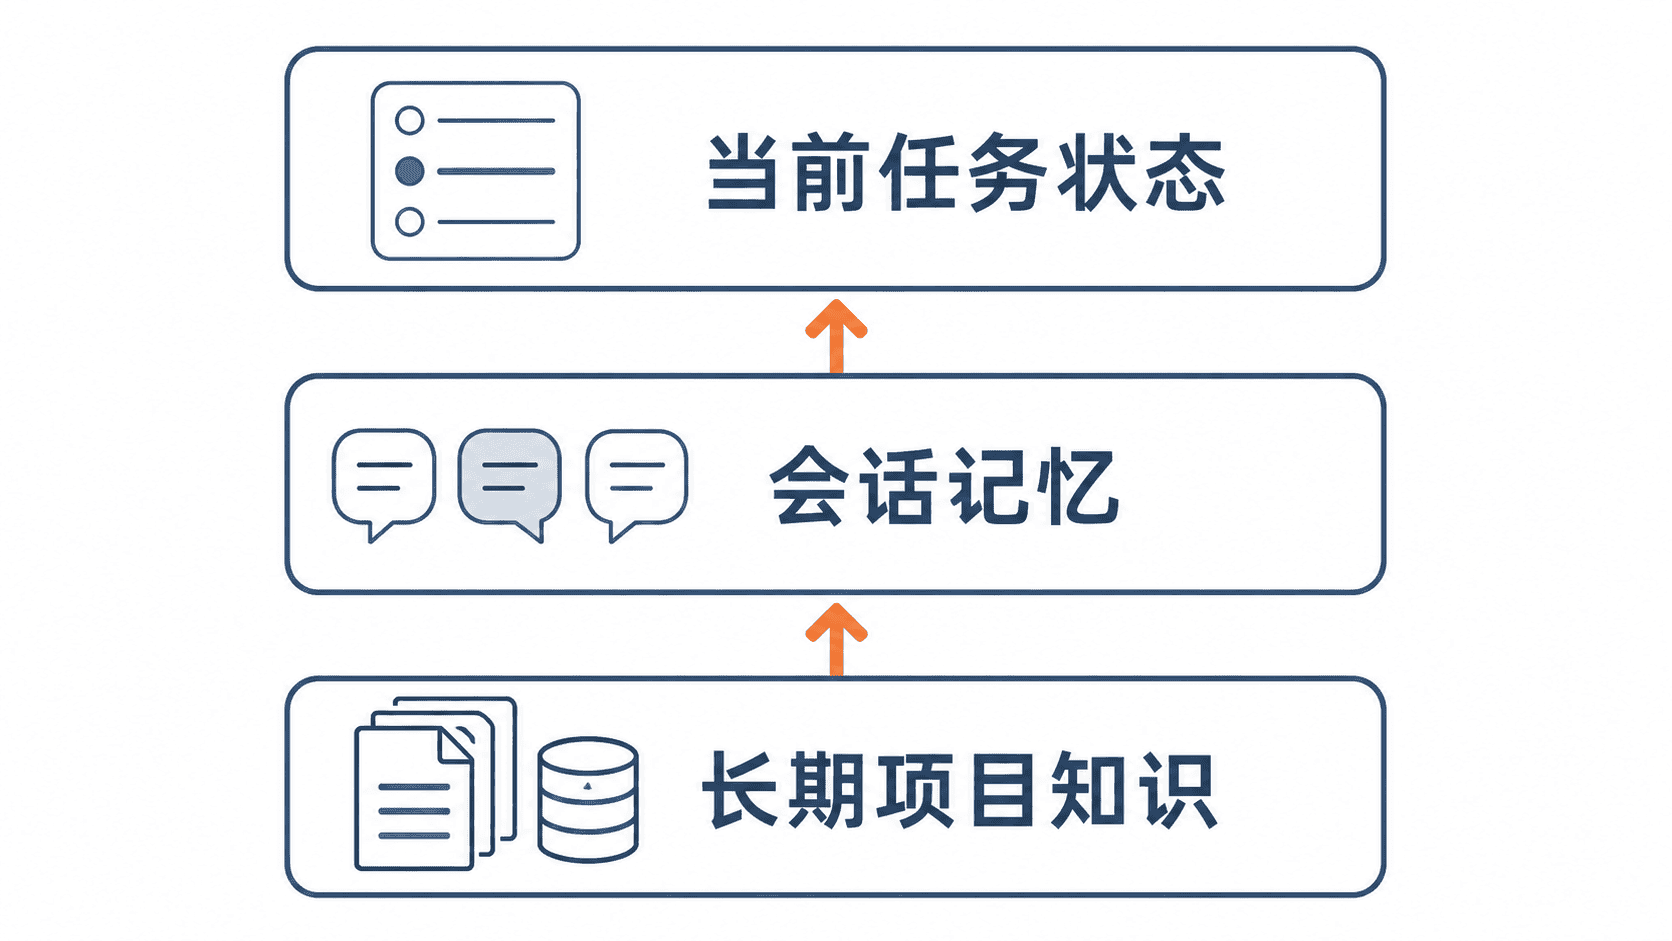
实际系统通常会同时使用三层信息:状态负责控制流程,短期记忆负责保持连续对话,长期知识负责提供稳定背景。
例如一个代码助手执行修复任务时,当前修改文件列表属于状态;用户刚刚说明的代码风格偏好属于会话记忆;团队编码规范文档属于长期知识。
常见设计错误
一种常见错误是把完整聊天记录直接作为长期记忆。这样会保存大量偶然信息,例如临时错误、无关讨论和过期需求。
更好的方式是先提取稳定事实,再存入记忆。例如保存“项目使用 TypeScript”和“接口需要统一错误格式”,而不是保存一次完整聊天过程。
本课总结
- 状态服务于当前执行,记忆服务于未来复用,两者职责不同。
- 短期记忆和长期知识需要根据生命周期分别管理。
- 良好的信息边界能够降低检索噪声,提高智能体稳定性。
下一课预告
下一课将进一步实现会话持久化,让智能体能够安全保存并恢复用户交互过程。
按自己的节奏,确认真正理解。