
AI Agent / 系统课时
识别智能体风险
识别智能体风险
智能体拥有执行命令、修改代码和访问项目资源的能力,也因此可能产生新的安全风险。本课从工程角度分析误删文件、危险命令、提示词注入、越权访问和无限循环等问题,并建立风险识别方法。
学习目标
- 了解代码智能体运行中的主要风险类型。
- 掌握风险产生的位置和触发条件。
- 为后续安全策略设计建立风险分类基础。
智能体风险来自哪里
传统程序通常按照固定逻辑执行,而智能体会根据上下文动态决定下一步动作。当它拥有工具调用能力后,风险不只来自代码漏洞,也来自错误决策、恶意输入和权限边界不足。
风险识别的第一步是明确智能体可以影响什么对象,包括文件系统、命令执行环境、网络资源、代码仓库和外部服务。
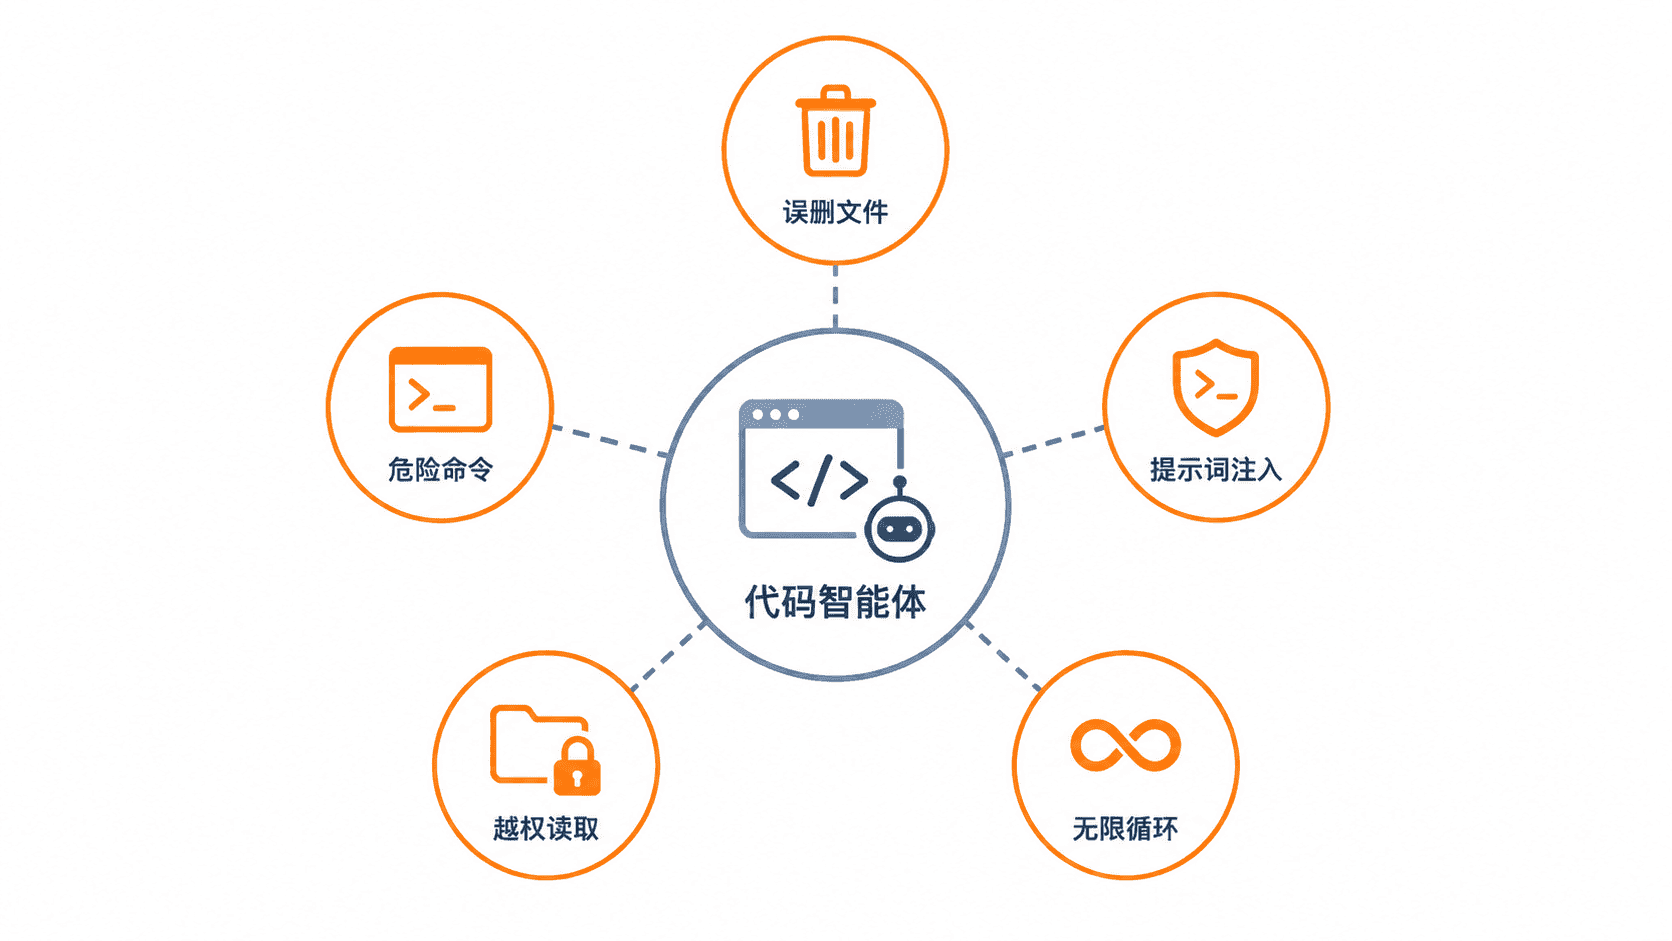
常见风险类型
文件操作风险通常发生在自动修改代码时,例如 Agent 错误理解需求后删除重要文件,或者覆盖未提交的用户修改。
命令执行风险来自工具权限过大。一个允许执行任意 Shell 命令的 Agent 可能运行破坏性操作,因此危险命令必须经过限制和确认。
提示词注入风险来自外部内容。代码注释、文档或网页内容可能包含诱导模型泄露信息或执行异常操作的指令。
越权风险表示 Agent 能访问超过任务需要的资源,例如读取无关项目文件、访问敏感配置或调用不必要的外部接口。
无限循环风险通常出现在自动修复流程中。当验证失败后不断重试,却没有最大次数和停止条件时,会导致资源浪费。
yaml
risks:
  - name: file_delete
    trigger: agent modifies files
  - name: dangerous_command
    trigger: tool execution
  - name: prompt_injection
    trigger: external content
  - name: privilege_escalation
    trigger: excessive permission
  - name: infinite_loop
    trigger: repeated retry
预期结果
text
风险清单被结构化记录,可用于后续安全策略匹配。建立风险识别流程
工程实现中,可以在任务开始前分析工具权限,在执行过程中记录行为,在结束后检查异常结果。风险识别不是单点检查,而是贯穿智能体生命周期的过程。
ts
function classifyRisk(action: string): string {
  const dangerousActions = ["delete", "shell", "network"];

  if (dangerousActions.includes(action)) {
    return "high-risk";
  }

  return "normal";
}

const risk = classifyRisk("shell");
预期输出
text
high-risk识别风险后,系统才能进一步决定是否需要人工确认、限制权限、隔离环境或阻止执行。
风险分析的工程原则
不要试图消除所有风险,因为完全禁止执行能力会削弱智能体价值。更合理的方式是建立风险分级,让低风险操作自动完成,高风险操作进入保护流程。
可靠智能体的基础不是更强的自主能力,而是在自主执行和安全边界之间建立清晰规则。
按自己的节奏,确认真正理解。