
AI Agent / 系统课时
管理上下文预算
管理上下文预算
本篇解决智能体运行过程中 Token 资源分配失衡的问题,通过为系统规则、源码、历史消息和工具结果建立预算策略,让 Agent 在有限上下文窗口内保持稳定推理能力。
学习目标
- 理解上下文预算中不同信息类型的优先级
- 掌握动态调整 Token 分配的方法
- 能够设计避免上下文溢出的 Agent 调度策略
上下文预算是什么
上下文窗口是 Agent 每次推理能够看到的信息总量。它通常包含系统规则、用户输入、历史对话、工具调用结果以及外部资料。
如果所有内容无限追加,早期消息会挤占后续任务需要的信息空间。因此需要像管理内存一样管理 Token,将有限容量分配给最有价值的信息。
一个常见预算模型如下:
| 内容类型 | 作用 | 优先级 |
|---|---|---|
| 系统规则 | 约束行为和安全边界 | 高 |
| 当前任务信息 | 指导本轮决策 | 高 |
| 工具结果 | 提供外部事实 | 中高 |
| 历史消息 | 保持连续性 | 中 |
| 长文档片段 | 提供详细依据 | 按需 |
设计预算分配策略
固定预算适合简单场景,例如始终保留固定比例给系统规则和用户输入。
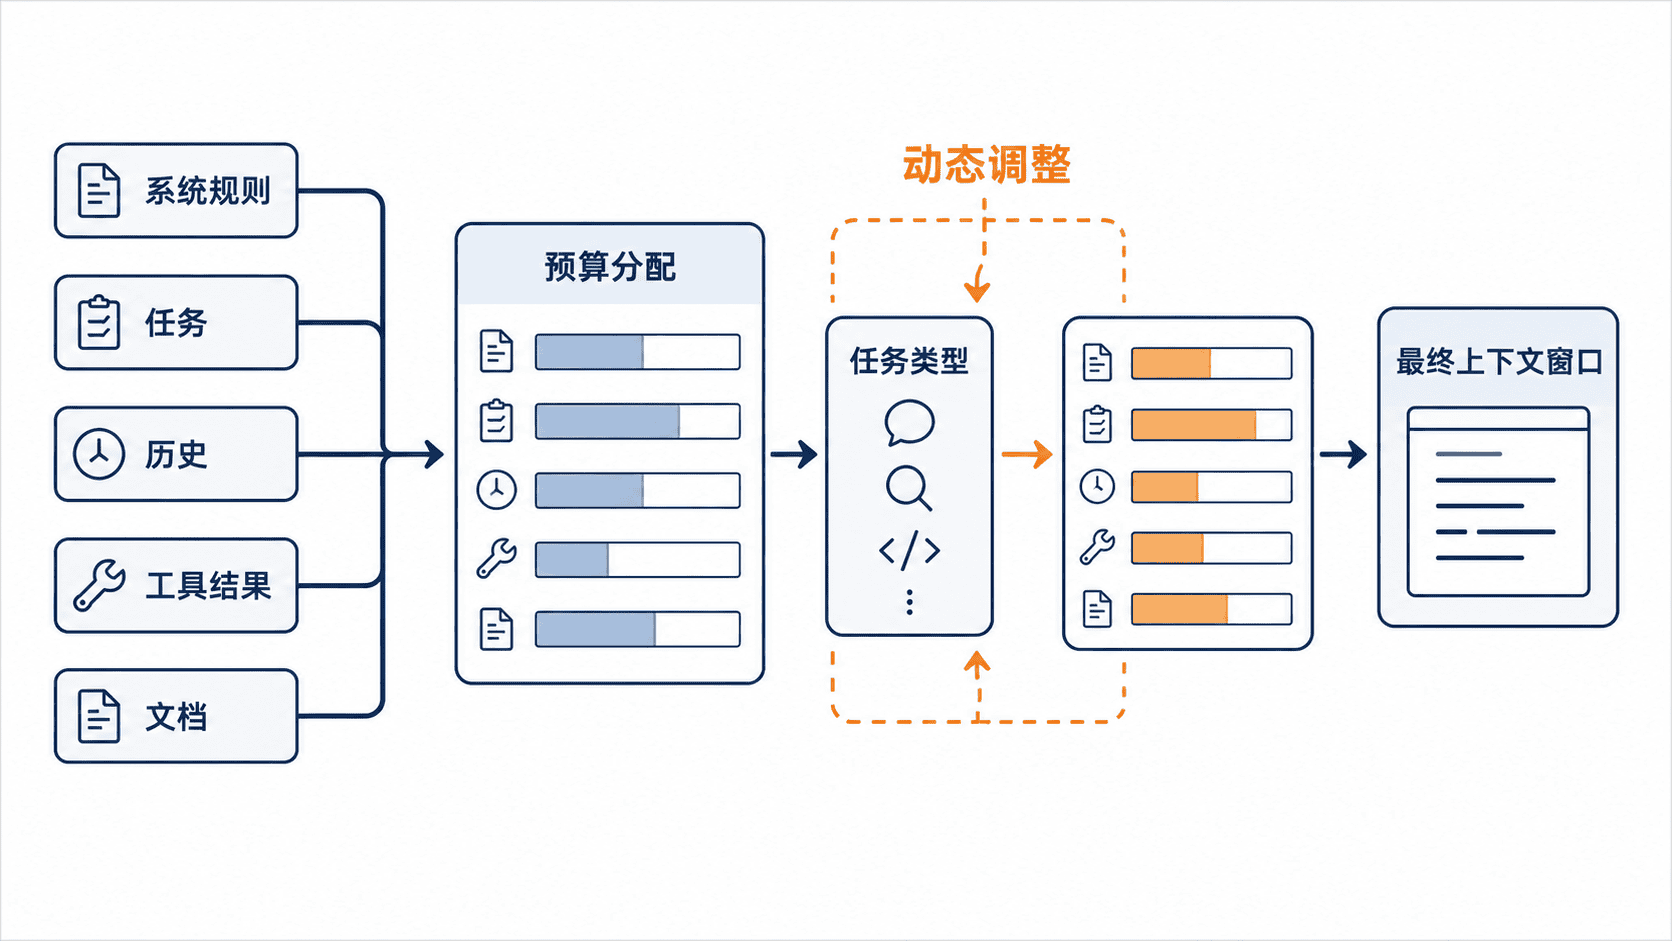
动态预算更适合复杂 Agent。系统可以根据任务阶段调整空间:
- 编码任务增加源码和错误日志比例
- 问答任务增加知识检索结果比例
- 多轮任务压缩较早历史消息
例如可以定义一个简单预算配置:
python
context_budget = {
    "system": 2000,
    "task": 4000,
    "history": 3000,
    "tools": 5000,
    "documents": 6000,
}

# 根据当前任务重新分配文档空间
if task_type == "code_review":
    context_budget["documents"] += 2000

print(context_budget)
预期输出
text
{'system': 2000, 'task': 4000, 'history': 3000, 'tools': 5000, 'documents': 8000}实际数值应根据模型上下文窗口和业务需求调整。
动态压缩历史信息
历史消息通常是最容易膨胀的部分。保留全部对话会增加成本,但完全删除又会损失上下文连续性。
常用方法是将旧消息转换为摘要,只保留:
- 已完成的重要决定
- 用户明确提出的约束
- 未解决的问题
- 后续行动计划
当前正在处理的问题则保留原始消息,避免摘要损失细节。
防止预算失控
上下文管理失败通常表现为:
- 工具结果过长导致模型忽略任务要求
- 历史消息累积导致响应变慢
- 文档全部注入导致关键指令被稀释
解决方式包括限制单次工具返回长度、对重复内容去重、设置最大历史窗口以及优先保留高价值信息。
验证预算效果
可以通过记录每次请求的 Token 使用情况验证策略是否有效。
python
usage = {
    "before_compression": 18000,
    "after_compression": 7500,
}

saved = usage["before_compression"] - usage["after_compression"]
print(f"saved tokens: {saved}")
预期输出
text
saved tokens: 10500实际节省量取决于输入内容规模和压缩策略。
本课总结
- 上下文预算需要区分信息价值,而不是平均分配 Token。
- 动态预算能够适应不同 Agent 任务阶段。
- 历史、文档和工具结果都应该支持压缩与按需加载。
下一课预告
下一课将进入上下文工程的综合设计阶段,学习如何把索引、压缩和预算策略组合成完整 Agent 上下文系统。
按自己的节奏,确认真正理解。