
AI Agent / 系统课时
确定整体技术栈
确定整体技术栈
本课解决智能体项目启动阶段的技术选型问题,目标是从模型接入到客户端展示建立完整技术边界。通过拆分核心模块和职责,可以避免后续开发中出现组件重复、通信混乱和扩展困难。
学习目标
- 理解智能体系统中主要技术层的职责划分。
- 能根据项目目标选择模型、运行时、存储和通信方案。
- 建立可扩展 Agent 工程架构的初步设计能力。
从需求反推技术分层
智能体系统不是单一模型调用程序,而是由多个协作模块组成。确定技术栈时,应先明确每一层解决的问题,再选择对应技术,而不是先决定框架后强行适配业务。
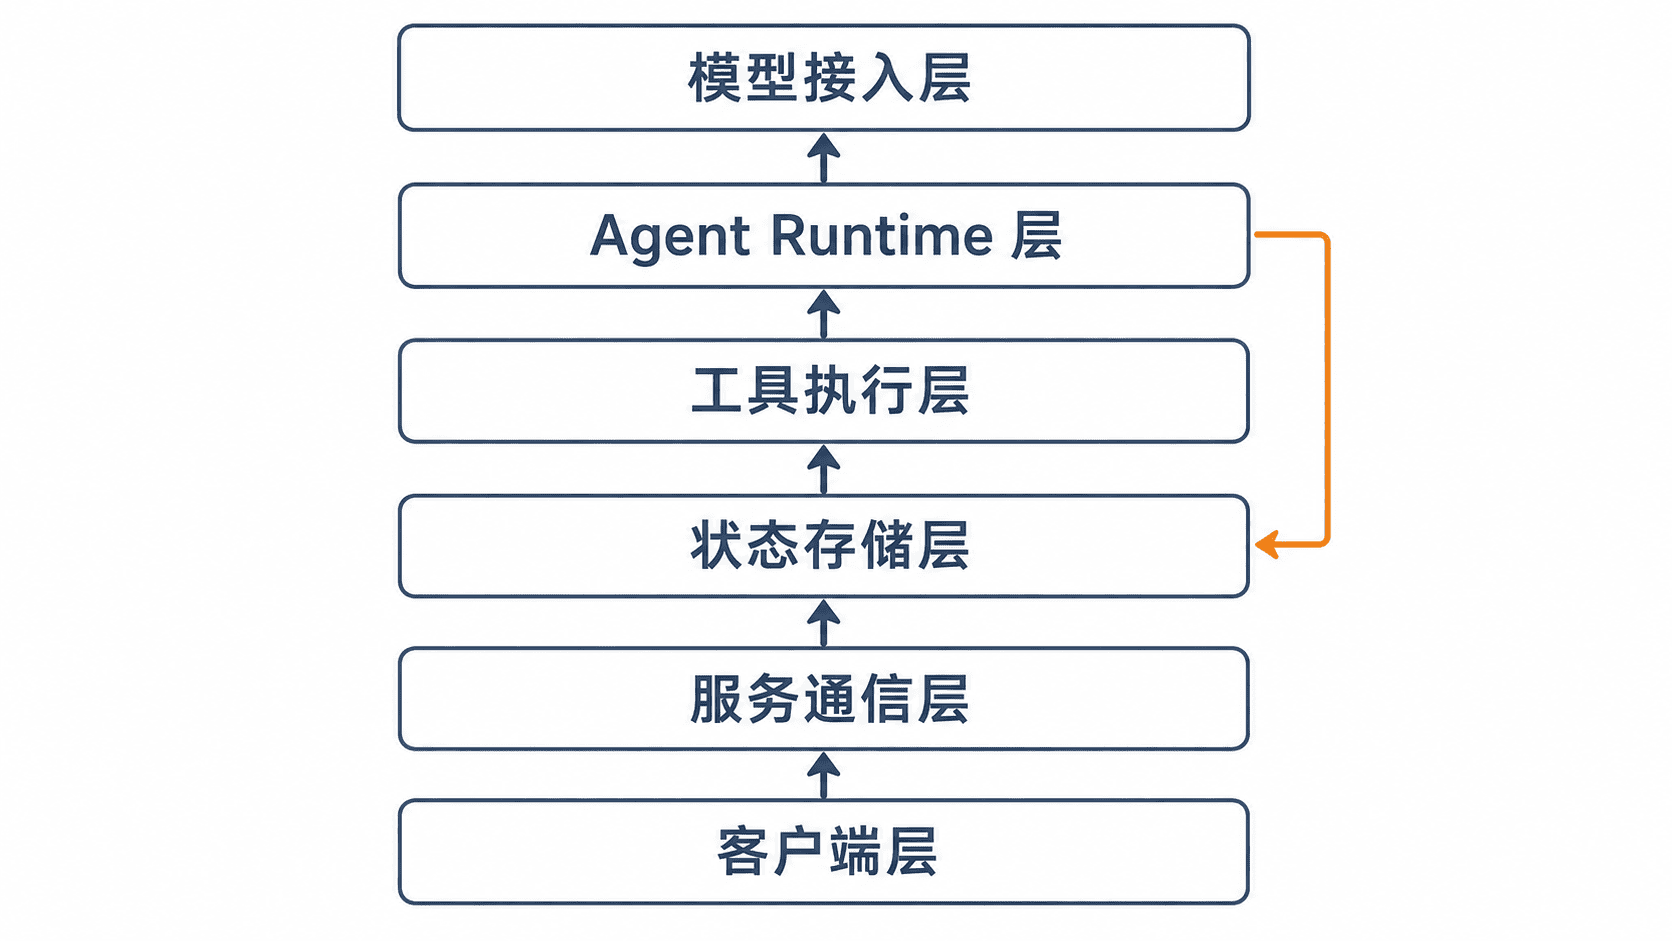
一个完整 Agent 通常包含模型层、Runtime 层、工具执行层、状态存储层、服务通信层以及客户端层。不同项目可以替换其中部分实现,但模块边界应保持稳定。
确定核心技术模块
模型接入负责提供推理能力,需要考虑模型来源、调用方式和成本控制。例如可以连接云端模型 API,也可以接入本地部署模型。工程上通常通过统一模型接口隔离具体供应商差异。
Agent Runtime 是智能体执行流程的核心,负责管理思考、调用工具、处理结果和循环控制。它决定系统是否具备持续完成复杂任务的能力。
工具执行层负责连接外部能力,包括数据库查询、代码执行、搜索服务和业务接口。该层需要明确权限边界,避免模型直接获得过高操作权限。
状态存储用于保存会话历史、任务上下文和长期记忆。短期状态适合放在缓存中,长期知识通常需要结合数据库或向量存储。
设计技术方案示例
在实际项目中,可以先定义模块接口,再决定具体实现。下面是一个简化的技术栈配置示例:
model:
  provider: cloud-api
  interface: unified-chat
runtime:
  type: agent-loop
storage:
  session: redis
  knowledge: vector-database
communication:
  protocol: http
client:
  type: web-app
预期结果
项目技术边界已经明确:模型、Runtime、存储、通信和客户端分别拥有独立职责。这种设计可以让后续替换模型或升级 Runtime 时,不需要重写整个应用。关键不是选择某个固定技术,而是保证模块之间通过稳定接口协作。
技术选型中的常见误区
第一类问题是过早绑定框架。某些项目一开始直接选择复杂 Agent 框架,却没有明确任务流程,最后只能围绕框架限制修改业务。
第二类问题是忽略运行环境。实验型 Agent 和生产型 Agent 对日志、权限、状态恢复和部署方式的要求完全不同。
第三类问题是把模型能力等同于系统能力。模型只负责生成判断结果,真正可靠的智能体还需要工程控制、工具约束和状态管理。
本课总结
- 智能体技术栈应围绕模块职责设计,而不是围绕单一框架设计。
- 模型、Runtime、工具、存储、通信和客户端需要保持清晰边界。
- 良好的技术分层可以降低后续扩展和维护成本。
下一课预告
下一课将进一步分析 Agent Runtime 的不同实现路线,比较直接调用模型、框架方案和自研 Runtime 的适用场景。