
AI Agent / 系统课时
检索长期记忆
检索长期记忆
本篇解决智能体如何按当前任务查找相关记忆,避免每次把全部历史信息注入模型,从而降低上下文压力并提高回答准确性。
学习目标
- 理解按需检索长期记忆的必要性
- 掌握基于任务上下文筛选记忆的方法
- 了解记忆检索结果如何参与智能体决策
为什么不能加载全部记忆
随着项目规模增加,长期记忆会不断增长。如果每次请求都把所有记忆发送给模型,会浪费上下文窗口,并引入无关信息干扰。
更合理的方式是根据当前任务生成查询条件,只检索可能有帮助的事实。
构建记忆检索流程
一个基础检索流程包含三个阶段:分析当前任务、生成查询条件、返回相关事实。
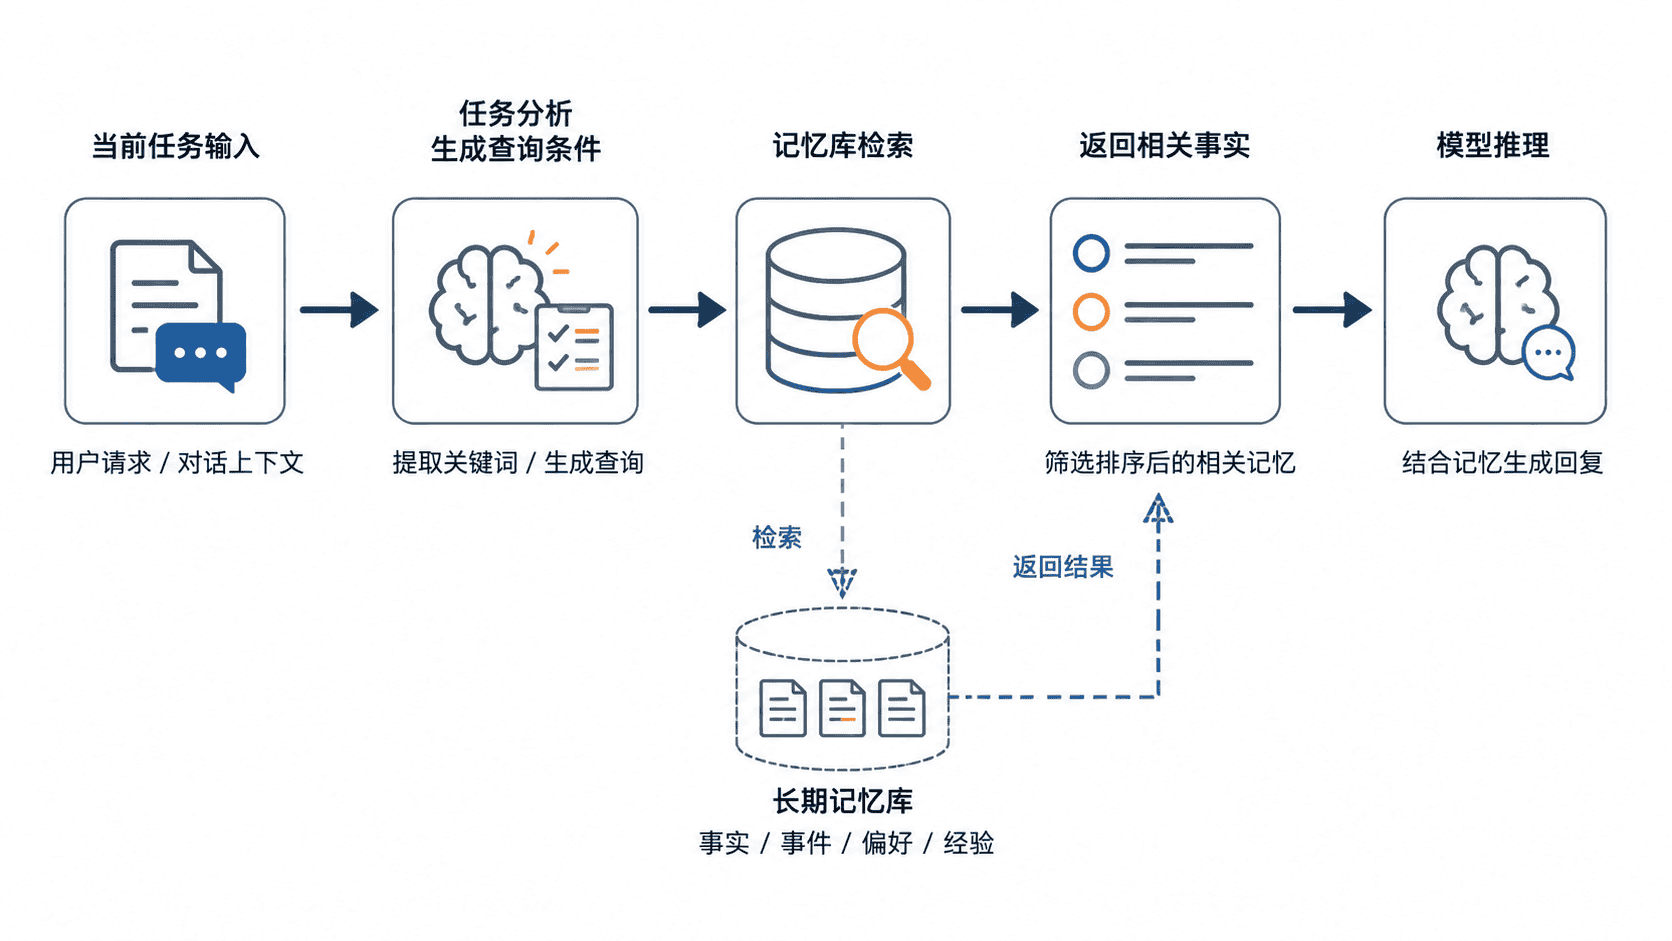
下面是一个最小检索示例,根据关键词过滤已有事实:
python
memories = [
    {"key": "framework", "value": "项目使用 Spring Boot 3"},
    {"key": "command", "value": "使用 ./gradlew test 执行测试"},
    {"key": "style", "value": "接口返回统一 Result 结构"}
]

def search_memory(keyword):
    # 仅返回与当前任务相关的记忆
    return [m for m in memories if keyword in m["value"]]

result = search_memory("Spring")
print(result)
预期输出
text
[{'key': 'framework', 'value': '项目使用 Spring Boot 3'}]实际系统中通常会使用向量检索、标签过滤或混合检索,让查询结果不仅匹配关键词,还能理解语义关系。
控制检索结果质量
记忆检索不是简单地找到越多越好,而是要控制相关性和数量。
常见优化方式包括:
- 根据任务类型限制检索范围
- 给重要事实设置更高优先级
- 定期删除过期或冲突信息
- 保存事实来源,便于追踪可信度
如果检索结果过多,模型可能无法判断哪些信息更重要;如果结果过少,又可能缺少必要上下文。
检索结果如何进入智能体执行
检索到的记忆通常不会直接替代模型判断,而是作为额外上下文参与规划、工具调用和结果生成。
例如执行代码任务时,智能体可以先读取项目约定,再决定使用哪条命令、修改哪些文件以及如何验证结果。
本课总结
- 长期记忆应该按需检索,而不是全部加载。
- 检索流程需要结合任务上下文筛选高价值信息。
- 高质量记忆系统需要同时关注相关性、时效性和可维护性。
下一课预告
下一课将继续介绍任务状态管理,让智能体能够记录执行进度并恢复中断后的工作流程。
按自己的节奏,确认真正理解。