
AI Agent / 系统课时
排序候选上下文
排序候选上下文
本节解决智能体面对多个可能相关文件时不知道优先读取什么的问题。通过建立候选上下文排序机制,智能体能够综合路径、符号关系、访问记录和任务目标,选择最有价值的代码进入上下文。
学习目标
- 理解候选上下文排序对代码智能体的重要性。
- 掌握影响上下文价值的主要排序因素。
- 能够设计简单的候选文件评分策略。
为什么需要排序候选上下文
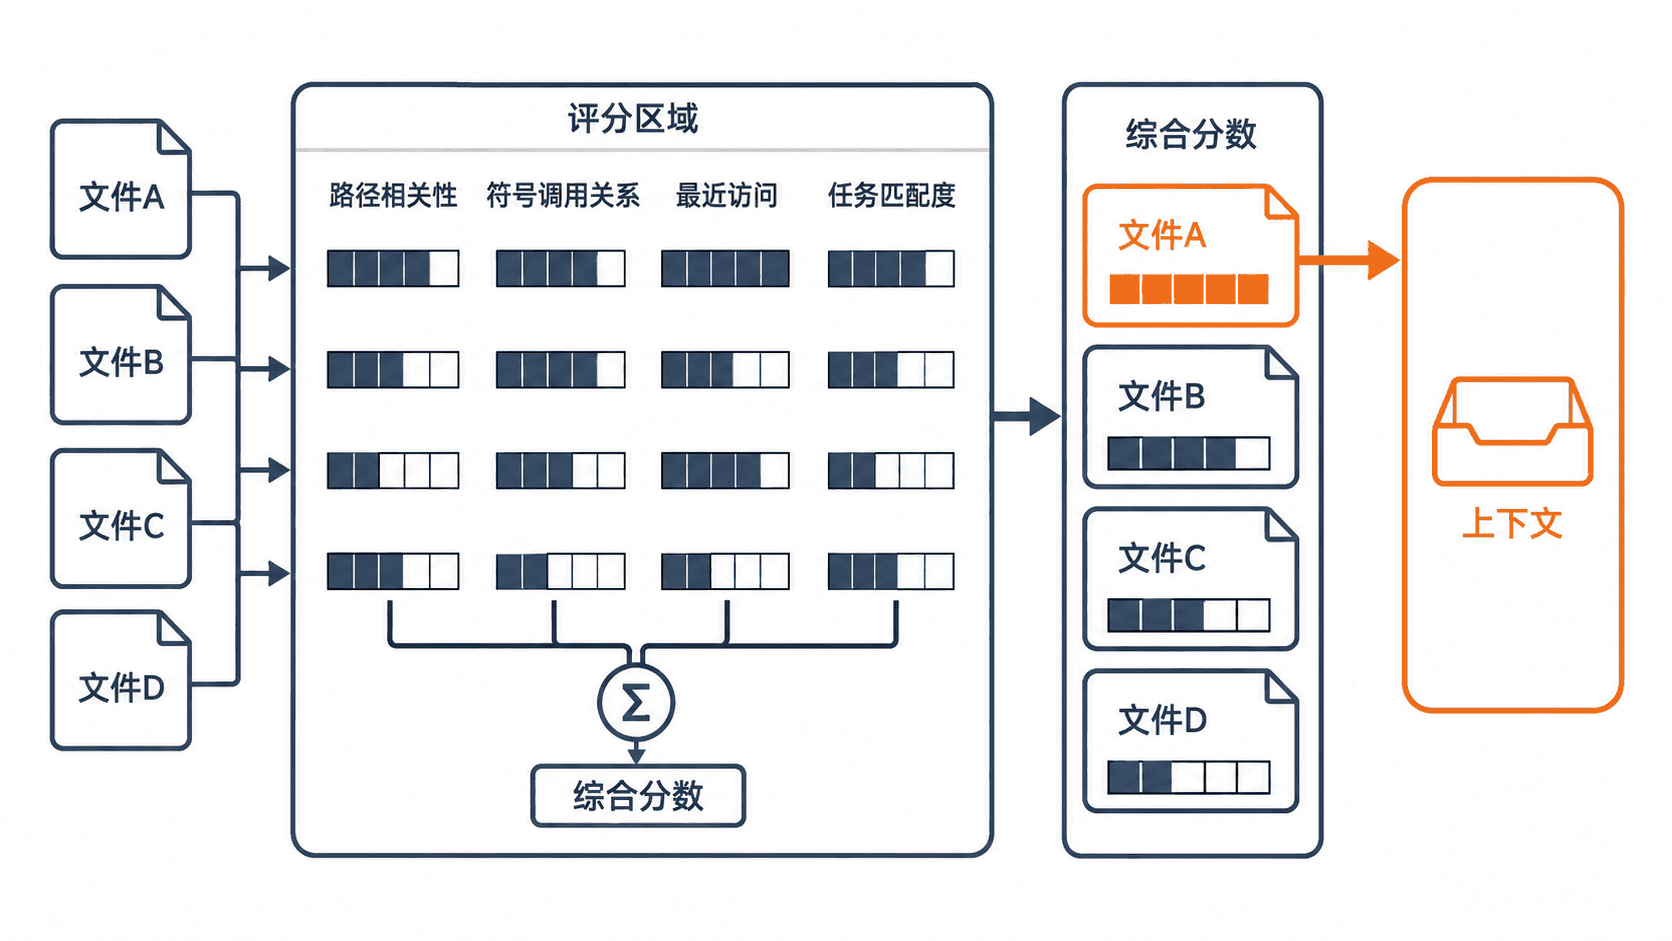
代码搜索通常会返回多个结果。例如搜索“用户登录”可能同时找到控制器、服务层、测试文件和历史实现。如果所有结果都平等加载,智能体仍然需要消耗大量上下文判断哪些内容重要。
候选上下文排序的目标是提前提升高价值信息,让模型优先看到最可能解决问题的代码。
上下文价值通常不是由单一因素决定,而是多个信号共同作用。
影响上下文价值的关键因素
常见排序信号包括:
| 信号 | 作用 |
|---|---|
| 路径相关性 | 判断文件是否位于目标模块或业务目录 |
| 符号关系 | 判断类、函数是否直接参与调用链 |
| 最近访问 | 利用当前任务中的已有线索 |
| 任务匹配度 | 判断内容是否符合用户问题 |
例如修改订单创建逻辑时,order/service.py 通常比同名测试文件拥有更高优先级,但测试文件仍可能作为验证上下文被后续读取。
建立简单评分模型
实际系统可以使用规则评分,也可以结合向量检索和模型判断。一个简单模型可以将多个因素组合:
其中 表示路径相关性, 表示符号关系, 表示访问历史, 表示任务匹配度, 表示不同因素权重。
下面是一个简单的候选排序示例:
python
candidates = [
    {"file": "order/service.py", "path": 0.9, "symbol": 0.8, "recent": 0.5},
    {"file": "tests/order_test.py", "path": 0.6, "symbol": 0.4, "recent": 0.8},
]

for item in candidates:
    item["score"] = item["path"] * 0.5 + item["symbol"] * 0.3 + item["recent"] * 0.2

ranked = sorted(candidates, key=lambda x: x["score"], reverse=True)
print(ranked[0]["file"])
预期输出
text
order/service.py这个示例只展示排序逻辑。实际智能体还需要结合代码图、语义检索和用户反馈不断调整权重。
排序策略的边界
排序不是简单地永远选择最高分文件,而是在有限上下文预算内选择最佳组合。
有些低评分文件仍然重要,例如异常处理代码、数据库迁移文件或测试用例。智能体需要保留一定探索能力,避免只读取已有认知范围内的内容。
因此,成熟的上下文排序通常采用“高相关优先 + 少量探索”的策略,在效率和完整性之间取得平衡。
本课总结
- 候选上下文排序帮助智能体在有限窗口中优先读取高价值信息。
- 路径、符号关系、访问记录和任务匹配度是常用排序信号。
- 排序需要结合利用和探索,避免遗漏关键代码。
下一课预告
下一节将继续构建上下文工程,学习如何控制上下文预算,让智能体在复杂任务中保持稳定的信息利用效率。
按自己的节奏,确认真正理解。