
机器学习与深度学习 / 系统课时
理解标量、向量与矩阵
理解标量、向量与矩阵
模型接收的数据通常不是零散数字,而是按样本和特征排列的数组。理解标量、向量、矩阵及其形状后,你就能使用 NumPy 检查数据维度、提取指定特征,并将单条样本调整为模型能够接收的二维输入。
学习目标
- 区分标量、向量和矩阵,理解维度与形状的含义。
- 解释机器学习数据的样本轴、特征轴及目标变量的对应关系。
- 使用 NumPy 创建、检查和调整数据结构,避免常见维度错误。
三种基础数据表示
标量是单个数值,例如学习率 0.01;向量是一组有顺序的数值,例如一名用户的多个特征;矩阵是由多行向量组成的二维数据,例如多名用户的特征表。
以用户数据为例,向量 [25, 8000, 12] 分别代表年龄、月收入和登录次数。将三名用户的数据按行排列,就得到一个包含 3 行、3 列的矩阵。每个位置的数值由行索引和列索引共同确定。
NumPy 用数组的轴数描述维度,用 shape 描述各轴长度:
- 标量:零个轴,
ndim为0,形状为()。 - 向量:一个轴,三个元素的形状为
(3,)。 - 矩阵:两个轴,三行三列的形状为
(3, 3)。
需要注意,np.array(0.01) 创建的是零维数组,而普通 Python 浮点数 0.01 本身并不是 NumPy 数组。两者都可以表示标量,但只有前者直接提供 ndim 和 shape 属性。
样本轴与特征轴
机器学习中,特征矩阵通常约定为 (样本数量, 特征数量)。例如形状 (1000, 20) 表示 1000 条样本,每条样本包含 20 个特征。
矩阵的第 0 轴对应样本,沿这个方向移动会切换不同样本;第 1 轴对应特征,沿这个方向移动会切换年龄、收入等不同字段。对于一个三行三列的用户矩阵,第一行是一名用户的完整特征,第二列则是全部用户的月收入。
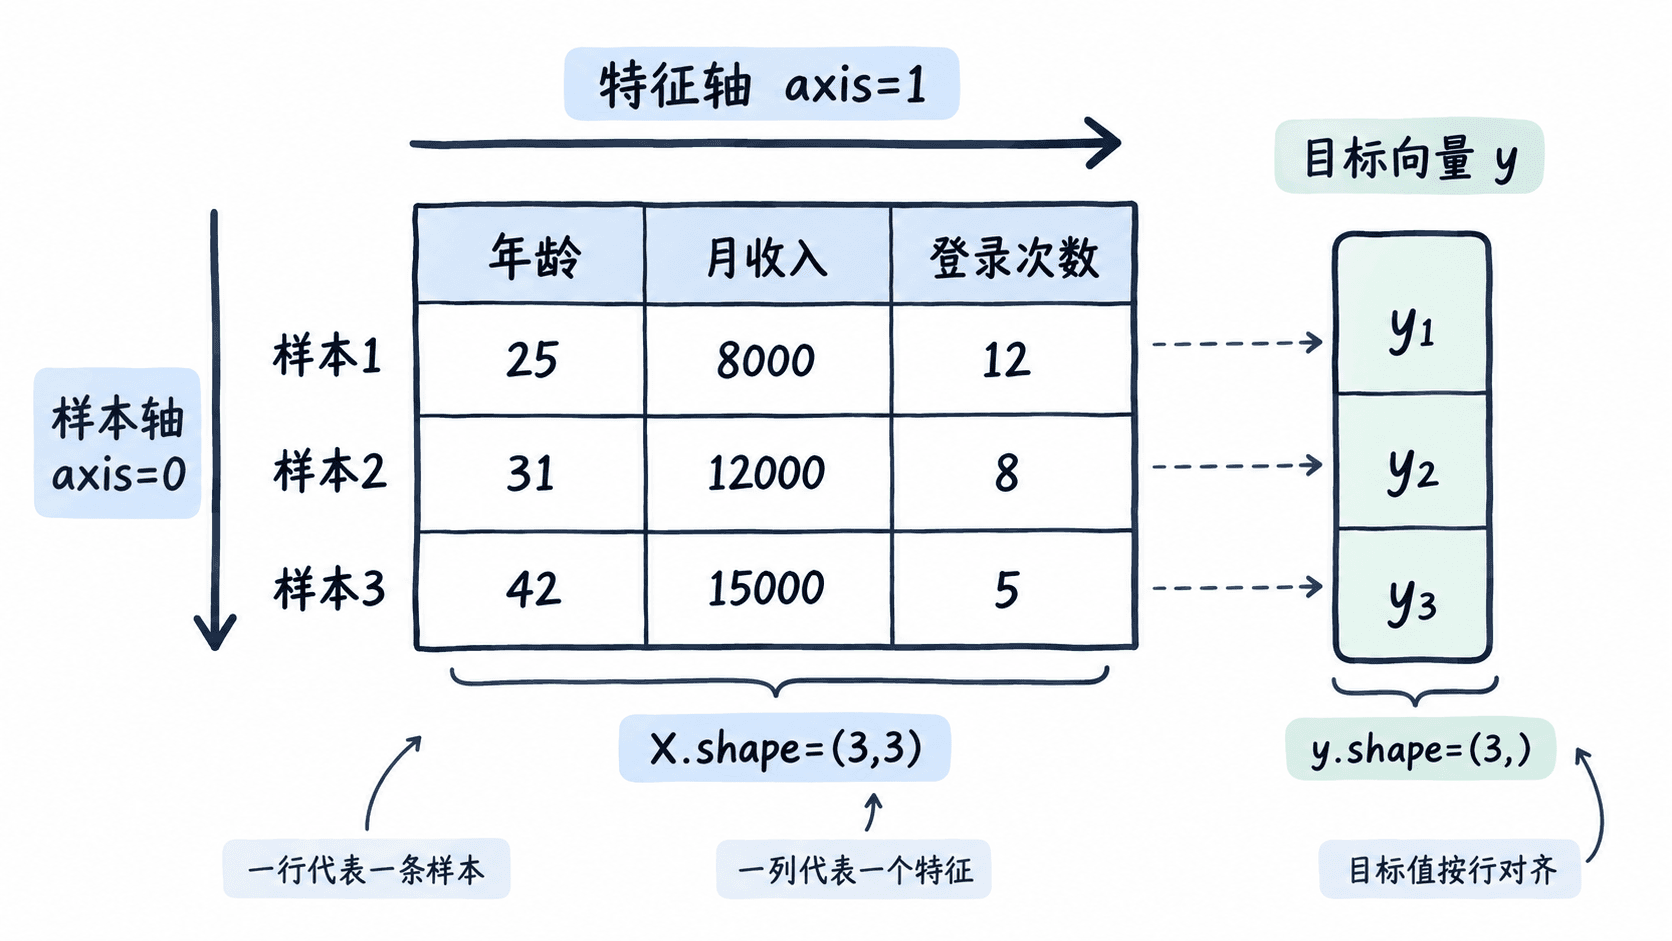
监督学习中的目标变量通常是一个与样本逐行对应的向量。例如特征矩阵 X 的形状为 (1000, 20),每条样本只有一个数值标签时,目标向量 y 的形状通常为 (1000,)。二者第 0 轴的长度必须一致,否则无法正确对应训练样本与标签。多输出任务的目标也可能是二维数组。
使用 NumPy 检查维度
NumPy 的 ndim 返回数组的轴数,shape 返回每个轴的长度。通过行列索引,还可以提取一条样本或指定特征列。以下示例同时检查标量、向量、矩阵和目标变量,并演示单条样本的形状调整。
安装 NumPy 后,将以下代码保存为 matrix_demo.py 并使用 Python 运行。
import numpy as np

learning_rate = np.array(0.01)
user_features = np.array([25, 8000, 12])
dataset = np.array([
    [25, 8000, 12],
    [31, 12000, 8],
    [42, 15000, 5],
])
targets = np.array([0, 1, 0])

# 第0轴表示样本,第1轴表示特征
print("标量维度:", learning_rate.ndim)
print("标量形状:", learning_rate.shape)
print("向量形状:", user_features.shape)
print("矩阵形状:", dataset.shape)
print("第一条样本:", dataset[0])
print("第二个特征列:", dataset[:, 1])
print("目标向量形状:", targets.shape)

# 为单条样本补齐样本轴,不改变特征数量
model_input = user_features.reshape(1, -1)
print("模型输入形状:", model_input.shape)
print("样本与目标数量匹配:", dataset.shape[0] == targets.shape[0])
预期输出:
标量维度: 0
标量形状: ()
向量形状: (3,)
矩阵形状: (3, 3)
第一条样本: [  25 8000   12]
第二个特征列: [ 8000 12000 15000]
目标向量形状: (3,)
模型输入形状: (1, 3)
样本与目标数量匹配: True
dataset[0] 表示取第 0 行,也就是第一条样本;dataset[:, 1] 中的冒号表示保留所有行,1 表示取第 1 列,也就是第二个特征。NumPy 索引从 0 开始。
这里的 targets 是演示用的三个二分类标签。最后一行输出 True,说明特征矩阵的样本数与目标向量长度相等;实际训练时还需要确保标签顺序与样本顺序一致。
维度错误的典型表现
scikit-learn 中多数监督学习估计器要求特征输入为二维矩阵,形状为 (n_samples, n_features)。单条样本 [25, 8000, 12] 的形状是 (3,),缺少样本轴,直接传入模型通常会出现 Expected 2D array 一类错误。
正确做法是使用 reshape(1, -1),得到形状 (1, 3)。其中 1 表示只有一条样本,-1 表示由 NumPy 根据元素总数自动推断该轴长度。前面的示例已经验证了这一结果。
不要将它误写成 reshape(-1, 1):后者会得到 (3, 1),含义变成三条样本、每条只有一个特征。虽然元素数量没有变化,但模型对数据的理解已经不同。
动手验证
- 创建包含 5 条样本、每条 4 个特征的 NumPy 矩阵,输出
shape,再使用[:, 2]提取第 3 个特征列。验证矩阵形状为(5, 4),提取结果形状为(5,)。 - 将长度为 4 的一维向量分别使用
reshape(1, -1)和reshape(-1, 1)转换,比较(1, 4)与(4, 1)的差异,并说明哪一个代表单条样本的四个特征。
处理模型输入时,先用 shape 核对样本数和特征数,再检查目标变量是否与样本逐行对应。遇到单条样本的维度错误,应明确需要补齐的是样本轴,而不是仅仅让数组变成二维。