
机器学习与深度学习 / 系统课时
理解分类决策边界
理解分类决策边界
本课通过二维特征空间和具体分类算例,解释模型如何划分不同类别的预测区域。完成后,你能够区分线性与非线性决策边界,判断样本为什么被分到某一类,并理解边界附近的预测为什么容易变化。
学习目标
- 理解特征空间、预测区域与决策边界的关系
- 区分线性和非线性边界,掌握基本判断方法
- 识别边界附近样本的不确定性及常见误分类原因
决策边界的本质
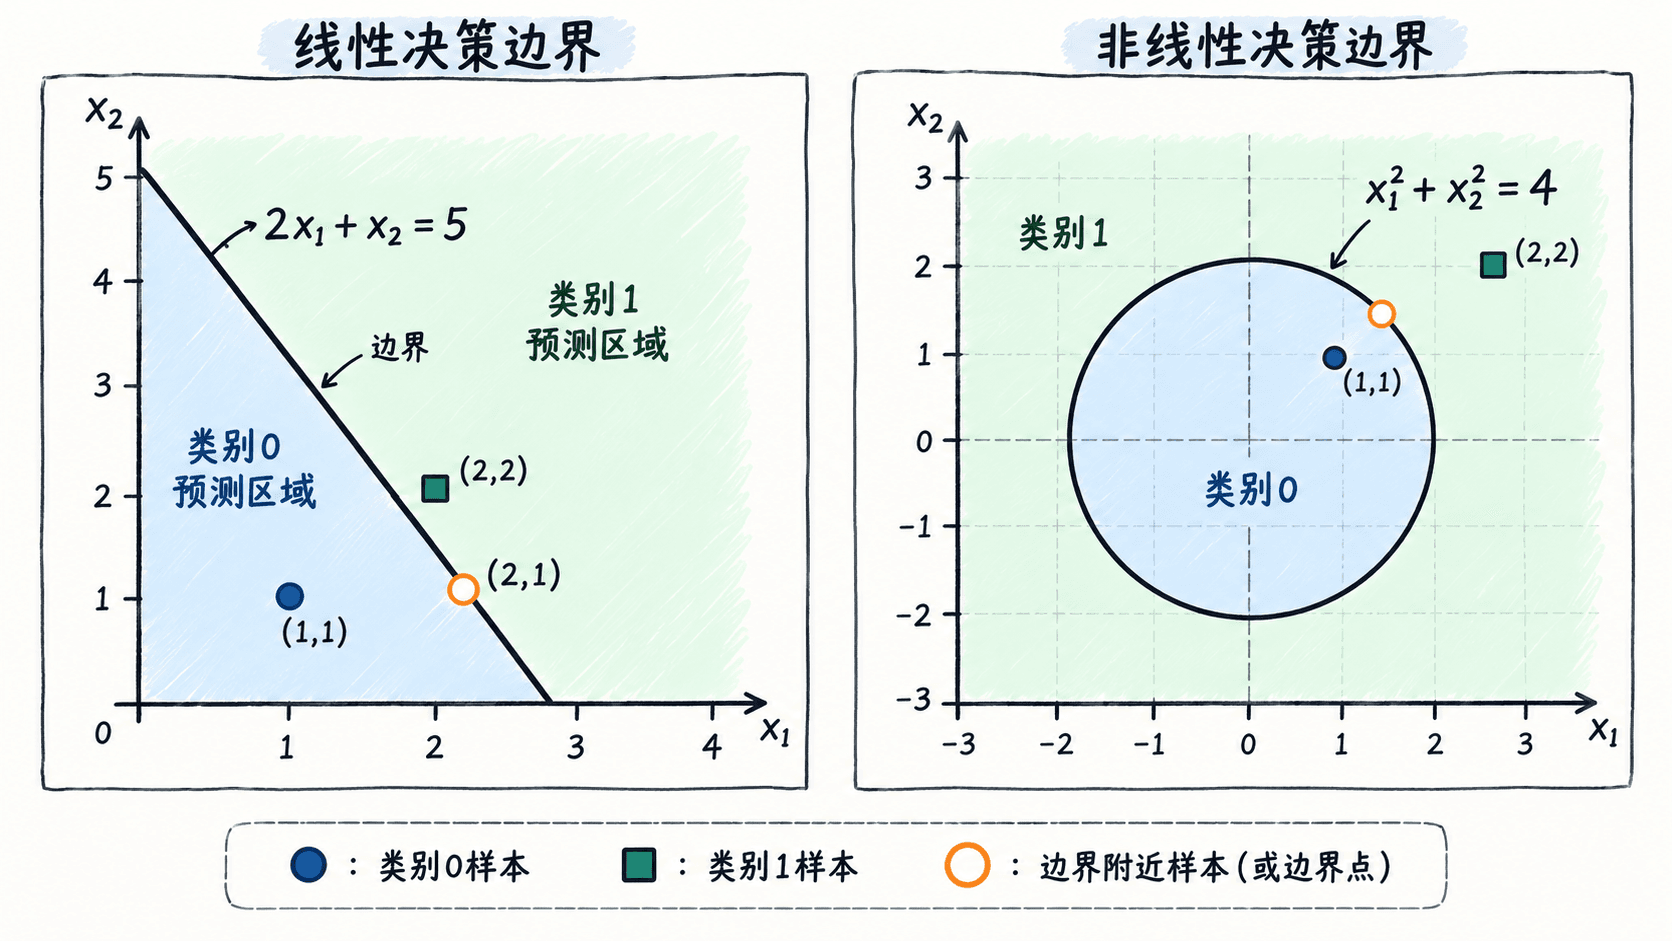
分类模型把特征空间划分为不同预测区域。二维数据中的边界是一条线或曲线;更高维数据中的边界是超平面或更复杂的曲面。决策边界表示模型预测类别发生切换的位置,并不要求边界上一定存在训练样本。
以两个特征 、 为例,假设模型使用以下线性得分函数:
规定得分 不小于 0 时预测为类别 1,否则预测为类别 0。令 ,得到决策边界:
将不同样本代入,可以直接验证预测结果:
| 样本 | 得分 | 预测类别 |
|---|---|---|
| (1, 1) | -2 | 类别 0 |
| (2, 2) | 1 | 类别 1 |
| (2, 1) | 0 | 类别 1,恰在边界上 |
这条直线将二维平面划为两个预测区域。同一区域内的点具有相同预测类别,但实际标签可能不同,因此分类边界不等于真实类别之间绝对正确的分界线。
线性与非线性边界
线性模型使用直线或超平面完成分隔,形式简单且容易解释。例如上面的 ,只要知道两个特征的数值,就能判断样本位于边界的哪一侧。
但圆环、棋盘等复杂分布无法由单条直线分开。例如,以原点为中心、半径为 2 的圆形边界可以写成:
如果规定圆内为类别 0、圆外为类别 1,那么 (1, 1) 位于圆内,(2, 2) 位于圆外。这样的边界在原始二维特征空间中是非线性的,需要非线性特征变换或非线性模型才能表达。
边界附近的样本
模型得分接近决策阈值的样本通常位于边界附近,对特征扰动更敏感。仍以上面的线性规则为例,固定 ,比较两个相邻样本:
- 当 时,,预测为类别 0。
- 当 时,,预测为类别 1。
仅改变第一个特征 0.2,预测类别就发生翻转。因此,当样本受到测量误差、数据噪声或轻微扰动影响时,边界附近更容易出现预测不稳定的情况。
需要区分靠近边界与概率不确定性。对于二分类概率模型,如果阈值是 0.5,那么预测概率接近 0.5 的样本通常靠近决策边界;但未经校准的概率不一定准确反映实际出错概率。普通分类得分也不能直接当作概率解释。
分析误分类时,应优先区分边界附近错误和远离边界的错误。前者可能与类别重叠、噪声或阈值选择有关;后者则应进一步检查错误标签、遗漏特征、数据分布变化或模型表达能力不足。
如何检查决策边界
对于二维分类任务,可以把验证集样本叠加在预测区域图上,通过真实标签与预测区域是否一致来观察分类效果。
- 确定模型使用的特征和分类阈值,例如线性得分阈值为 0。
- 在特征范围内选取密集网格点,分别计算模型的预测类别,并为不同预测区域着色。
- 将验证集样本按真实类别绘制到同一坐标系,观察哪些点落入错误预测区域。
- 单独检查边界附近和远离边界的错误,判断问题来自边界位置、模型复杂度还是数据质量。
对本课的线性算例,还可以固定 ,依次检查 、、。按约定的阈值规则,预测应依次为类别 0、类别 1、类别 1,类别切换位置正好是 。
决策边界帮助我们解释模型如何分类以及哪些样本容易发生预测翻转。实际评估时,还应结合独立验证集上的分类指标与错误样本分析,而不能只凭边界图是否看起来整齐判断模型好坏。