
机器学习与深度学习 / 系统课时
使用支持向量机
使用支持向量机
本课使用六个二维样本训练线性支持向量机,寻找两类之间的最大间隔边界,并通过支持向量索引验证哪些点决定边界。最后用参数 C 与标准化说明模型如何处理间隔违反和特征尺度。
学习目标
- 理解最大间隔、间隔违反与支持向量的关系
- 训练线性 SVM 并读取支持向量数量及索引
- 解释
C和特征标准化对结果的影响
最大间隔与支持向量
支持向量机(SVM)不仅寻找分隔边界,还希望边界到两类样本的间隔尽可能大。在线性分类中,决策边界是 ,其中 是标准化后的特征;两条参考间隔线是 和 。
决定边界位置的样本称为支持向量。对软间隔 SVM,支持向量既可能落在间隔线上,也可能落在间隔内或被错分,不能简单理解为“所有预测错误的样本”。
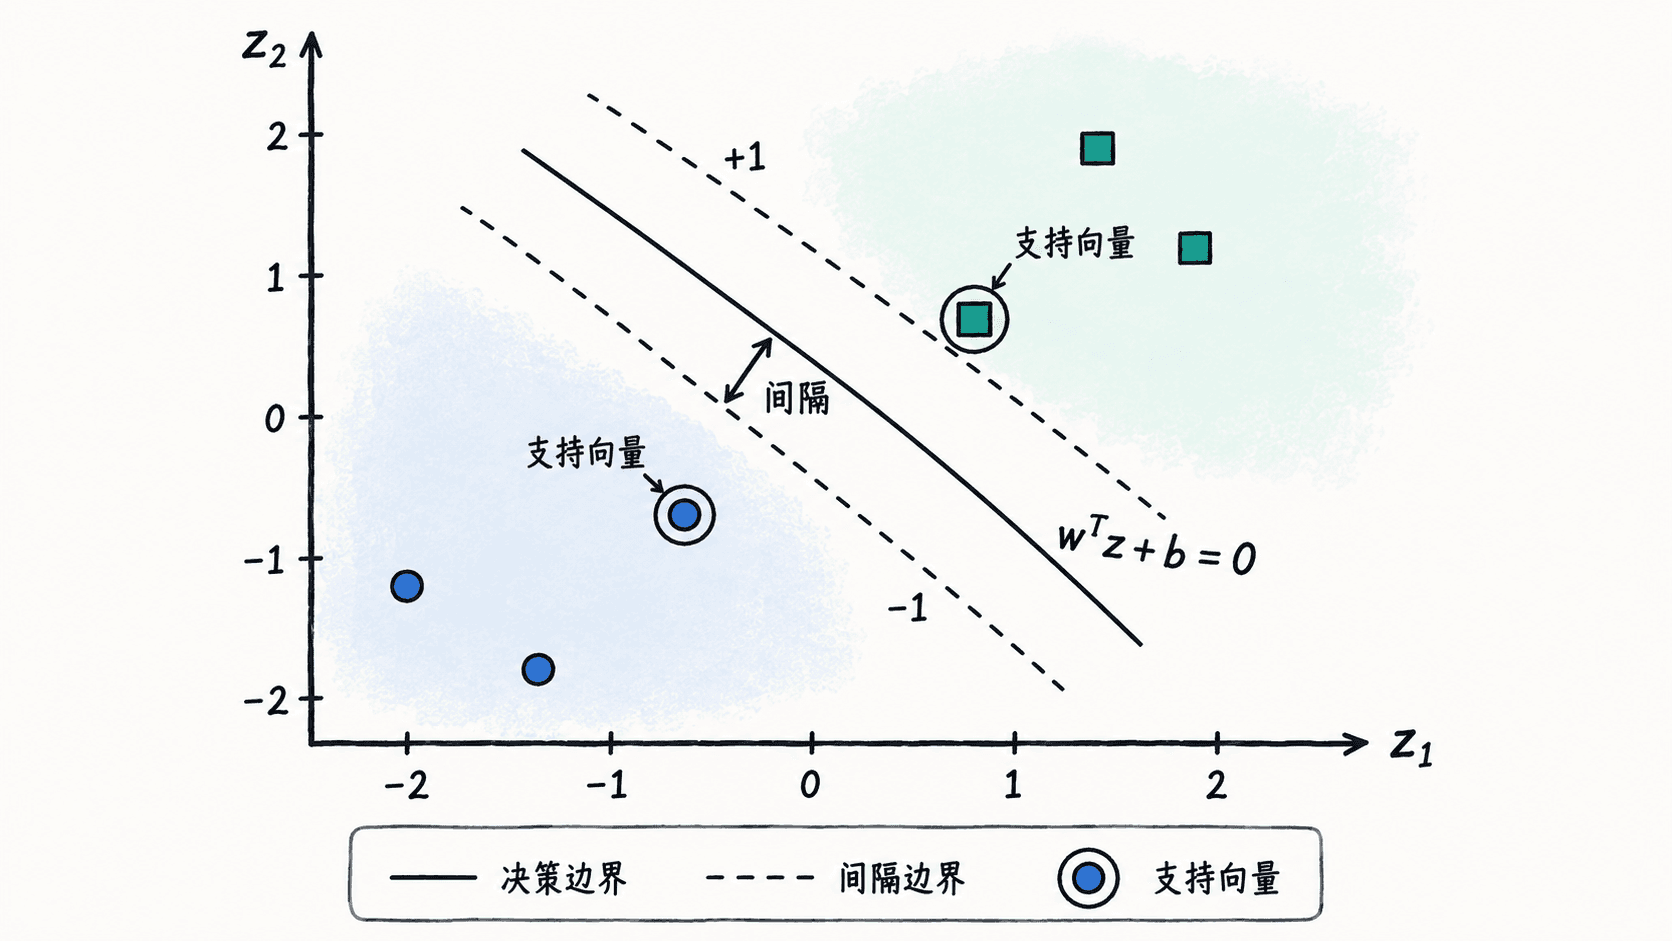
完整示例
将代码保存为 svm_demo.py。使用 Pipeline 把标准化和分类器串联,训练与预测都会采用相同的变换。
import numpy as np
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

x = np.array([
    [1.0, 1.0],
    [1.5, 1.0],
    [2.0, 1.5],
    [4.0, 4.0],
    [4.5, 4.0],
    [5.0, 4.5],
])
y = np.array([0, 0, 0, 1, 1, 1])

# 标准化只在 fit 时学习统计量,预测时复用
model = make_pipeline(
    StandardScaler(),
    SVC(kernel="linear", C=1.0),
)
model.fit(x, y)

# n_support_ 按类别记录支持向量数量
print("预测类别:", model.predict([[3.8, 3.5]])[0])
print("支持向量数量:", model.named_steps["svc"].n_support_.tolist())
print("支持向量索引:", model.named_steps["svc"].support_.tolist())
在安装 numpy 和 scikit-learn 的 Python 环境中运行:
python svm_demo.py预期输出:
预测类别: 1
支持向量数量: [1, 1]
支持向量索引: [2, 3]
下标从 0 开始,索引 2 和 3 对应 [2.0, 1.5] 与 [4.0, 4.0]。这两个样本最靠近分隔区域,因此在本次训练中共同约束了决策边界。模型将 [3.8, 3.5] 判为类别 1。
参数与尺度
C 控制对间隔违反的惩罚:值大时更倾向减少训练错误,可能牺牲间隔宽度;值小时容许更多间隔违反,正则化更强。可以尝试将 C=1.0 改为 0.1 或 10.0,重新运行并比较支持向量数量和预测,但不应只凭训练集是否全部分对来选参数。
SVM 对特征尺度敏感。例如一个特征在 0~1、另一个在 0~10000 时,未经缩放的距离与边界可能受大尺度特征主导。因此标准化应留在 Pipeline 中,并且仅用训练集拟合;不要在划分数据前对全量样本拟合标准化器。
默认的 SVC 不提供 predict_proba,只需类别时直接使用 predict。本例只有六条训练数据,验证的是 API、边界和支持向量的行为,不能由此声称模型在新数据上同样准确;实际项目应使用独立验证集选 C,最后再用测试集评估。