
机器学习与深度学习 / 系统课时
理解均值与方差
理解均值与方差
均值可以快速概括一组数据的整体水平,但均值相同的数据可能具有完全不同的波动程度。本课使用 NumPy 计算均值、方差和标准差,通过两组成绩数据比较离散程度,并观察异常值如何影响统计结果。
学习目标
- 使用均值描述数据中心位置
- 使用方差和标准差描述数据离散程度,区分总体与样本方差
- 识别均值容易受到异常值影响的情况
三个统计量分别回答什么
均值回答“数据整体位于什么水平”;方差回答“数据偏离均值的程度有多大”;标准差是方差的平方根,与原始数据使用相同单位,更容易解释。
均值是所有数据之和除以数据个数。方差先计算每个数据与均值的差,再将差值平方并求平均。平方可以避免正负偏差相互抵消,也会让较大的偏差产生更明显的影响。
例如,成绩 [60, 70, 75, 80, 90] 的均值为 75,各成绩相对均值的偏差分别为 -15、-5、0、5、15。
偏差平方和为 ,总体方差为 ,总体标准差为 。这意味着成绩相对均值的总体标准差为 10 分,而方差的单位是分数单位的平方。
总体方差使用所有数据与总体均值计算,分母为 。当数据只是从总体抽取的样本、目的是估计总体方差时,样本方差通常使用 作为分母,以修正直接使用 带来的系统性低估。
使用 NumPy 计算
安装 NumPy 后,可以直接使用数组的 mean()、var() 和 std() 方法。下面同时计算总体和样本统计量。
import numpy as np

scores = np.array([60, 70, 75, 80, 90], dtype=float)

# 默认 ddof=0,按总体数据计算
print(f"均值: {scores.mean():.2f}")
print(f"总体方差: {scores.var():.2f}")
print(f"总体标准差: {scores.std():.2f}")

# ddof=1:样本方差使用 n - 1 作为分母
print(f"样本方差: {scores.var(ddof=1):.2f}")
预期输出:
均值: 75.00
总体方差: 100.00
总体标准差: 10.00
样本方差: 125.00
总体方差为 100,样本方差为 125,两者使用相同的偏差平方和,但分母分别是 5 和 4。
如果这五个成绩就是需要分析的全部数据,可以使用总体方差;如果它们是从更多学生中随机抽取的样本,希望据此估计总体方差,则通常使用样本方差。
注意,标准差为 10 并不表示每个成绩都距离均值恰好 10 分,也不能保证所有成绩都处在均值上下 10 分的范围内。
相同均值不代表相同分布
只比较均值可能掩盖数据差异。下面构造两组均值都是 75、但离散程度明显不同的成绩。
import numpy as np

group_a = np.array([68, 72, 75, 78, 82])
group_b = np.array([40, 60, 75, 90, 110])

# 两组数据围绕相同的中心位置分布
# 使用默认 ddof=0 比较总体标准差
for name, values in [("A", group_a), ("B", group_b)]:
    print(
        f"{name} 组: 均值={values.mean():.1f}, "
        f"标准差={values.std():.1f}"
    )
预期输出:
A 组: 均值=75.0, 标准差=4.8
B 组: 均值=75.0, 标准差=24.1
两组均值相同,但 B 组的标准差约为 A 组的 5 倍。A 组数据集中在 75 附近,B 组则分散在更大的范围内。
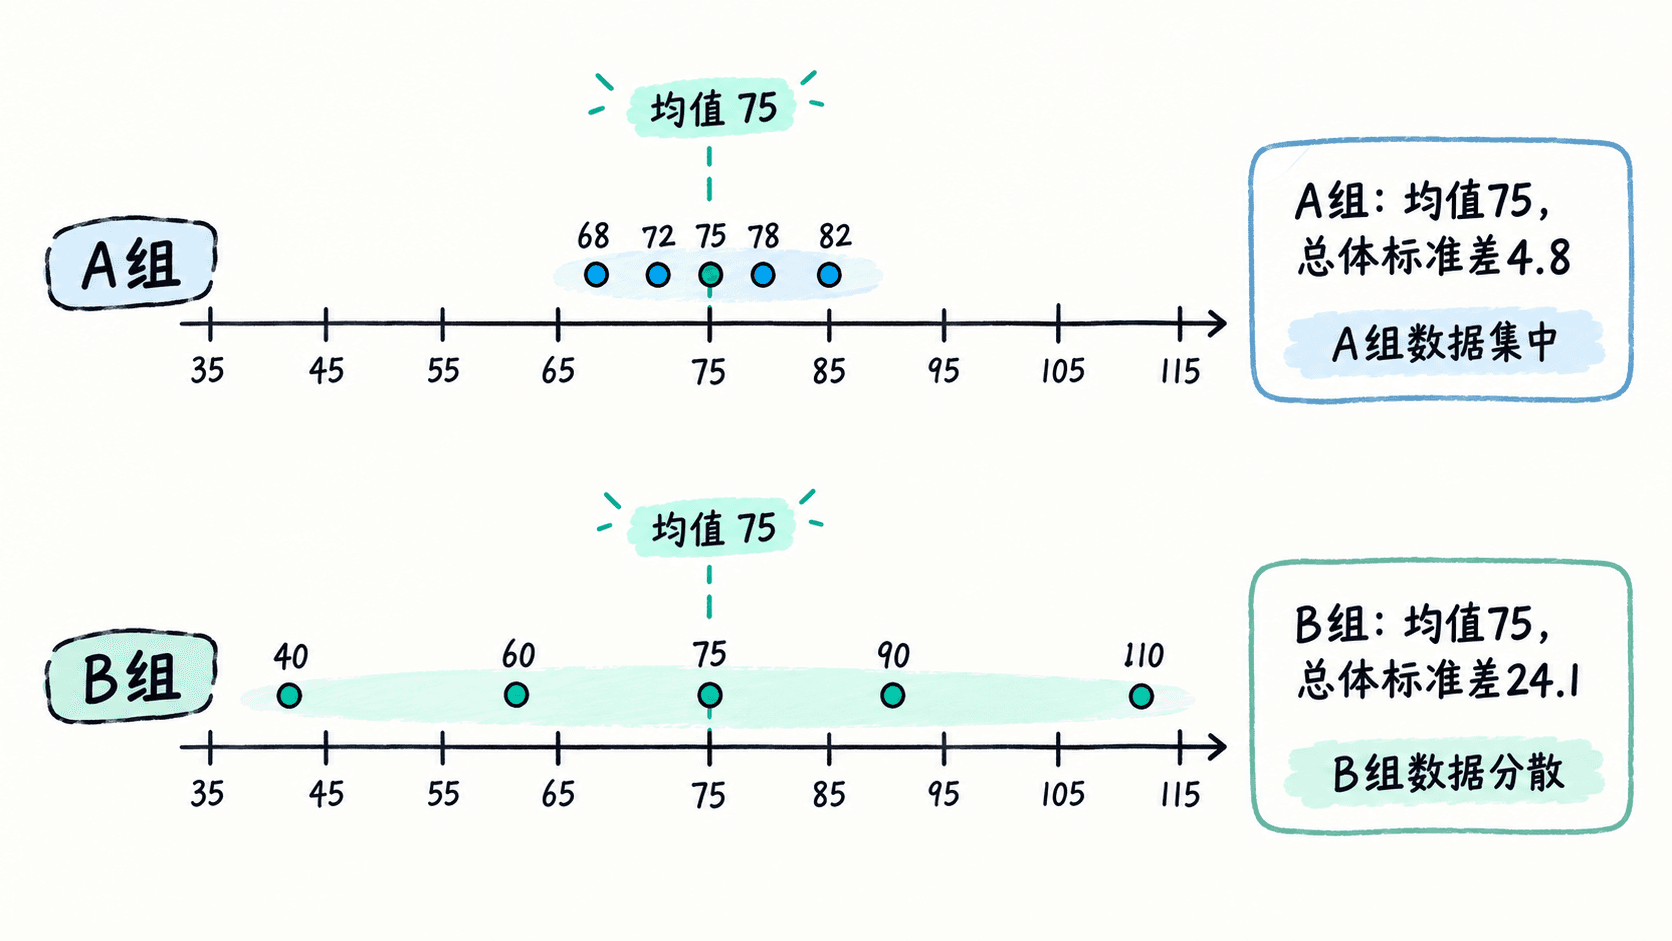
标准差适合衡量数据围绕均值的典型波动程度,但不能单独说明数据是否对称、是否存在多个集中区域。标准差较大也不一定意味着数据有错误,只表示观测值更加分散。
在机器学习的数据探索阶段,可以同时检查特征的均值和标准差。如果两个特征量纲不同,例如年龄与年收入,不能直接根据标准差的数值大小判断哪个特征相对波动更明显。
异常值对均值的影响
收入、交易金额等数据常包含极端值。此时均值会被少数大值拉高,应同时查看中位数、分位数和箱线图。
例如,五个人的收入(单位:万元)为 [5, 6, 7, 8, 9],均值和中位数都是 7 万元。
如果增加一位收入为 100 万元的人,六个人的收入总和变为 135 万元,均值上升到 22.5 万元,而中位数只上升到 7.5 万元。
这说明均值对极端值较敏感,而中位数主要由排序后的中间位置决定,不容易被单个极端值大幅拉动。方差和标准差同样会受到极端值影响,因为较大的偏差在平方后会产生更大权重。
判断标准:如果均值与中位数差距明显,或者最大值远高于上四分位数,应检查偏态分布和异常值,而不是只报告均值。
练习与验证
- 计算数据
[2, 4, 4, 4, 5, 5, 7, 9]的均值和总体标准差,再用 NumPy 验证。正确结果分别为 5 和 2。尝试将ddof改为 1,观察样本标准差的变化。 - 构造两组均值相同但方差不同的数据,再向其中一组加入一个极端值,比较加入前后的均值、中位数和标准差,解释哪些统计量变化最明显。
实际分析数据时,先使用均值了解整体水平,再使用标准差观察离散程度;遇到明显偏态或极端值时,结合中位数和分位数判断,避免仅凭均值描述数据。