
机器学习与深度学习 / 系统课时
使用朴素贝叶斯分类
使用朴素贝叶斯分类
本课解决如何依据类别先验和特征出现频率快速判断文本类别的问题。完成后,你可以用两个关键词的计数训练朴素贝叶斯模型,并核对输出概率与最终分类是否一致。
学习目标
- 理解先验概率和条件概率在分类中的作用
- 使用计数特征训练并验证分类器
- 认识特征独立假设和概率输出的限制
朴素假设与概率计算
模型根据类别先验和特征在各类别下出现的概率计算结果,并假设给定类别后各特征相互独立。该假设常不完全成立,但在文本等高维稀疏数据中仍可形成有效基线。
对计数特征,MultinomialNB 将每个词的出现次数计入类别分数:。其中 是类别先验, 是第 个词的出现次数;各类别分数归一化后得到预测概率。
训练时的 alpha=1.0 表示拉普拉斯平滑:每个词频加 1,避免未出现的词得到零条件概率。新文本只参与预测,不应混入训练统计。
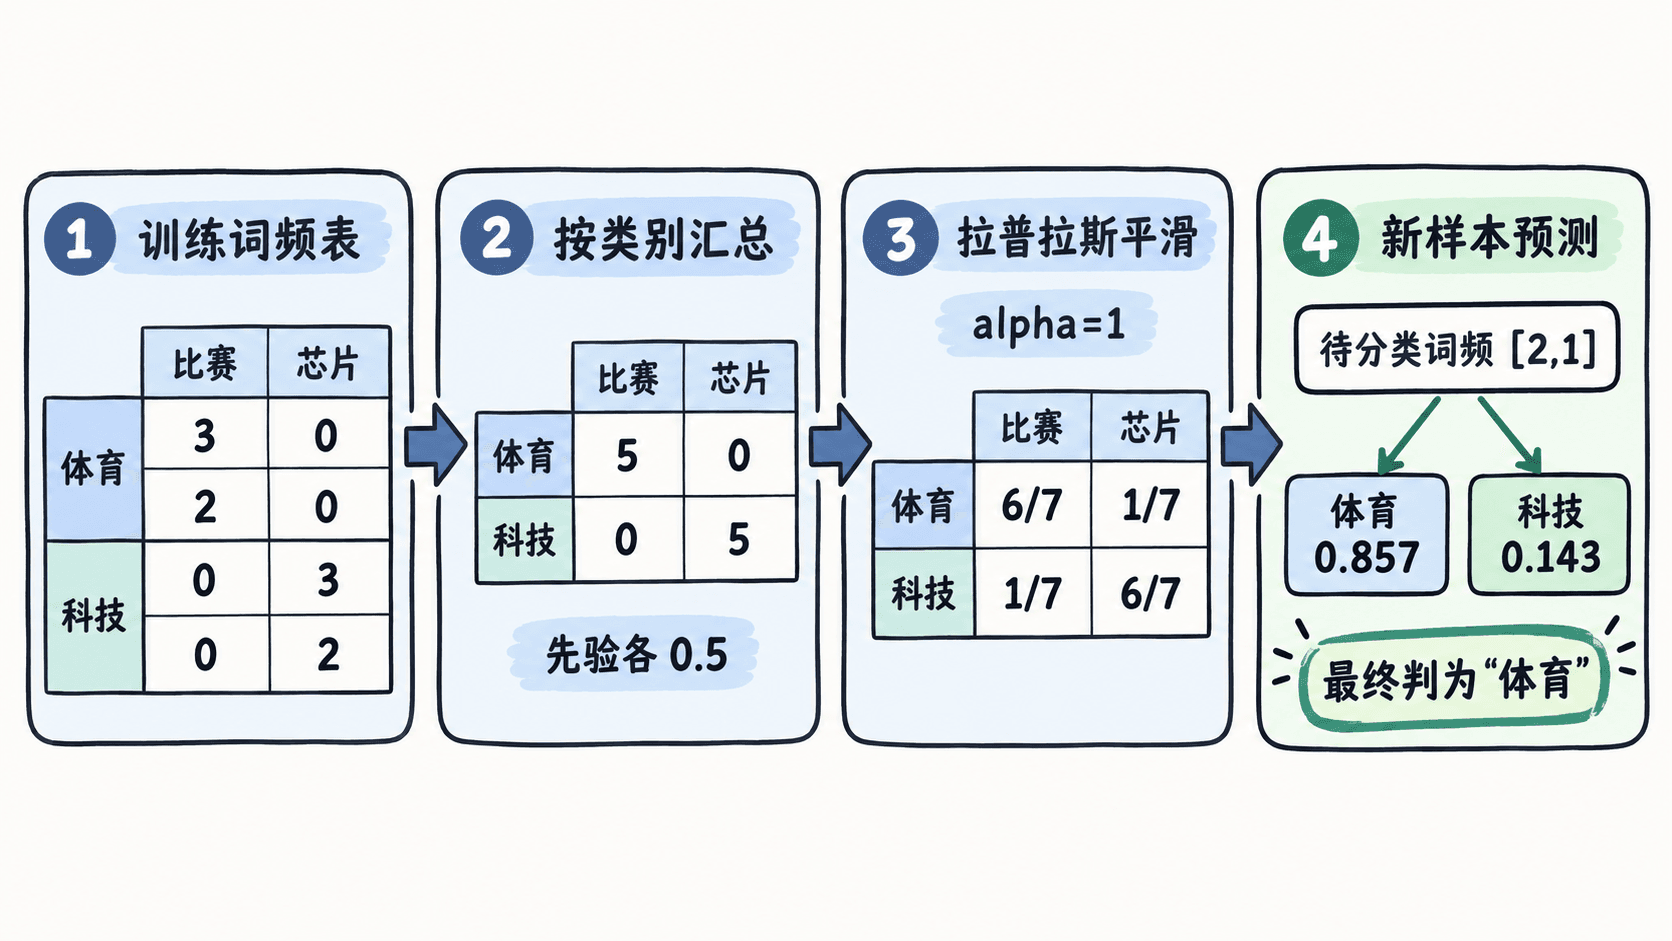
完整示例
下面用“比赛”和“芯片”的出现次数区分体育与科技文本。每行的两列依次代表这两个词的频次。安装 numpy 与 scikit-learn 后,将代码保存为 naive_bayes_demo.py。
import numpy as np
from sklearn.naive_bayes import MultinomialNB

# 两列依次是“比赛”和“芯片”的出现次数
x = np.array([
    [3, 0],
    [2, 0],
    [0, 3],
    [0, 2],
], dtype=float)
y = np.array(["体育", "体育", "科技", "科技"])

# 加一平滑,避免训练集中零词频带来零概率
model = MultinomialNB(alpha=1.0)
model.fit(x, y)

# 新文本中“比赛”出现 2 次,“芯片”出现 1 次
sample = np.array([[2, 1]], dtype=float)

print("预测概率:", np.round(model.predict_proba(sample)[0], 3))
print("预测类别:", model.predict(sample)[0])
运行命令:
python naive_bayes_demo.py预期输出:
预测概率: [0.857 0.143]
预测类别: 体育
概率核对与验证
两类各有 2 条训练文本,所以先验均为 0.5。体育类的词频合计为 [5,0],科技类为 [0,5]。加一平滑后,体育类中“比赛”“芯片”的条件概率分别为 、,科技类则相反。
对于新样本 [2,1],体育与科技的未归一化分数分别为 和 ,比值为 ,因此预测概率约为 0.857 和 0.143。predict_proba 的列顺序以 model.classes_ 为准,不能自行假定对应关系。
模型选择与边界
MultinomialNB 适合非负计数,GaussianNB 常用于连续数值,BernoulliNB 适合是否出现等二元特征。朴素贝叶斯训练和预测速度快,但相关特征会使独立假设偏离现实,输出概率也未必校准良好。
计数特征不能包含负值;如果输入是 TF-IDF 等非负权重,MultinomialNB 也常作为实用基线,但其严格的词频生成解释不再完全适用。实际评估还应使用独立测试集,不能只看这条训练示例的预测。