
机器学习与深度学习 / 系统课时
可视化降维结果
可视化降维结果
学习目标
- 使用 PCA 将高维数据映射到二维
- 按类别或簇绘制散点图
- 避免从二维投影得出过度结论
二维图能回答什么
降维散点图可以帮助观察样本是否形成明显群体、类别是否大量重叠、是否存在异常点。每个点代表一个样本,横纵轴是两个降维坐标。
图形只是高维结构的投影。二维中重叠的样本在更高维空间仍可能可分,二维中分开的群体也可能由投影方法夸大。
绘制 PCA 二维结果
python
import matplotlib.pyplot as plt
from sklearn.datasets import load_wine
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

data = load_wine()
X_scaled = StandardScaler().fit_transform(data.data)
X_2d = PCA(n_components=2).fit_transform(X_scaled)

for class_id, class_name in enumerate(data.target_names):
    mask = data.target == class_id
    plt.scatter(
        X_2d[mask, 0],
        X_2d[mask, 1],
        label=class_name,
        alpha=0.7,
    )

plt.xlabel("第一主成分")
plt.ylabel("第二主成分")
plt.legend()
plt.tight_layout()
plt.show()
预期结果:
text
程序弹出二维散点图。
三个葡萄酒类别会呈现一定分离,同时仍可能存在局部重叠。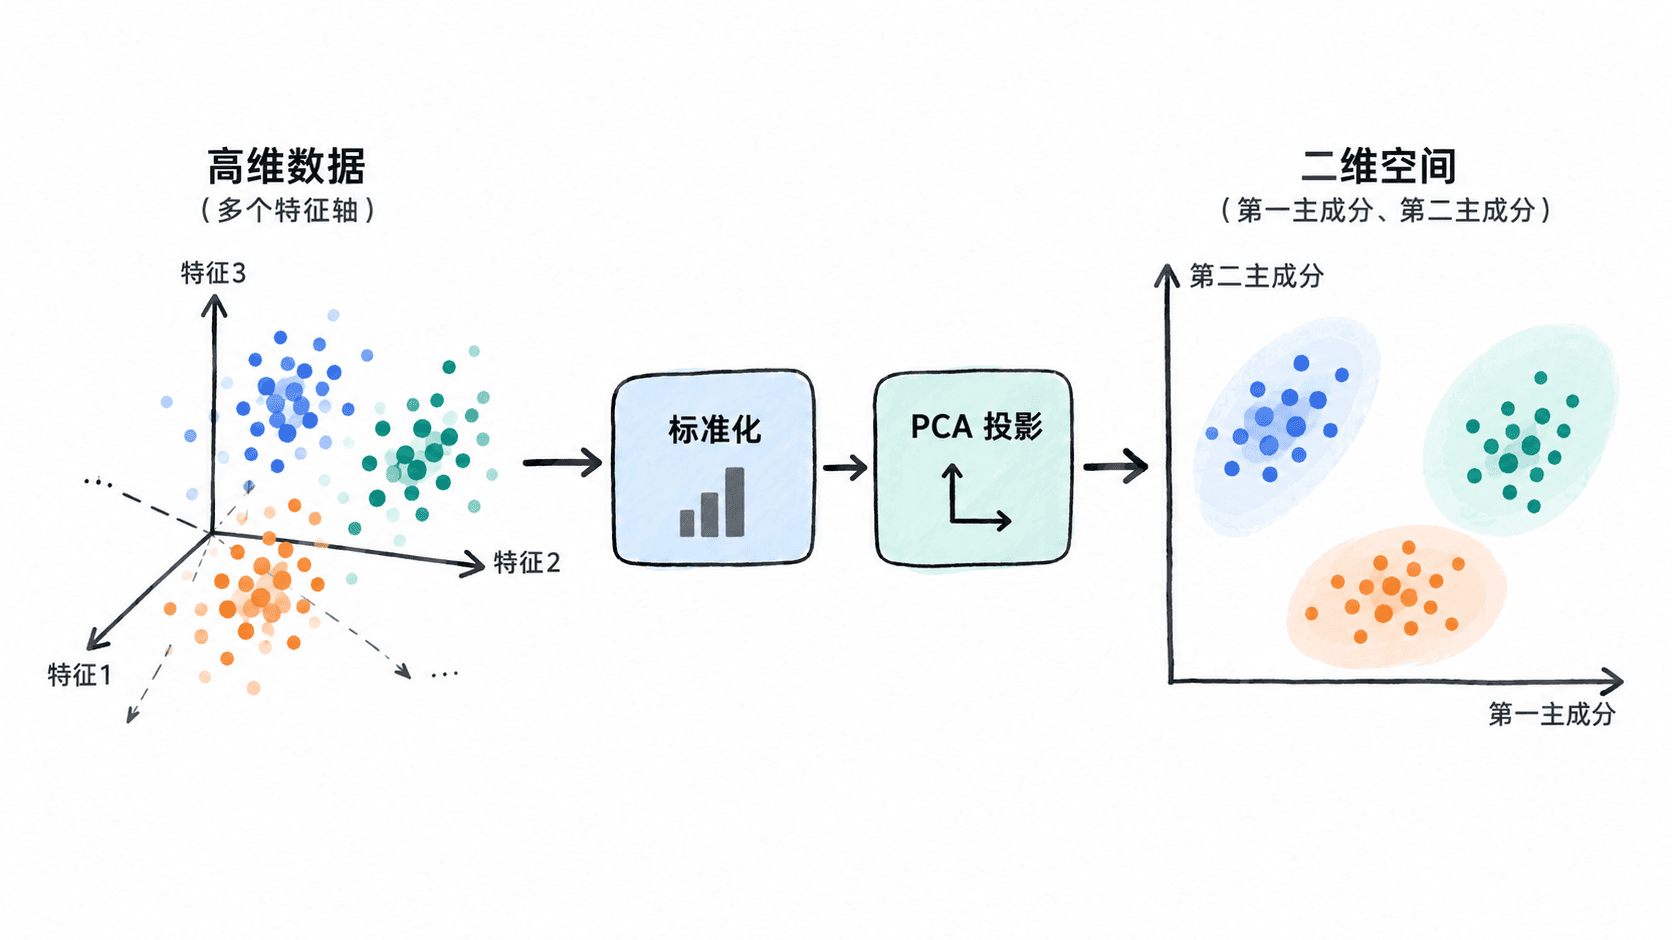
解释图形的三个步骤
先报告前两个主成分解释的方差比例,说明二维图保留了多少总体变化。再观察群体中心、重叠区域和异常点。最后回到原始特征或主成分载荷解释差异来源。
不能仅凭点的视觉距离断言业务因果,也不能把二维可分直接当作分类模型准确率。
避免数据泄漏
若图用于展示训练和测试样本,应只在训练集上拟合缩放器与 PCA,再分别转换两部分数据。先用全量数据拟合会把测试集分布带入投影方向,虽然影响可能不大,仍破坏严格评估边界。
t-SNE、UMAP 等非线性方法更适合局部结构探索,但图形对参数和随机种子敏感,不能用视觉效果替代量化评估。
按自己的节奏,确认真正理解。