
机器学习与深度学习 / 系统课时
分析回归残差
分析回归残差
本课解决总体误差指标看似正常、模型却在特定区间持续出错的问题。通过计算残差、观察残差图和回查高误差样本,你将能够识别线性关系不足、异常样本和误差波动不稳定等问题,并判断下一步该如何改进模型。
学习目标
- 计算每条样本的残差,理解正负号与误差大小
- 识别残差图中的系统结构,判断可能的模型问题
- 定位高误差样本,回查原因并验证改进效果
残差如何解释
残差等于真实值减去预测值,记为 。正残差表示模型低估,负残差表示模型高估。例如,真实值为 300、预测值为 330,残差就是 -30,表示模型高估了 30。
残差保留了每条样本的误差信息,而 MAE、RMSE 等总体指标会把这些信息聚合成一个数。因此,即使两个模型的 MAE 相同,它们也可能具有完全不同的误差分布。
分析残差时,通常以预测值或某个重要特征为横轴,以残差为纵轴,并绘制残差为 0 的水平参考线。对于拟合合理且误差模式稳定的模型,残差通常围绕 0 散布,不应出现明显曲线、漏斗形或持续偏向一侧的群体。
完整示例
将代码保存为 residual_demo.py。示例包含四条真实值和预测值,计算每条残差、平均残差和最大绝对残差,并定位首先需要复核的样本。
import numpy as np

y_true = np.array([100, 200, 300, 400], dtype=float)
y_pred = np.array([110, 190, 330, 370], dtype=float)

residuals = y_true - y_pred

# 平均残差可能因正负抵消而接近 0,因此还要看最大绝对误差
print("残差:", residuals)
print("平均残差:", residuals.mean())
print("最大绝对残差:", np.abs(residuals).max())

# 出现并列最大绝对误差时,argmax 返回第一个索引
worst_idx = int(np.argmax(np.abs(residuals)))
print("首先复核的样本索引:", worst_idx)
运行环境需要安装 NumPy。在脚本所在目录执行:
python residual_demo.py预期输出:
残差: [-10.  10. -30.  30.]
平均残差: 0.0
最大绝对残差: 30.0
首先复核的样本索引: 2
手工验证第一条残差为 ,第三条为 。四条残差相加为 0,所以平均残差为 0,但最大绝对残差达到 30,平均绝对误差也达到 20。这说明正负误差可以互相抵消,不能只凭平均残差判断预测质量。
样本索引从 0 开始,索引 2 对应真实值 300、预测值 330。索引 3 的绝对残差同样为 30,也需要复核;argmax 只返回第一次出现最大值的位置。
常见残差模式与处理
残差图可以帮助判断误差是否包含模型没有学到的规律。以下四种模式是回归诊断中最常见的观察对象。
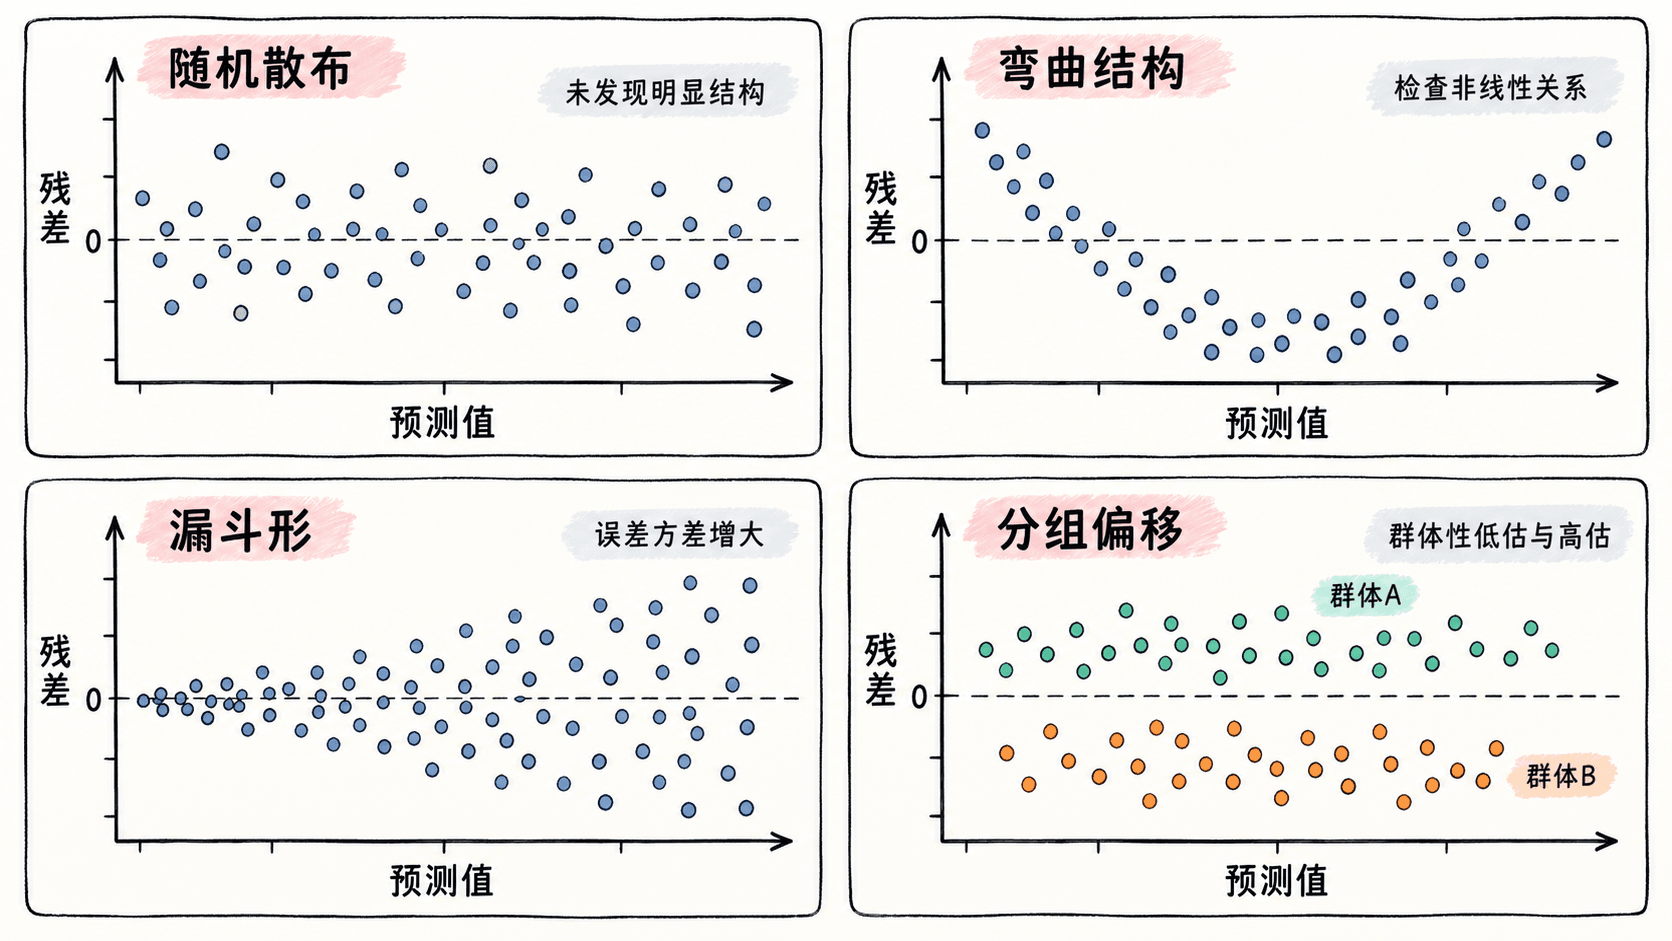
- 弯曲残差:残差随预测值或特征呈现 U 形等规律,通常说明当前线性形式未充分描述数据。可以检查遗漏特征、交互项或非线性变换。
- 漏斗形残差:预测值越大,残差分散程度越高,提示误差方差可能随预测范围变化。可以检查目标值尺度,并评估目标变换或适当的加权回归。
- 少量极端残差:个别样本远离多数点,应回查原始记录、标签、单位和特征值,确认是数据错误还是真实的罕见情况,不能直接删除。
- 分组偏移:某个群体的残差整体偏正或偏负,提示模型可能对该群体持续低估或高估。应按地区、设备类型或其他业务分组计算平均残差与 MAE,并同时检查样本数量。
定位问题与验证改进
实际排查时,优先使用模型未参与拟合的验证集残差。训练集残差可能因为模型已经记住训练样本而显得过于理想。
- 定位样本:按绝对残差从大到小排序,先查看误差最大的记录。对照原始特征、真实标签、预测值及数据采集时间,确认是否存在录入错误、单位混用或异常业务条件。
- 检查范围与分组:分别查看残差随预测值、时间和重要特征的变化,并按业务群体计算平均残差和 MAE。例如,若高价商品的残差分布明显更宽,就应重点检查高价区间的特征覆盖和目标尺度。
- 修改并重新验证:针对发现的问题补充合理特征、修正错误记录或调整模型形式。重新训练后,在相同的验证方案下比较 MAE、RMSE 和残差图,确认误差是否真正下降、系统结构是否减弱。
需要特别注意:残差为正负交错不等于模型一定正确,残差均值接近 0 也不等于预测准确。样本量很小时,图形模式还可能只是偶然波动;应结合更多验证样本和业务背景判断。
最终测试集应留到模型选择完成后再用于最终评估,避免反复根据测试集残差修改模型而造成评估信息泄漏。