
机器学习与深度学习 / 系统课时
训练逻辑回归模型
训练逻辑回归模型
本课解决如何从线性得分得到二分类概率的问题。通过一个只有单个特征的训练示例,你将使用 scikit-learn 训练逻辑回归模型,读取正类概率与预测类别,并理解决策阈值、模型系数和特征尺度对预测结果的影响。
学习目标
- 训练二分类逻辑回归模型,理解线性得分到概率的转换。
- 使用
predict_proba()和predict(),验证概率与预测类别的对应关系。 - 解释系数方向、特征尺度和决策阈值的影响。
从线性得分到概率
逻辑回归先计算特征的加权得分,再将其压缩到 0 到 1。对于单个特征,线性得分为 ,其中 是特征系数, 是截距。
随后通过 Sigmoid 函数转换为正类概率:
当 时,;当得分增大时,概率逐渐接近 1;得分减小时,概率逐渐接近 0。
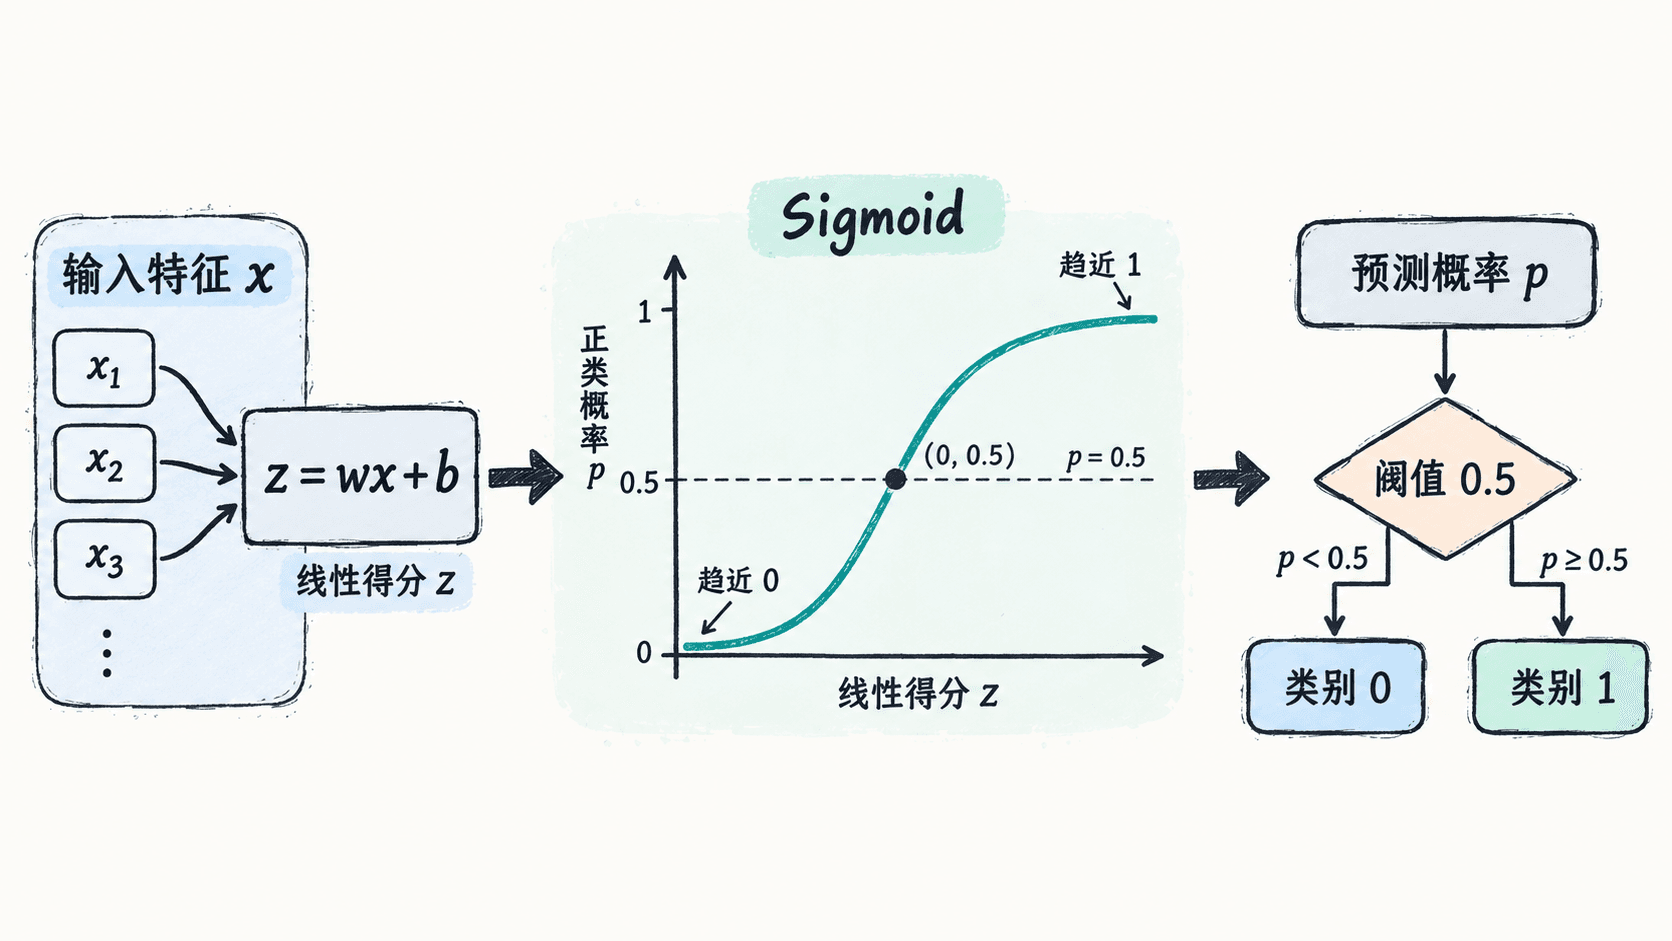
模型默认使用 0.5 作为二分类阈值:正类概率达到 0.5 时预测为类别 1,否则预测为类别 0。实际业务可以根据漏报与误报的成本调整阈值,但阈值改变不会重新训练模型。
训练并读取预测
使用六个训练样本构造二分类任务:特征值为 1、2、3 的样本属于类别 0,特征值为 4、5、6 的样本属于类别 1。模型需要学习特征大小与类别之间的关系。
运行示例需要 Python、NumPy 和 scikit-learn。将以下完整代码保存为 logistic_regression_demo.py。
import numpy as np
from sklearn.linear_model import LogisticRegression

x = np.array([[1], [2], [3], [4], [5], [6]], dtype=float)
y = np.array([0, 0, 0, 1, 1, 1])

model = LogisticRegression()
model.fit(x, y)

# predict_proba 的第二列对应正类概率
probability = model.predict_proba([[4.5]])[0, 1]

print(f"正类概率: {probability:.3f}")
print("预测类别:", model.predict([[4.5]])[0])
x 是形状为 (6, 1) 的二维特征矩阵,每行一个样本,每列一个特征。即使只使用一个特征,scikit-learn 也要求输入采用二维结构,因此预测时使用 [[4.5]],而不是 [4.5]。
fit() 根据训练数据学习系数与截距。predict_proba() 返回各类别的预测概率,predict() 则根据模型的分类规则输出最终类别。
在脚本所在目录运行:
python logistic_regression_demo.py预期输出:
正类概率: 0.754
预测类别: 1
这里的 0.754 是保留三位小数的结果,具体数值可能因 scikit-learn 版本及求解器数值细节而略有差异。
验证概率与预测类别
示例预测正类概率约为 0.754,高于默认阈值 0.5,所以最终预测类别为 1。概率输出和类别输出代表不同信息:前者提供模型对各类别的估计概率,后者是在阈值规则下得到的离散判断。
predict_proba() 的概率列与 model.classes_ 一一对应。本例的类别顺序为 [0, 1],因此 [0, 1] 索引位置表示第一条预测样本的第二个类别,即类别 1 的概率。若训练标签不是 0 和 1,不能直接认为第二列一定代表业务定义的正类。
可以通过以下检查理解阈值的作用:
- 使用默认阈值
0.5,概率0.754对应类别1。 - 假设业务改用阈值
0.8,同一概率0.754将被判为类别0。 - 检查预测类别是否符合阈值规则,注意调整阈值后应手动根据概率生成类别,不能继续把
predict()当作使用新阈值的结果。
例如在欺诈识别中,降低阈值通常能识别更多潜在风险样本,但也可能增加误报。阈值应在独立验证集上结合精确率、召回率和业务成本选择,而不是仅根据单个样本决定。
系数解释与限制
正系数表示在其他特征保持不变时,该特征增加会使正类倾向上升;负系数表示正类倾向下降。对于本例,特征值越大,模型预测类别 1 的概率通常越高。
系数描述的是对数几率的变化,并不表示特征每增加一个单位,预测概率就增加固定的百分点。由于 Sigmoid 曲线是非线性的,同样大小的得分变化,在概率接近 0.5 时和接近 0、1 时产生的概率变化不同。
系数大小还受特征尺度与正则化影响。多个特征量纲差异明显时,通常先标准化,再训练逻辑回归,避免直接比较未经统一尺度处理的系数绝对值。使用标准化时,应只在训练集拟合标准化参数,再将相同参数用于验证集和测试集。
此外,逻辑回归输出的数值虽然位于 0 到 1,但不代表概率天然校准准确。需要在独立数据上检查预测质量,必要时使用校准曲线或 Brier 分数评估概率可靠性。
本例仅用六条样本说明训练与预测接口,没有进行训练集、测试集划分,因此不能据此判断模型的泛化能力。真实任务应保留独立测试数据,同时评估分类结果和概率质量,避免把训练示例中的正常输出误认为模型已经达到可部署标准。