
机器学习与深度学习 / 系统课时
避免预处理数据泄漏
避免预处理数据泄漏
先用测试集计算缺失值填充值或标准化参数,会让离线评估提前获得测试信息,导致指标虚高。本课用 Pipeline 串联预处理与分类器,演示训练与预测的隔离方法,并检查交叉验证是否在每折重新拟合。
学习目标
- 识别先预处理、后划分造成的数据泄漏
- 使用 Pipeline 隔离训练阶段的拟合与测试阶段的预测
- 确保交叉验证和重采样不接触验证折数据
正确顺序
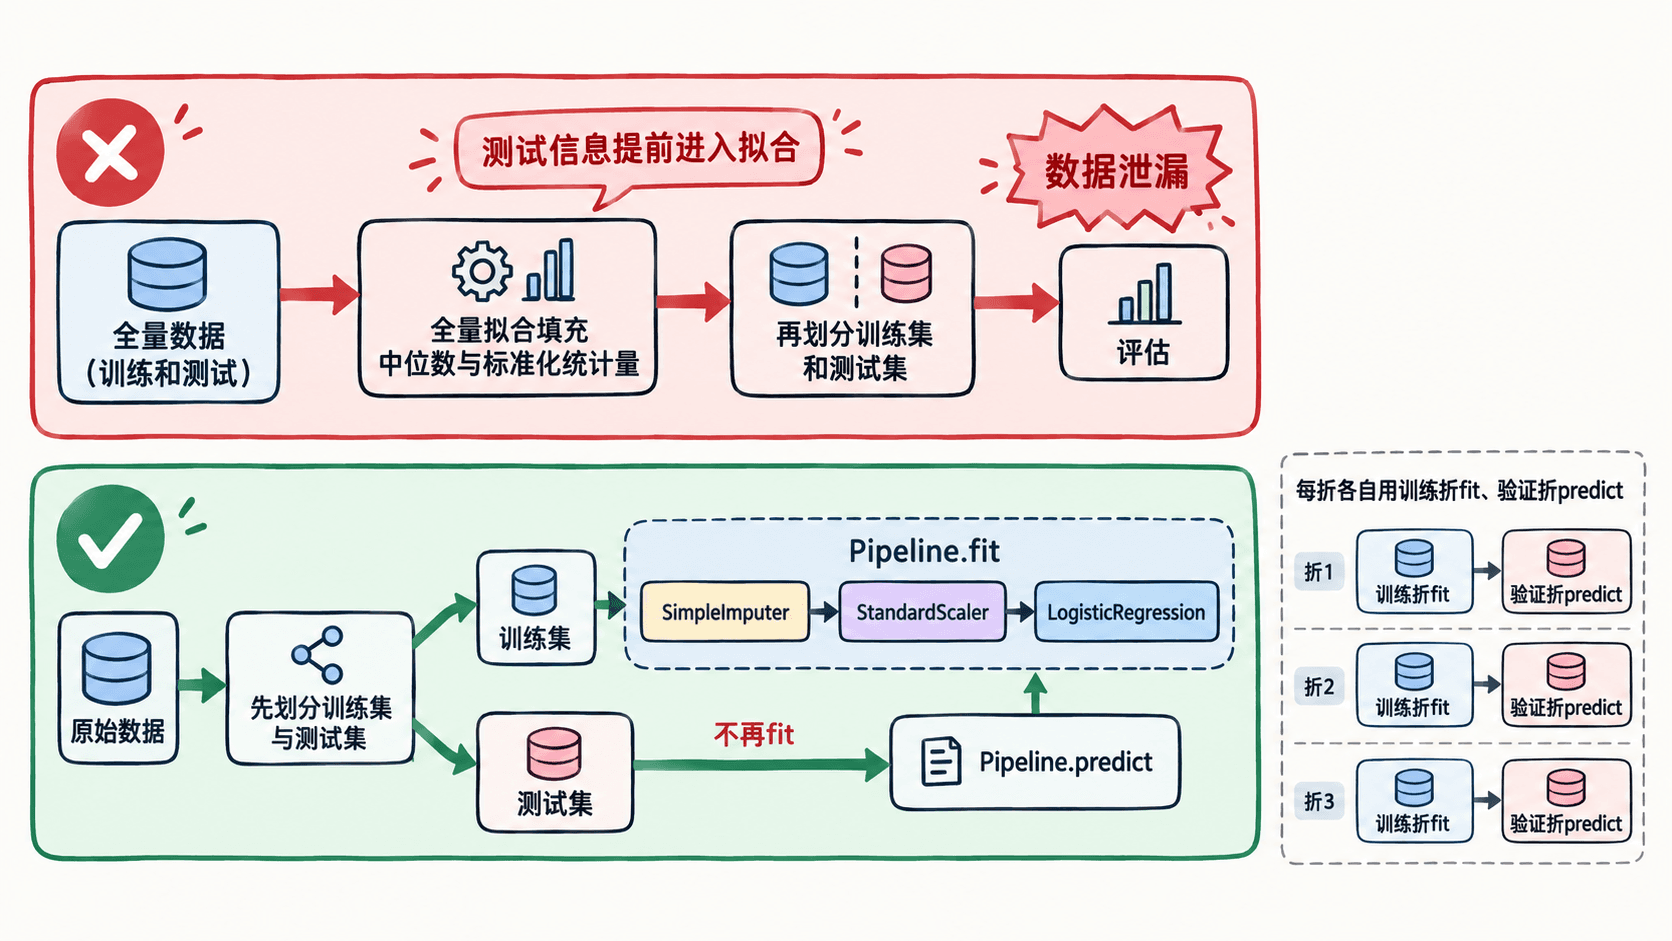
中位数、均值、标准差及特征选择结果,都是根据样本学习得到的信息。先对全量数据执行 fit 或 fit_transform,再划分训练集和测试集,会让测试集分布参与训练,即使没有使用测试标签,也可能使评估结果偏乐观。
正确顺序是先划分,再仅在训练集执行 fit;对测试集调用 transform 或 predict,沿用训练阶段保存的统计量,不能重新拟合。下图对比了两种数据流。
完整示例
使用 Pipeline 统一缺失填充、标准化和模型训练,避免漏掉某个步骤的拟合边界。将下面代码保存为 pipeline_demo.py;其中四行数据都属于训练集,待预测样本不参与统计量计算。
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

x_train = np.array([
    [20.0, 3000.0],
    [25.0, np.nan],
    [40.0, 9000.0],
    [45.0, 12000.0],
])
y_train = np.array([0, 0, 1, 1])

pipeline = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler()),
    ("model", LogisticRegression()),
])

# Pipeline 会按顺序拟合每个训练步骤
pipeline.fit(x_train, y_train)

print("预测类别:", pipeline.predict([[30.0, np.nan]])[0])
print("填充统计量:", pipeline.named_steps["imputer"].statistics_)

# 每折复制整条 Pipeline,仅使用该折的训练部分拟合
cv = StratifiedKFold(n_splits=2, shuffle=True, random_state=42)
scores = cross_val_score(pipeline, x_train, y_train, cv=cv)
print("各折准确率:", scores)
运行命令:
python pipeline_demo.py预期输出:
预测类别: 0
填充统计量: [  32.5 9000. ]
各折准确率: [1. 1.]
验证预处理没有越界
年龄列的训练值为 20、25、40、45,中位数是 32.5;收入列的非缺失值为 3000、9000、12000,中位数是 9000。输出中的填充统计量恰好来自训练数据,待预测样本的缺失值不会触发重新计算。即使后续输入收入为 100000 的新样本,statistics_ 也应保持不变。
predict 会依次使用已拟合的填充器和标准化器,再调用分类器预测。若对测试集另行执行 fit_transform,所得特征尺度可能与训练时不一致,同时造成信息泄漏。
交叉验证与重采样
cross_val_score 会为每一折复制整条 Pipeline,并仅对该折训练数据拟合填充器、标准化器及模型,再在验证折上评分。示例只有四条样本,两折准确率仅用于验证调用过程,不能据此判断模型真实效果。
特征选择、目标编码等涉及数据学习的操作,也应放进每折训练过程。若需要 SMOTE 等过采样,应使用 imblearn.pipeline.Pipeline,确保只对训练折重采样;不能先在全量数据上过采样后再划分或交叉验证。独立测试集应保持原始分布,留到方案确定后做最终评估。